Моніторинг GPU: сервер, з якого взято ці цифри.
Якщо в підписі не сказано інше, показники на цій сторінці отримано з однієї робочої станції: чотири RTX A4000 з однією моделлю на всіх, під навантаженням нашого власного тестового трафіку. Саме ці цифри показувала консоль, коли ми записували рис. 1 і 5. У тестах на вміщення нижче також використано Quadro RTX 5000, про що там сказано.
Панелі для кожної карти зчитують дані драйвера NVIDIA, тому вони є частиною інсталяції для Linux. На Mac з Apple silicon застосунок для Mac (бета-версія) показує використання GPU і бюджет пам’яті, який повідомляє Metal, без даних про потужність.
- GPU
- 4 × NVIDIA RTX A4000, по 16 ГіБ (Ampere, compute 8.6)
- Зайнято VRAM
- 59,4 з 64,0 ГіБ, одна модель на всіх чотирьох картах
- PCIe
- Gen 4 x16 на кожну карту
- Драйвер
610.57.04, CUDA 13.3
| Показник | На момент знімка | Медіана під навантаженням за 24 год | Пік за 24 год |
|---|---|---|---|
| Використання GPU, найзавантаженіша карта (%) | 100 | 100 | 100 |
| Потужність GPU, сума чотирьох карт (Вт) | 548 | 530 | 559 |
| Токени за хвилину (панель за 23 вер.) | не показано | 190 тис. | 880 тис. |
Ваші цифри будуть іншими. Саме для цього їх і варто вимірювати. Рядок токенів записано ще до переходу на токени за секунду; панель статистики тепер показує токени за секунду, а ці цифри взято зі знімка 23 вересня на старій панелі, яка показувала токени за хвилину.
Величина, яку неможливо виміряти, позначається як «not reported».
Більшість панелей моніторингу GPU усереднюють чотири карти в одну лінію й малюють відсутнє значення як 0. Тут кожна карта має власну панель: температура відносно точки тротлінгу, про яку повідомляє драйвер, потужність відносно власного ліміту карти, частоти, вентилятор, поточний узгоджений режим з’єднання PCIe, а також ECC і NVLink, якщо карта їх має. Дві карти, куплені з різницею у півтора року, лишаються двома картами, а значення, якого драйвер не надає, позначається як відсутнє, а не малюється нулем.
 Точка тротлінгу — від драйвера, а не здогадка
Чому знижено частоту, за даними драйвера
Потужність відносно власного ліміту 140 Вт
NVLink і ECC, як їх повідомляє карта
| Для кожної карти | Температура й точка тротлінгу, потужність і її ліміт, частоти ядра й пам’яті, вентилятор, покоління й ширина PCIe, ECC, NVLink і процес рушія, що використовує карту |
|---|---|
| Для хоста | Зайнята VRAM, використання GPU (найзавантаженіша карта), потужність (сума карт) і токени за секунду |
| Для запиту | Час до першого токена, затримка між токенами й тривалість, виміряні на проксі однаково для обох рушіїв |
На що чекає кожен запит.
Сторінка Stats показує кожен запит у роботі із сеансом клієнта й етапом, на якому він перебуває: у черзі LM Warden, prefill (рушій читає промпт), міркування, написання виклику інструмента чи відповідь. Значок показує, яка частка промпту, імовірно, є в кеші репліки. Якщо prefill триває довше, ніж передбачає вивчена для цього сервера швидкість prefill, видно ймовірну причину: запит чекає за іншими промптами на тій самій репліці, кеш, імовірно, витіснено, або запит повільний з причини, якої LM Warden не бачить. Сеанс визначається за ідентифікатором, який кожен інструмент уже надсилає: Claude Code, Codex, OpenCode і pi — одразу, Hermes і Aider — після одного рядка налаштування.
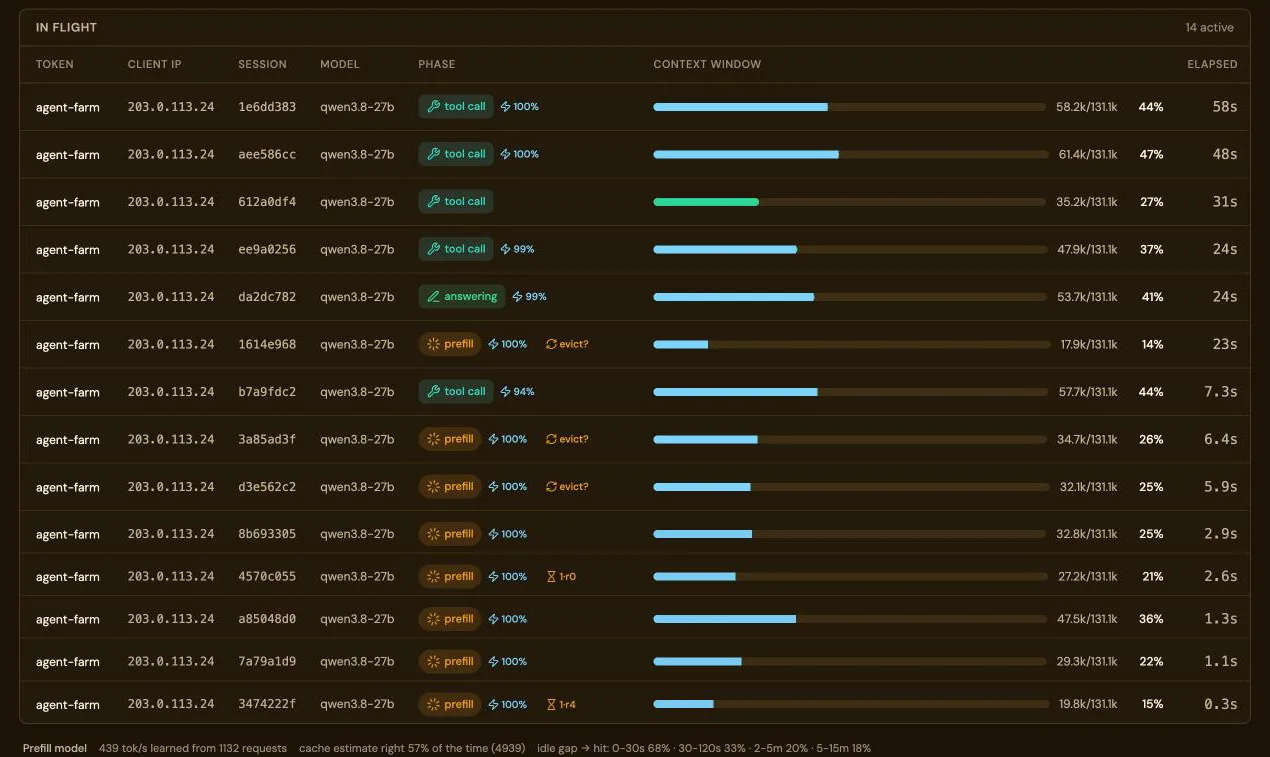 Токенів ще немає, кеш, імовірно, витіснено
Перед ним один промпт на репліці 4