GPU 监控:这些数据来自哪台主机。
除非图注另有说明,本页的读数都来自同一台工作站:四块 RTX A4000,一个模型跨全部四块卡加载,运行着我们自己的测试流量。这些是我们录制图 1 和图 5 时控制台显示的数字。下文的适配测试还用到了一块 Quadro RTX 5000,并会注明。
逐卡面板读取的是 NVIDIA 的驱动,因此属于 Linux 安装的一部分。在 Apple 芯片 Mac 上,Mac 应用(测试版)显示 GPU 使用率和 Metal 报告的内存预算,没有功耗读数。
- GPU
- 4 × NVIDIA RTX A4000,每块 16 GiB(Ampere,计算能力 8.6)
- 已用 VRAM
- 59.4/64.0 GiB,一个模型跨全部四块卡
- PCIe
- 每块卡 Gen 4 x16
- 驱动
610.57.04,CUDA 13.3
| 读数 | 截图时 | 24 h 繁忙时中位数 | 24 h 峰值 |
|---|---|---|---|
| GPU 利用率,最忙的一块卡 (%) | 100 | 100 | 100 |
| GPU 功耗,四块卡合计 (W) | 548 | 530 | 559 |
| 每分钟 token 数(9 月 23 日的面板) | 未显示 | 190k | 880k |
你的数字会不一样。这正是要测量它们的原因。token 这一行的数据来自改用每秒 token 数之前;统计面板现在绘制的是每秒 token 数,而这些数字来自 9 月 23 日在旧的每分钟面板上的截图。
测不到的数值会显示为“not reported”。
大多数 GPU 监控面板会把四块卡平均成一条线,并把缺失的值画成 0。这里则给每块卡一个自己的面板:温度对照驱动报告的降频温度,功耗对照该卡自身的功耗上限,频率、风扇、当前协商的 PCIe 链路,以及显卡具备时的 ECC 和 NVLink。相隔十八个月买的两块卡仍然是两块卡,驱动没有提供的值会标为缺失,而不是画成零。
 降频温度取自驱动,不是猜测
驱动报告的降频原因
功耗对照它自己的 140 W 上限
NVLink 和 ECC,以显卡报告为准
| 每块卡 | 温度和降频温度、功耗及其上限、核心和显存频率、风扇、PCIe 代数和宽度、ECC、NVLink,以及使用这块卡的引擎进程 |
|---|---|
| 每台主机 | 已用 VRAM、GPU 利用率(最忙的一块卡)、功耗(各卡之和)和每秒 token 数 |
| 每个请求 | 首 token 时间、token 间延迟和总耗时,在代理层测量,两种引擎采用相同方式 |
每个请求在等什么。
Stats 页面列出每个进行中的请求,附带客户端的会话以及请求所处的生命周期阶段:在 warden 排队、预填充(引擎读取提示词)、思考、编写工具调用或作答。一个徽标给出提示词中可能位于副本缓存里的比例。如果预填充耗时超过这台主机学到的预填充速率所预测的时间,会说明它可能在等什么:排在同一副本上的其他提示词后面、缓存可能已被逐出,或者变慢的原因 warden 无从判断。会话来自每个工具本来就会发送的 ID:Claude Code、Codex、OpenCode 和 pi 开箱即用,Hermes 和 Aider 只需一行设置。
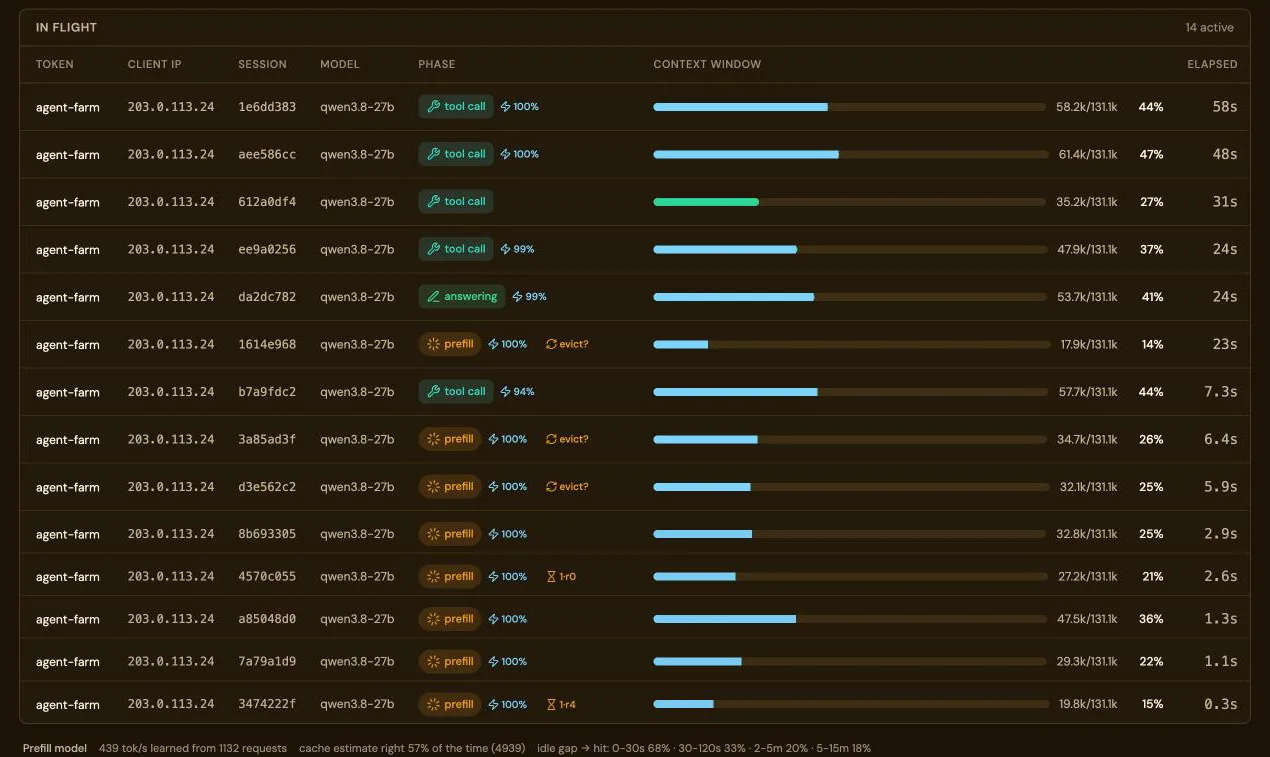 还没有 token,缓存可能已被逐出
副本 4 上有一个提示词排在它前面