Surveillance des GPU : la machine derrière ces chiffres.
Sauf mention contraire dans une légende, les relevés de cette page proviennent d’une seule station de travail : quatre RTX A4000, avec un seul modèle chargé sur l’ensemble, occupées par notre propre trafic de test. Ce sont les chiffres qu’affichait la console pendant l’enregistrement des fig. 1 et 5. Les tests de capacité présentés plus bas ont aussi utilisé une Quadro RTX 5000, et le précisent.
Les panneaux par carte lisent les données du pilote NVIDIA : ils font donc partie de l’installation Linux. Sur un Mac à puce Apple, l’app Mac (bêta) affiche l’utilisation du GPU et le budget mémoire indiqué par Metal, sans mesure de la consommation électrique.
- GPU
- 4 × NVIDIA RTX A4000, 16 Gio chacune (Ampere, compute 8.6)
- VRAM utilisée
- 59,4 sur 64,0 Gio, un seul modèle réparti sur les quatre cartes
- PCIe
- Gen 4 x16 par carte
- Pilote
610.57.04, CUDA 13.3
| Mesure | À la capture | Médiane sur 24 h d’activité | Pic sur 24 h |
|---|---|---|---|
| Utilisation GPU, carte la plus sollicitée (%) | 100 | 100 | 100 |
| Puissance GPU, somme des quatre cartes (W) | 548 | 530 | 559 |
| Jetons par minute (panneau du 23 sept.) | non affiché | 190 k | 880 k |
Vos chiffres seront différents : c’est tout l’intérêt de les mesurer. La ligne des jetons est antérieure au passage aux jetons par seconde ; le panneau Stats affiche désormais des jetons par seconde, et ces chiffres proviennent de la capture du 23 septembre, sur l’ancien panneau par minute.
Une valeur impossible à mesurer s’affiche « not reported ».
La plupart des tableaux de bord GPU fondent quatre cartes en une seule courbe moyenne et affichent une valeur manquante comme un 0. Celui-ci donne à chaque carte son propre panneau : la température face au seuil de bridage indiqué par son pilote, la puissance face à la limite propre à la carte, les fréquences, le ventilateur, le lien PCIe tel qu’il est négocié à cet instant, ainsi que l’ECC et le NVLink quand la carte en dispose. Deux cartes achetées à dix-huit mois d’écart restent deux cartes, et une valeur que le pilote ne fournit pas est signalée comme manquante au lieu d’être tracée à zéro.
 Seuil de bridage fourni par le pilote, pas une estimation
Pourquoi la fréquence baisse, selon le pilote
Puissance face à sa propre limite de 140 W
NVLink et ECC, tels que la carte les rapporte
| Par carte | Température et seuil de bridage, puissance et sa limite, fréquences du cœur et de la mémoire, ventilateur, génération et largeur PCIe, ECC, NVLink, et le processus du moteur qui utilise la carte |
|---|---|
| Par hôte | VRAM utilisée, utilisation du GPU (la carte la plus sollicitée), puissance (la somme des cartes) et jetons par seconde |
| Par requête | Délai avant le premier jeton, latence entre jetons et durée, mesurés au niveau du proxy de la même façon pour les deux moteurs |
Ce qu’attend chaque requête.
La page Stats liste chaque requête en cours avec la session du client et l’étape où elle en est : en file d’attente au warden, prefill (le moteur lit le prompt), réflexion, écriture d’un appel d’outil, ou réponse. Un badge indique la part du prompt probablement présente dans le cache du réplica. Lorsqu’un prefill dure plus longtemps que ne le prévoit le débit de prefill appris sur cette machine, la ligne indique la cause probable de l’attente : d’autres prompts devant lui sur le même réplica, un cache probablement évincé, ou une lenteur sans cause visible pour le warden. La session provient de l’ID que chaque outil envoie déjà : Claude Code, Codex, OpenCode et pi sans aucun réglage, Hermes et Aider avec une ligne de configuration.
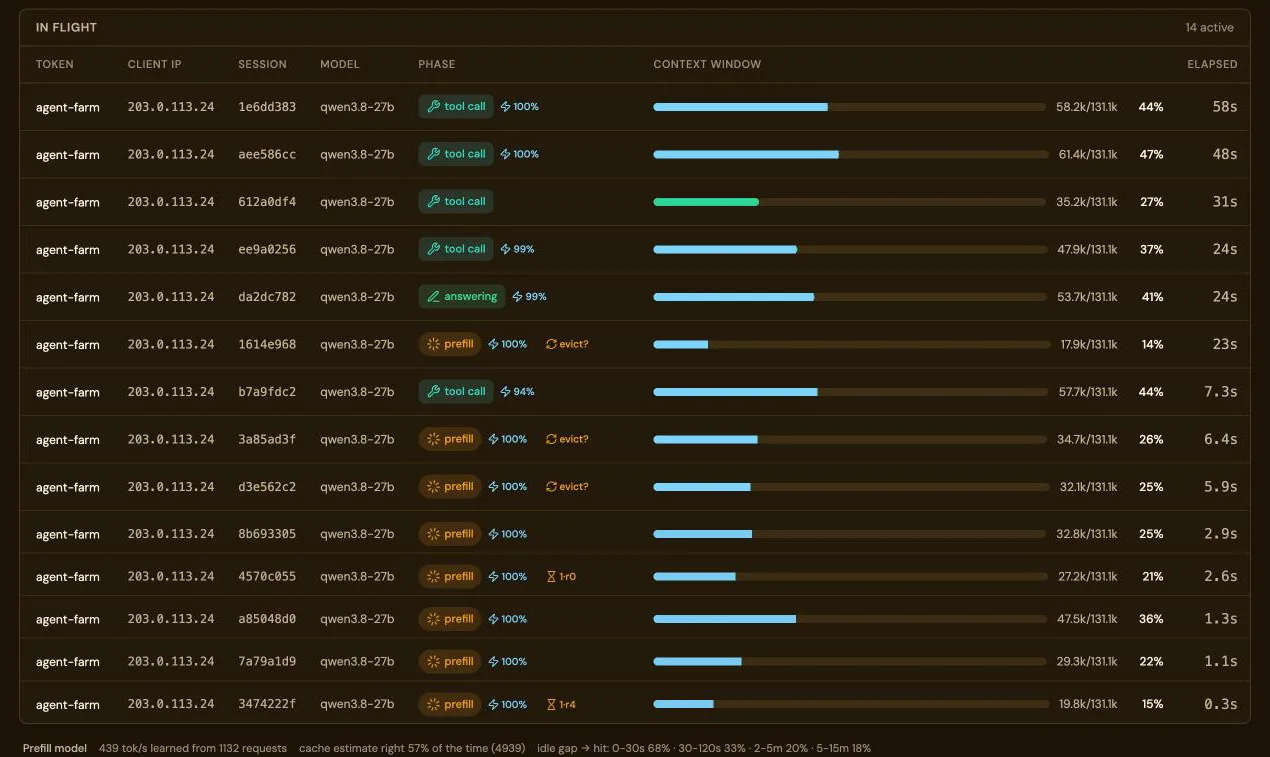 Pas encore de jeton, cache probablement évincé
Un prompt le précède sur le réplica 4