Supervisión de GPU: la máquina detrás de estas cifras.
Salvo que un pie de figura indique lo contrario, las lecturas de esta página proceden de una sola estación de trabajo: cuatro RTX A4000 con un único modelo cargado entre todas ellas y ocupadas con nuestro propio tráfico de prueba. Son las cifras que mostraba la consola cuando hicimos las capturas de las fig. 1 y 5. Las pruebas de capacidad (qué cabe en cada tarjeta) que aparecen más abajo también usaron una Quadro RTX 5000, y así se indica.
Los paneles por tarjeta leen el controlador de NVIDIA, así que forman parte de la instalación de Linux. En un Mac con chip de Apple, la app para Mac (beta) muestra el uso de la GPU y el presupuesto de memoria que indica Metal, sin lectura de potencia.
- GPU
- 4 × NVIDIA RTX A4000, 16 GiB cada una (Ampere, compute 8.6)
- VRAM en uso
- 59,4 de 64,0 GiB, un modelo repartido entre las cuatro tarjetas
- PCIe
- Gen 4 x16 por tarjeta
- Controlador
610.57.04, CUDA 13.3
| Lectura | En la captura | Mediana en carga (24 h) | Pico de 24 h |
|---|---|---|---|
| Uso de GPU, tarjeta más ocupada (%) | 100 | 100 | 100 |
| Potencia de GPU, suma de las cuatro tarjetas (W) | 548 | 530 | 559 |
| Tokens por minuto (panel del 23 de septiembre) | no se muestra | 190 mil | 880 mil |
Tus cifras serán distintas; para eso se miden. La fila de tokens es anterior al cambio a tokens por segundo: el panel de estadísticas ahora representa tokens por segundo, y estas cifras son de la captura del 23 de septiembre en el antiguo panel por minuto.
Lo que no se puede medir aparece como «not reported».
La mayoría de los paneles de GPU promedian cuatro tarjetas en una sola línea y representan un valor que falta como 0. Este da a cada tarjeta su propio panel: temperatura frente al umbral de limitación térmica que indica su controlador, potencia frente al límite de la propia tarjeta, frecuencias, ventilador, el enlace PCIe tal como está negociado en ese momento, y ECC y NVLink si la tarjeta los tiene. Dos tarjetas compradas con dieciocho meses de diferencia siguen siendo dos tarjetas, y un valor que el controlador no proporciona se marca como ausente en lugar de representarse como cero.
 Umbral de limitación del controlador, no una estimación
Por qué baja la frecuencia, según el controlador
Potencia frente a su propio límite de 140 W
NVLink y ECC, tal como los indica la tarjeta
| Por tarjeta | Temperatura y umbral de limitación térmica, potencia y su límite, frecuencias del núcleo y de la memoria, ventilador, generación y ancho de PCIe, ECC, NVLink y el proceso del motor que usa la tarjeta |
|---|---|
| Por host | VRAM en uso, uso de GPU (la tarjeta más ocupada), potencia (la suma de las tarjetas) y tokens por segundo |
| Por solicitud | Tiempo hasta el primer token, latencia entre tokens y duración, medidos en el proxy de la misma forma para ambos motores |
Qué está esperando cada solicitud.
La página Stats enumera cada solicitud en curso con la sesión del cliente y la fase en la que se encuentra: en cola en el warden, prefill (el motor leyendo el prompt), razonando, escribiendo una llamada a herramienta o respondiendo. Una insignia indica qué parte del prompt probablemente está en la caché de la réplica. Si un prefill dura más de lo que predice la velocidad de prefill que ha aprendido esta máquina, se indica el motivo probable de la espera: hay otros prompts por delante en la misma réplica, la caché probablemente se ha desalojado, o es lento sin un motivo que el warden pueda ver. La sesión se obtiene del ID que cada herramienta ya envía: Claude Code, Codex, OpenCode y pi sin configurar nada; Hermes y Aider, con una línea de configuración.
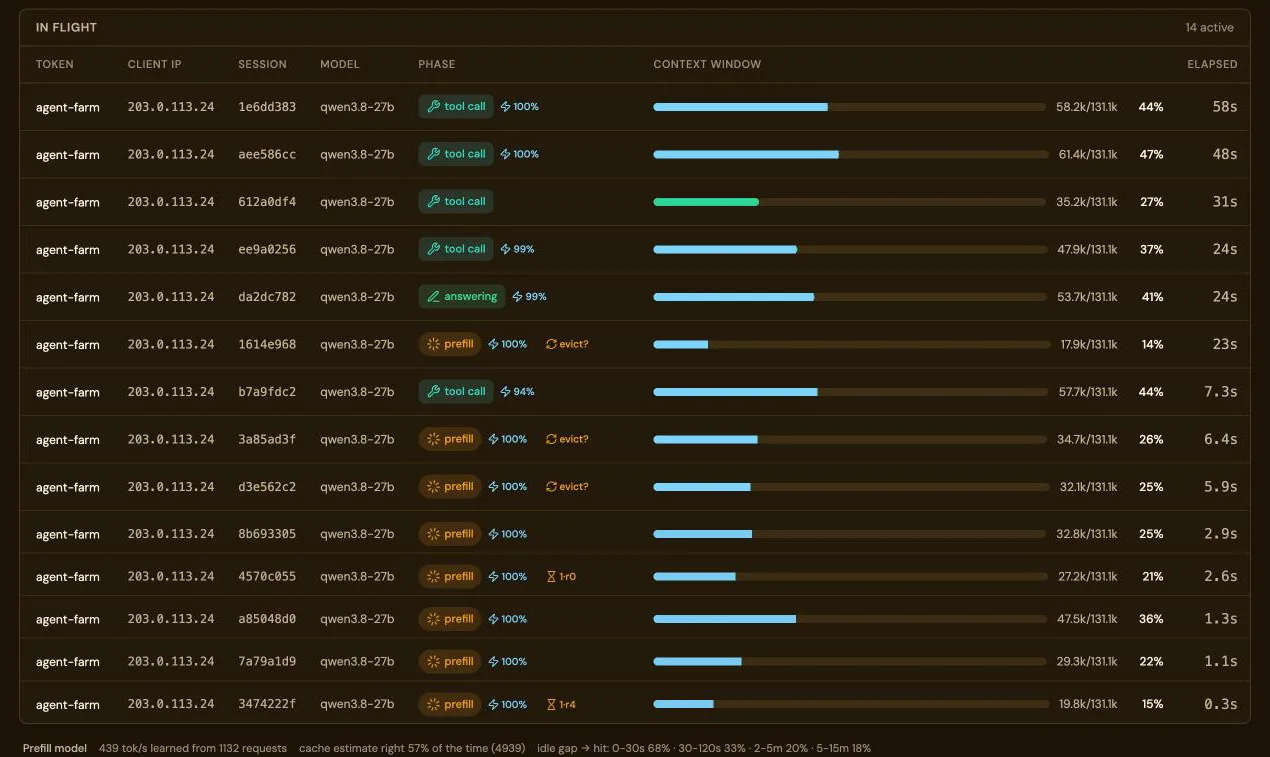 Aún sin token: caché probablemente desalojada
Tiene un prompt por delante en la réplica 4