Has comprado GPU. ¿Están trabajando o esperando?
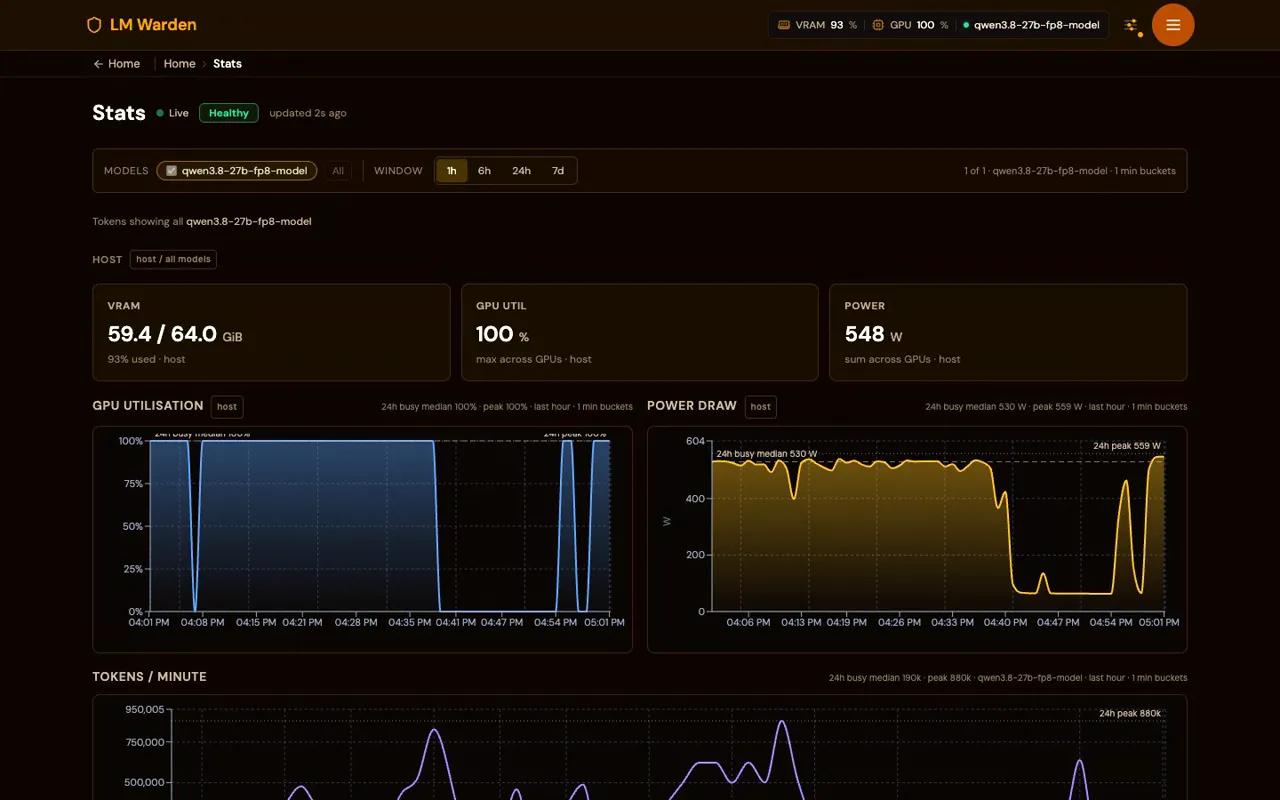
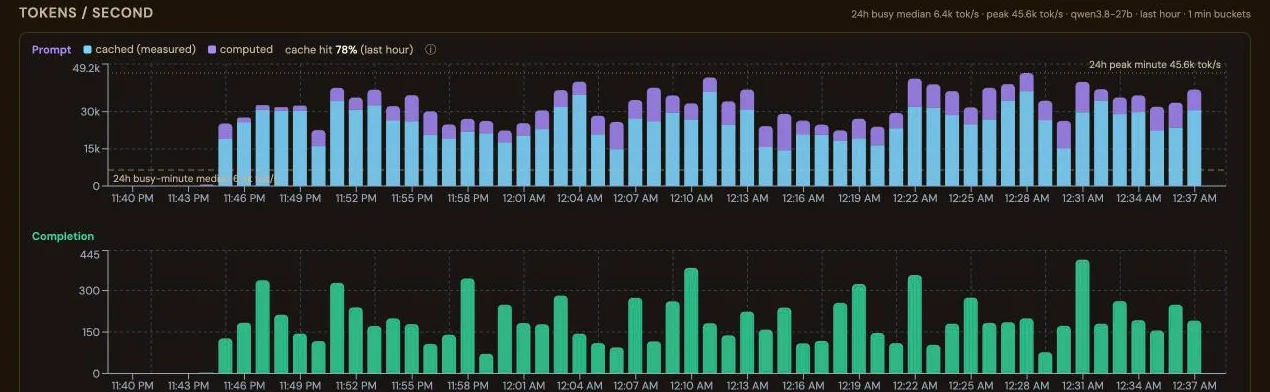
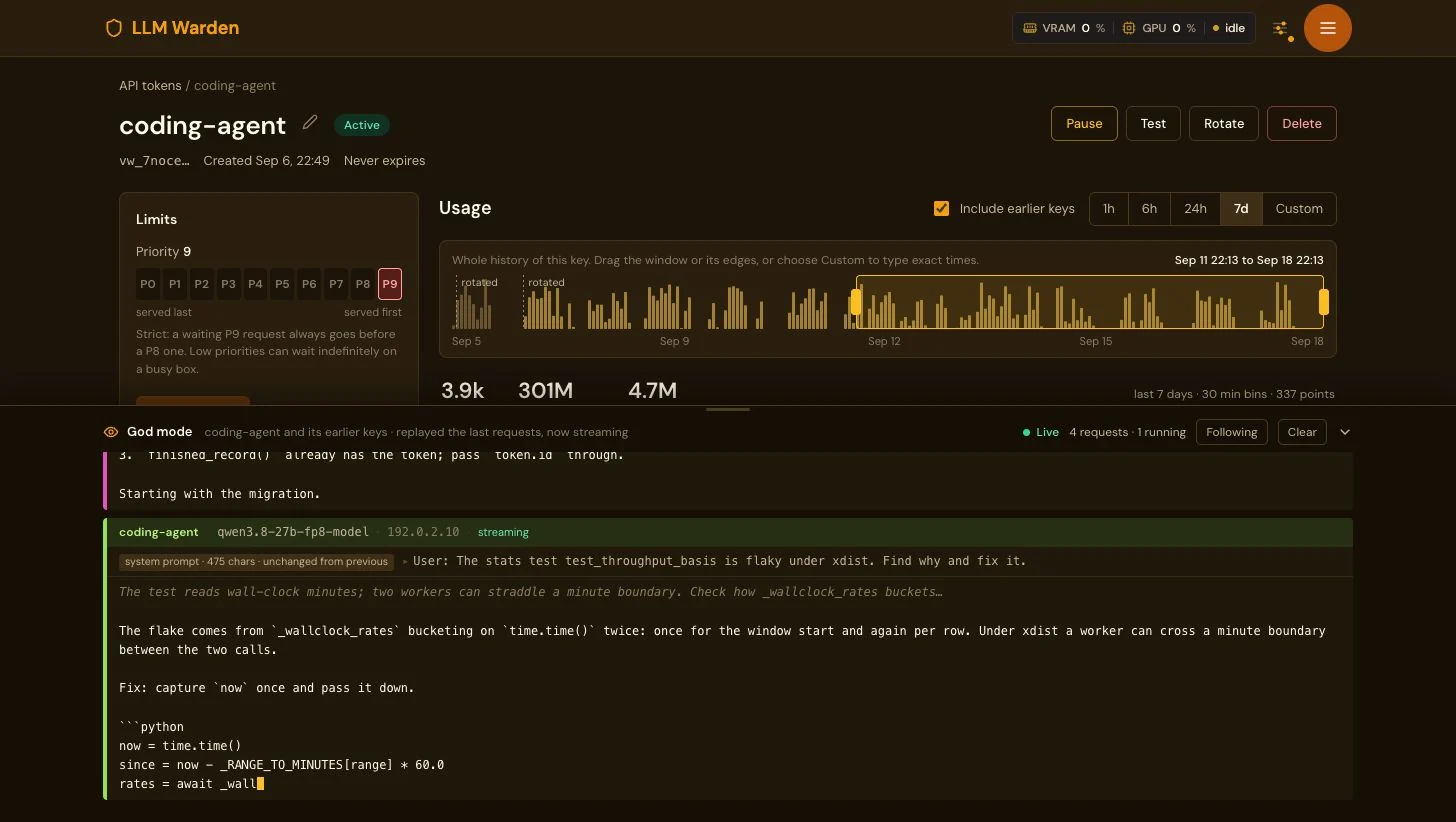
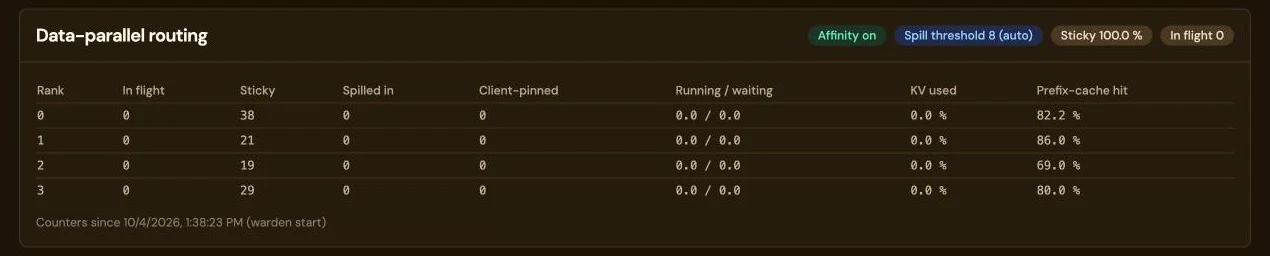
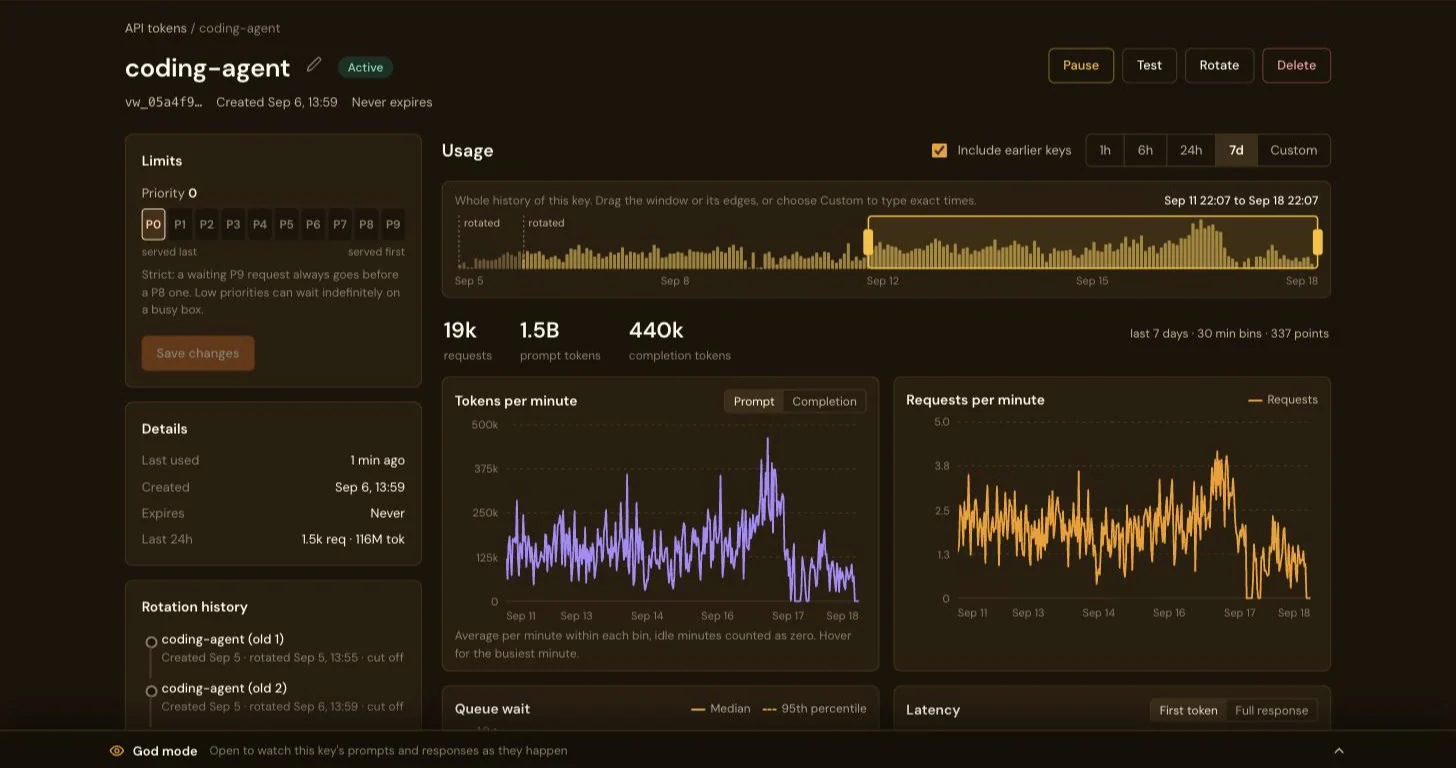
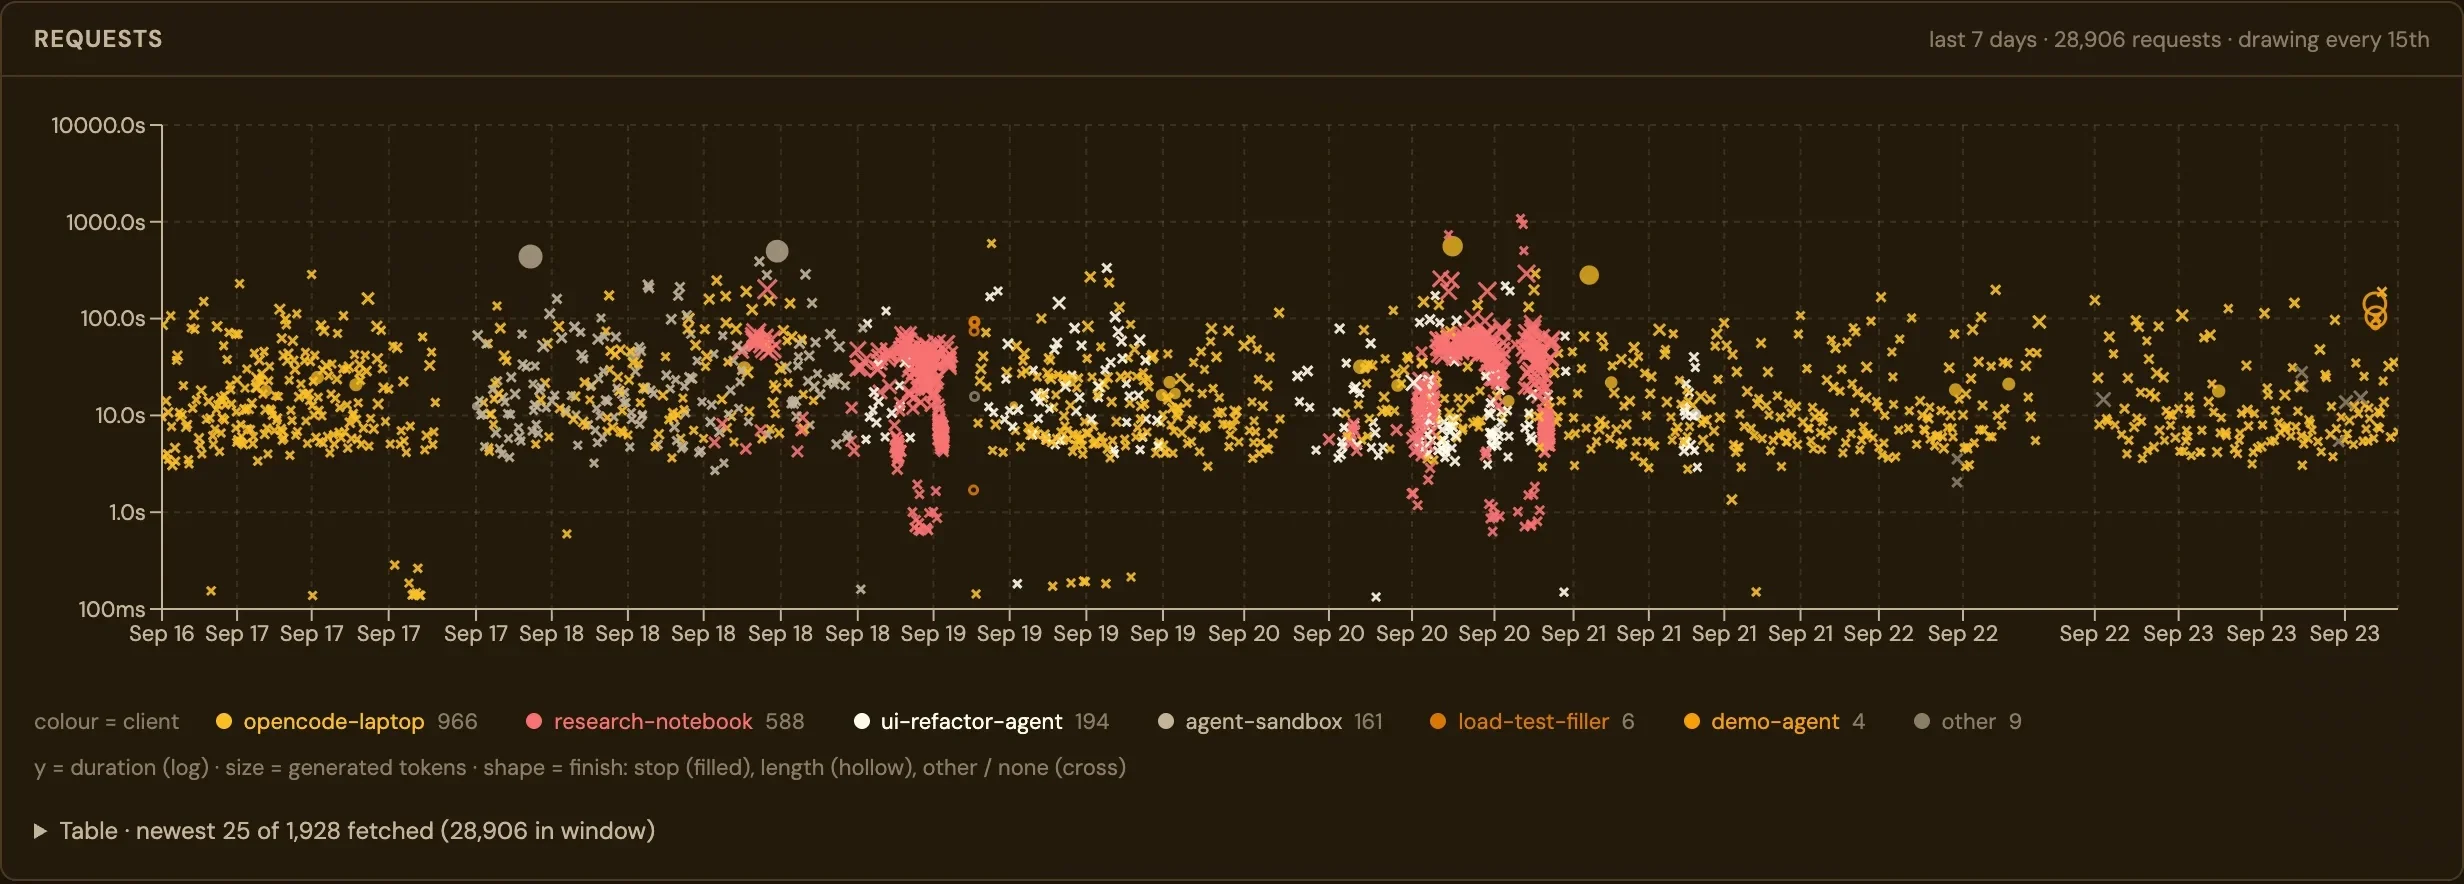
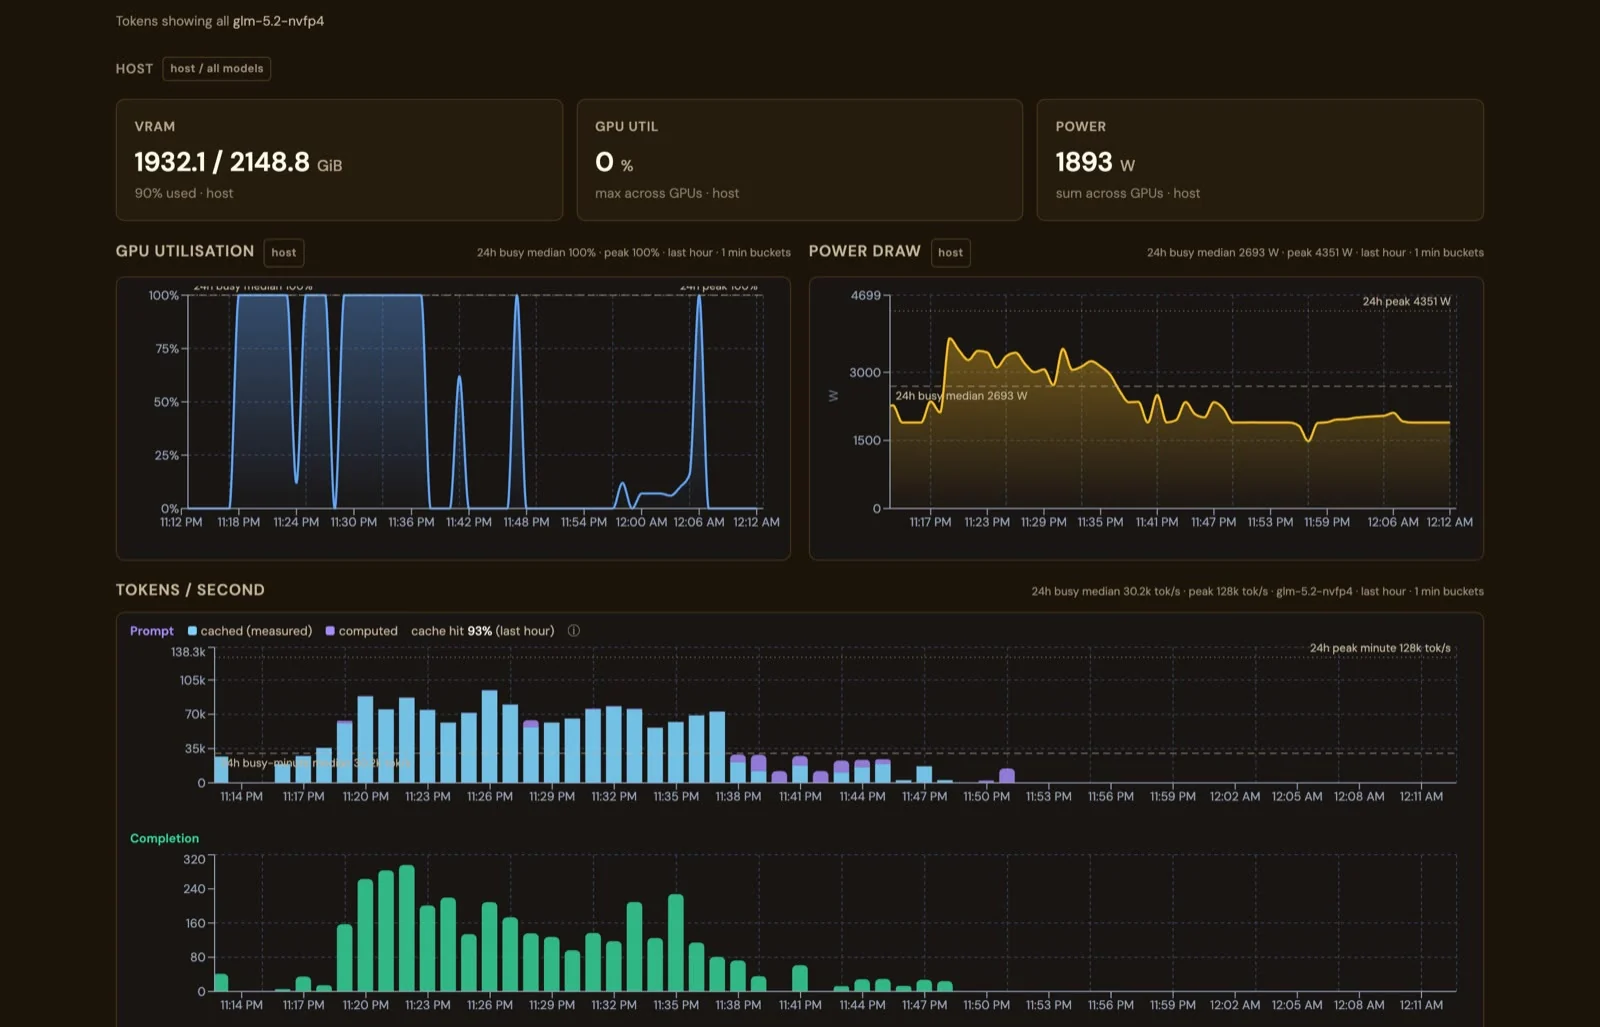
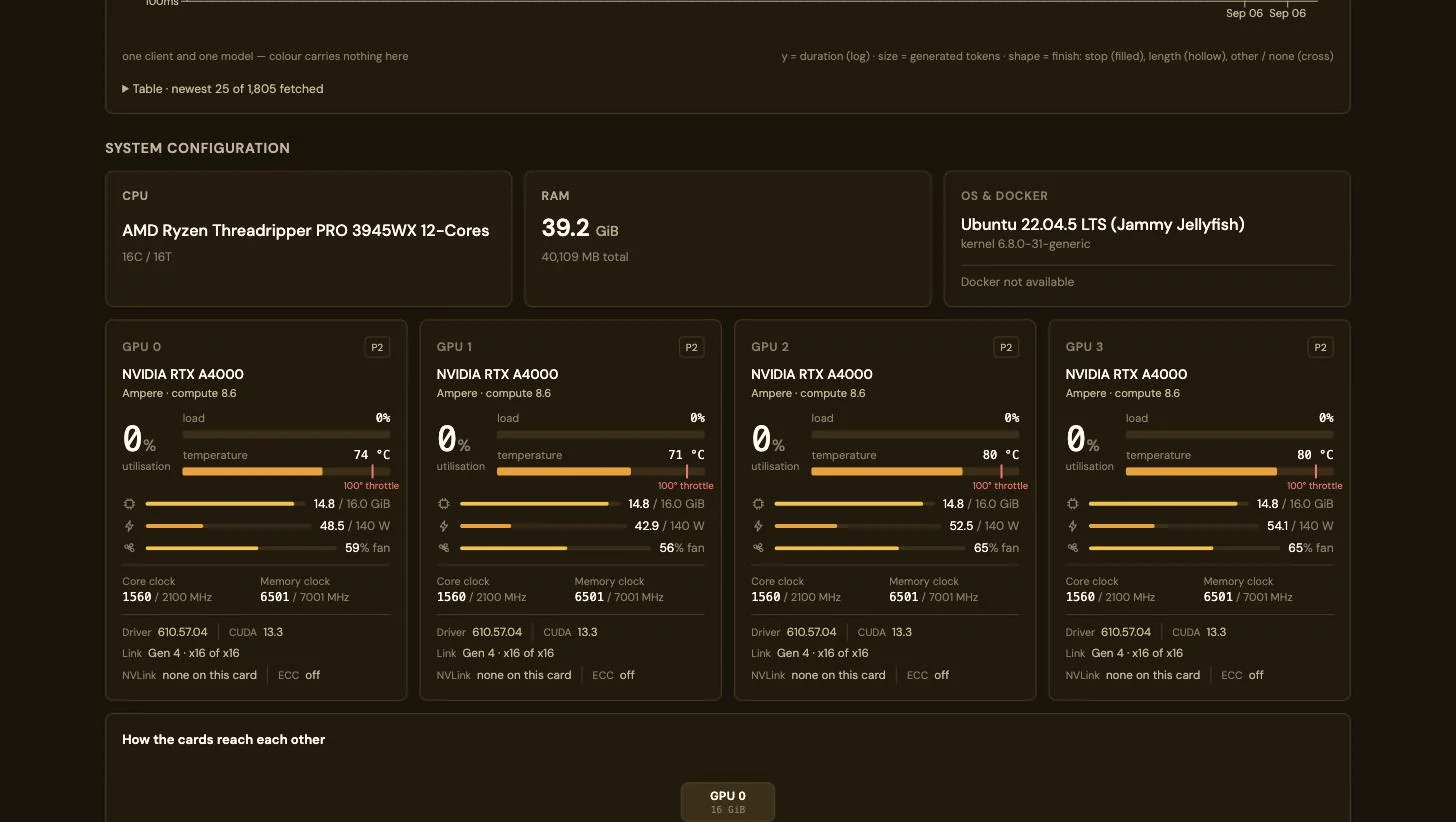
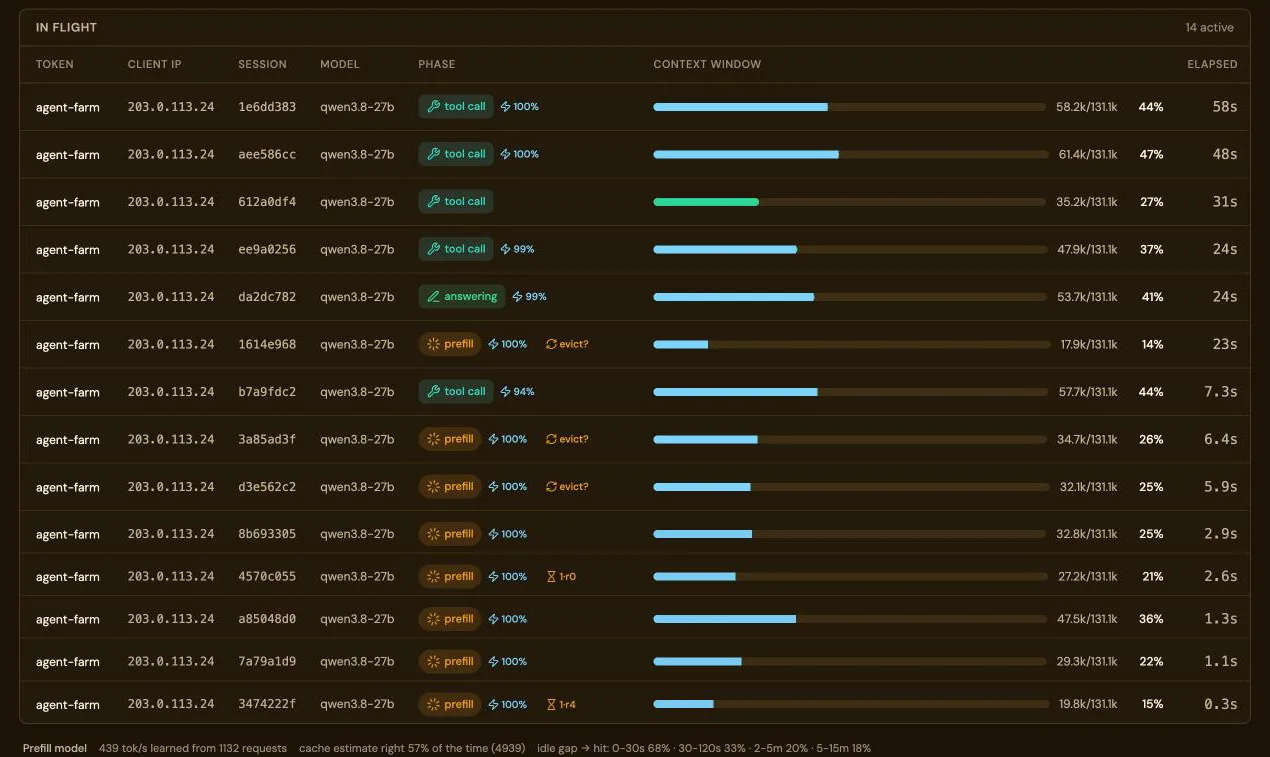
El rendimiento depende de la concurrencia × la longitud del prompt × la reutilización de la caché, y un motor por sí solo no muestra nada de eso en conjunto. La página Stats sí, de 1 h a 7 días: VRAM, uso de GPU, potencia (Linux), tokens por segundo con los tokens de prompt divididos en servidos desde la caché y calculados, latencia p50/p95, tasa de aciertos de la caché de prompts, preempciones y solicitudes por clave y por IP de cliente. Si el uso se estanca mientras hay solicitudes en cola, aumenta la concurrencia; si la proporción de caché es baja, mantén cada sesión en la misma réplica.