LM Warden

Ваші GPU — як хмарний API.

LM Warden запускає vLLM, llama.cpp або MLX на вашому власному обладнанні й дає до них доступ через один OpenAI-сумісний порт: окремий ключ для кожного застосунку, статистика за кожним ключем і панель моніторингу в реальному часі для кожного GPU. На сервері Linux із картами NVIDIA або на Mac з Apple silicon.

Відкритий код, Apache-2.0Без акаунта й телеметріїLinux + NVIDIA · macOS (бета) · Windows — на черзі

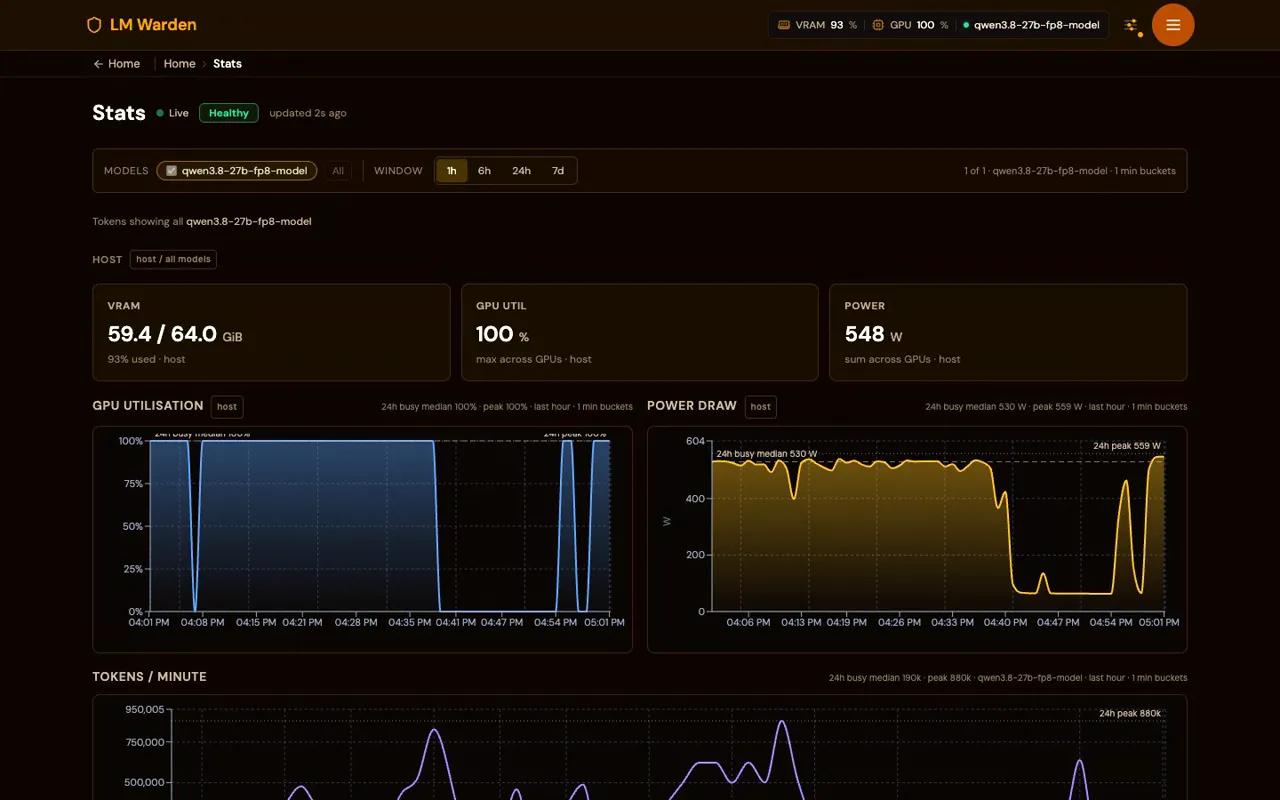
Сторінка Stats навантаженого екземпляра LM Warden: VRAM 59,4 з 64 ГіБ, використання GPU 100 %, потужність 548 Вт і графіки використання GPU, споживаної потужності та токенів за хвилину за останню годину
  • Linux · NVIDIA vLLM v0.32.0 і llama.cpp b11719 на CUDA
  • macOS · Mac з Apple silicon MLX і llama.cpp на Metal
  • API OpenAI, Anthropic Messages і Responses на одному порту
  • Агенти для коду Claude Code, Codex CLI, OpenCode і ще 7 уже налаштовані

Для чого його використовують

Де ви його запускатимете?

Виберіть платформу вище, щоб побачити її кроки, або покажіть усі чотири.

Одна команда на хості з GPU.

curl -fsSL https://raw.githubusercontent.com/Podwarden/lm-warden/main/install.sh | sh -s -- --dir /opt/vllm-warden
  • Хост x86_64, Docker Compose v2.24+, NVIDIA Container Toolkit, карта Turing або новіша.
  • Потім відкрийте http://HOST:8080/ui/, пройдіть майстер першого запуску, додайте модель і створіть ключ. Ваш ендпоінт: http://HOST:8080/v1.
  • Кілька GPU в одному сервері: тензорний паралелізм або по одній репліці на карту з маршрутизацією з урахуванням кешу.
  • Сьогодні — NVIDIA. Підтримка AMD ROCm і GPU Intel з’явиться незабаром; дат поки немає. Розкажіть нам, на чому ви б його запускали: Radeon · Intel.
  • Установлення · Без інтернету · З вихідного коду · Оновлення
Завантаження моделі на сторінці Models: для кожного кроку — скільки часу минуло і скільки він зазвичай триває
Завантаження моделі після інсталяції: для кожного кроку звичайний час за попередніми завантаженнями.

Застосунок у рядку меню, бета-версія.

Завантажити для Mac (бета)

  • Близько 110 МБ. Apple silicon (M1 або новіший), macOS 14 або новіша. SHA-256 · примітки до випуску.
  • Рушії: MLX і llama.cpp, зібраний із підтримкою Metal. Та сама панель керування й той самий OpenAI API; без vLLM і без даних про потужність.
  • Чесно про бета-версію: застосунок підписано ad-hoc і не нотаризовано, тому під час першого запуску macOS попросить дозволити його в розділі «Приватність і безпека»; оновлення — це нове завантаження. Кроки першого запуску.
  • Доступний лише на 127.0.0.1, доки ви не виберете Share on Local Network.
  • Незабаром: mlx-rust-lm, третій рушій. Команда LM Warden переносить mlx-lm від Apple з Python на Rust на базі офіційного C-інтерфейсу Apple mlx-c; він працюватиме поруч із MLX і llama.cpp та згодом замінить рушій mlx-lm на Python, який разом із Python і його бібліотеками становить більшу частину нинішнього завантаження. Неофіційний проєкт, не пов’язаний з Apple.
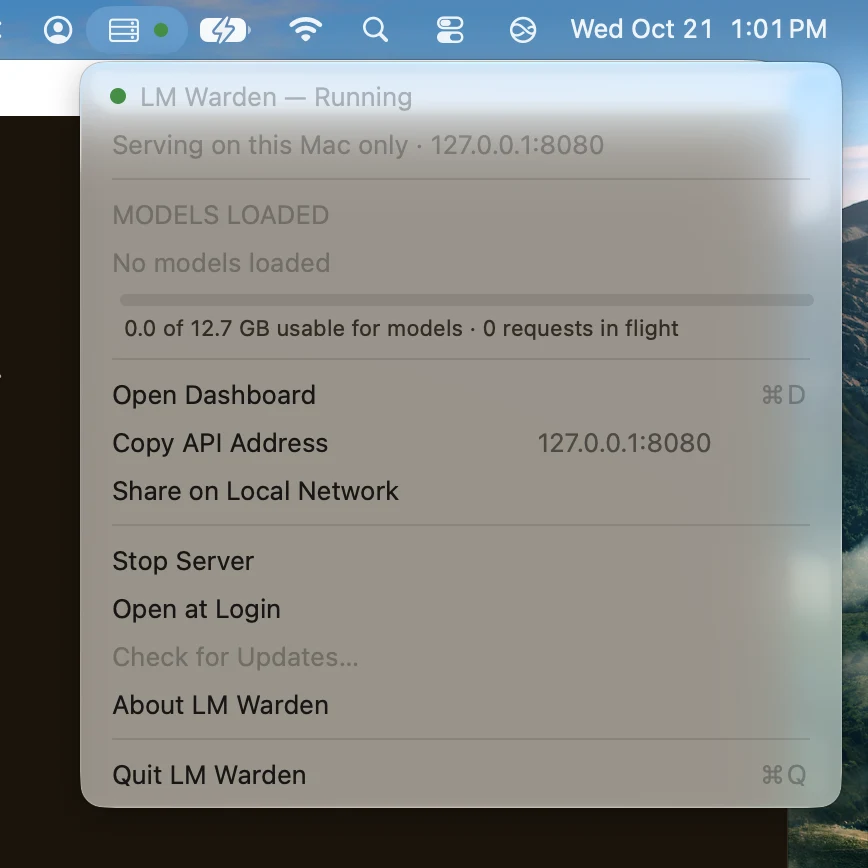
Меню LM Warden у рядку меню Mac: Running, доступ лише з цього Mac за адресою 127.0.0.1:8080, моделі не завантажено, індикатор пам’яті, Open Dashboard, Copy API Address, Share on Local Network
Меню бета-версії в рядку меню на M1 із 16 ГБ.

Наступна — Windows. Дати немає.

Ми вже працюємо над нею й викладемо збірку тут того дня, коли вона буде готова, а не форму реєстрації заздалегідь. А поки що є два робочі варіанти:

  • Запустіть LM Warden на Linux-сервері з GPU й користуйтеся ним із Windows: будь-який клієнт OpenAI, Claude Code і Codex підключаються через мережу.
  • Стежте за випусками на GitHub, щоб дізнатися про першу збірку для Windows.
  • Потім GPU AMD Radeon та Intel; розкажіть нам, на чому ви б його запускали: Radeon · Intel.

Сервер під ключ: незабаром, дати поки немає.

Четвертий спосіб запустити LM Warden — для сервера, який не має робити нічого іншого.

  • Ви вставляєте USB-накопичувач у корпус із GPU. Він установлює полегшений Linux, який робить одне: запускає LM Warden.
  • Він сам налаштовує мережу та сховище для моделей.
  • Оновлення надходять через мережу, або сервер працює повністю в ізольованій мережі.
  • Для захищеного виділеного LLM-сервера: для команди, якій потрібен закритий сервер, або для майданчика, ізольованого від зовнішніх мереж.

Доки він не вийде, інсталяція для Linux вище робить те саме на хості, який ви налаштовуєте самі, зокрема інсталяцію без інтернету / в ізольованій мережі. Стежте за випусками на GitHub.

Зображення поки немає: немає ні назви продукту, ні обладнання, яке можна показати, і малювати його ми не будемо.

Уже користуєтеся? На Linux оновлення не потребує перевстановлення: завантажте нові образи, перезапустіть — і база даних автоматично перейде на нову схему. Кроки · Журнал змін.

У самостійного хостингу вісім проблем. Ось як ми розв’язуємо кожну з них.

Сам по собі рушій обслуговує одну модель на одному порту. Нижче — усе, що потрібно навколо нього, з нашими власними цифрами там, де вони є.

  1. Чи вміститься ця модель на мій GPU?

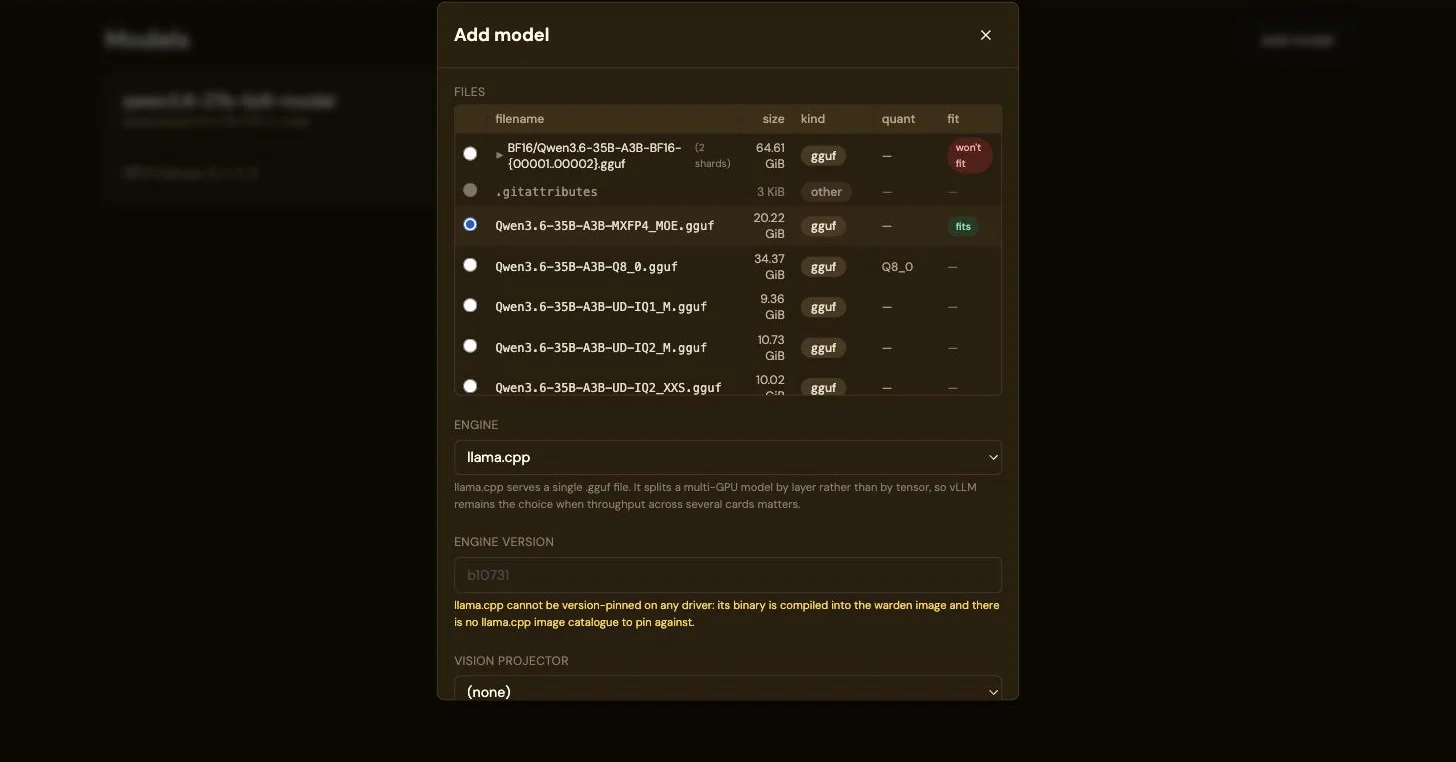
    Вставте репозиторій Hugging Face в Add model. Для кожного файлу видно, чи вміщається він на позначені карти: вміщається, впритул або не вміщається. Позначте більше карт — і їхня пам’ять додасться. Нічого не завантажується, доки не знайдеться варіант, що вміщається.

    Той самий файл на 20,22 ГіБ позначено як такий, що вміщається, коли вибрано чотири GPU
  2. Ви купили GPU. Вони працюють чи чекають?

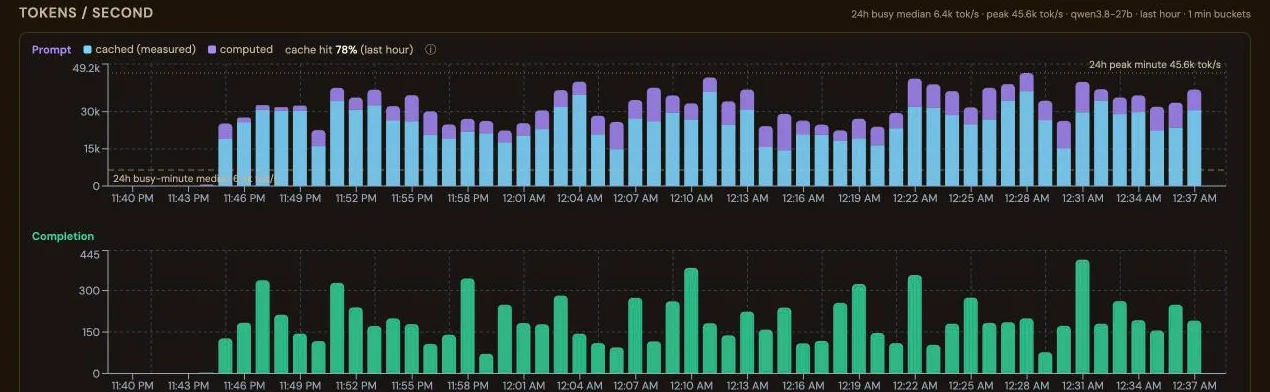
    Пропускна здатність — це паралелізм × довжина промпту × повторне використання кешу, а сам по собі рушій не показує всього цього разом. Сторінка Stats показує це за період від 1 год до 7 днів: VRAM, використання GPU, потужність (Linux), токени за секунду з поділом токенів промпту на кешовані й обчислені, затримку p50/p95, частку влучань у кеш промптів, переривання запитів, запити за ключами та за IP-адресами клієнтів. Рівне використання за наявності черги означає «потрібно більше паралелізму»; низька частка влучань у кеш означає «закріпіть сеанси».

    Токени за секунду: токени промпту поділено на кешовані й обчислені, нижче токени відповіді
  3. Поговоріть із моделлю, перш ніж щось підключати.

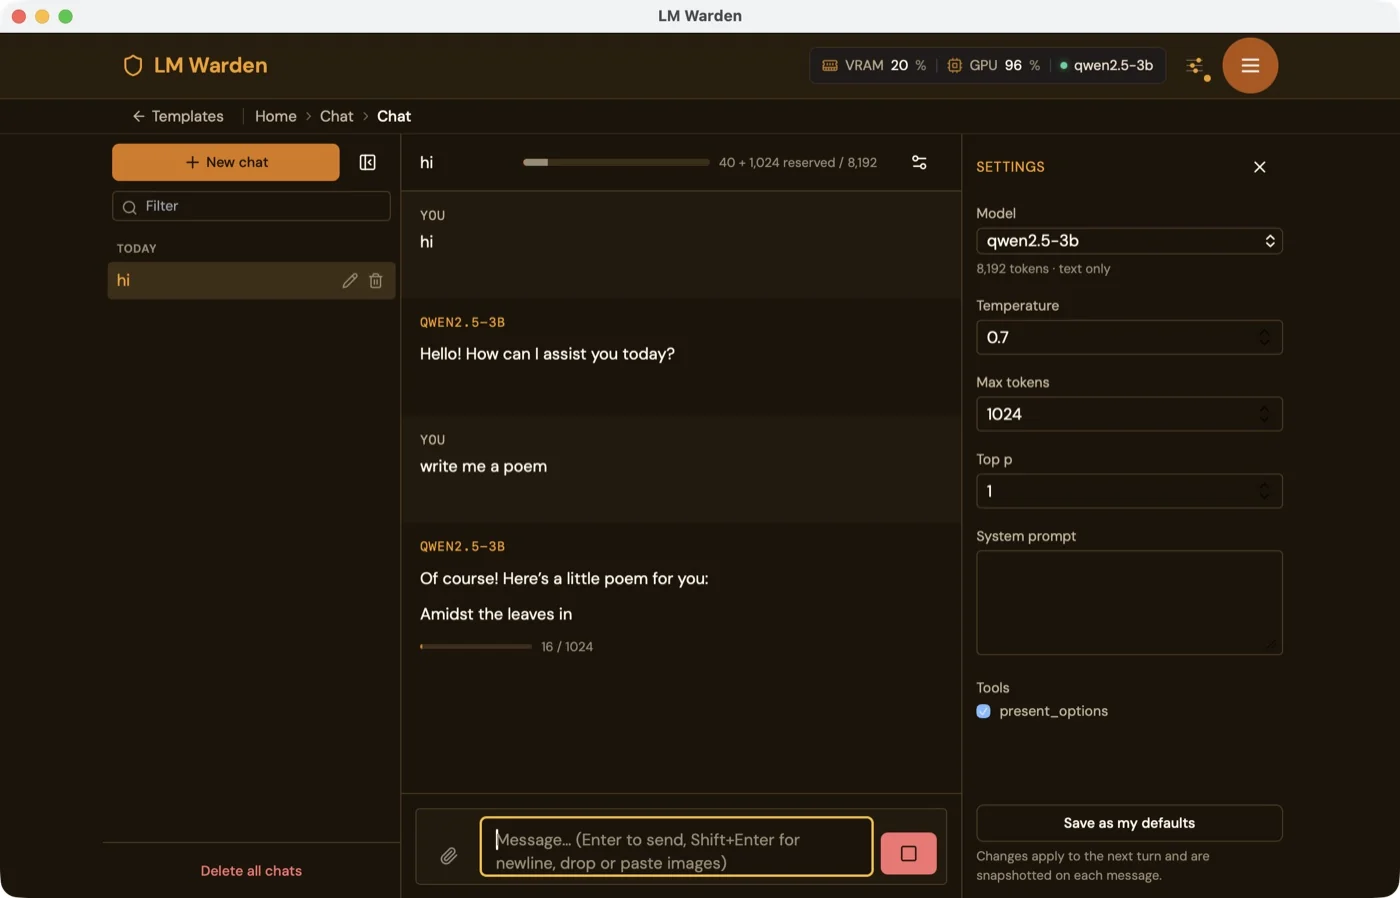
    Чат розташований у тому самому вікні, що й усе інше. Потоковий Markdown із підсвічуванням коду та формулами; до восьми зображень PNG, JPEG або WebP в одному повідомленні для мультимодальної моделі; температура, top-p, максимум токенів і системний промпт для кожного чату, які можна зберегти як значення за замовчуванням; чати зберігаються, отримують назви, їх можна розгалужувати. Виклики інструментів, які робить модель, відображаються, тож виклик інструментів можна перевірити, перш ніж від нього залежатиме агент.
    Чат у вікні панелі керування застосунку для Mac, потокова відповідь qwen2.5-3b, у заголовку GPU 96 %
  4. Що модель насправді отримала й що відповіла?

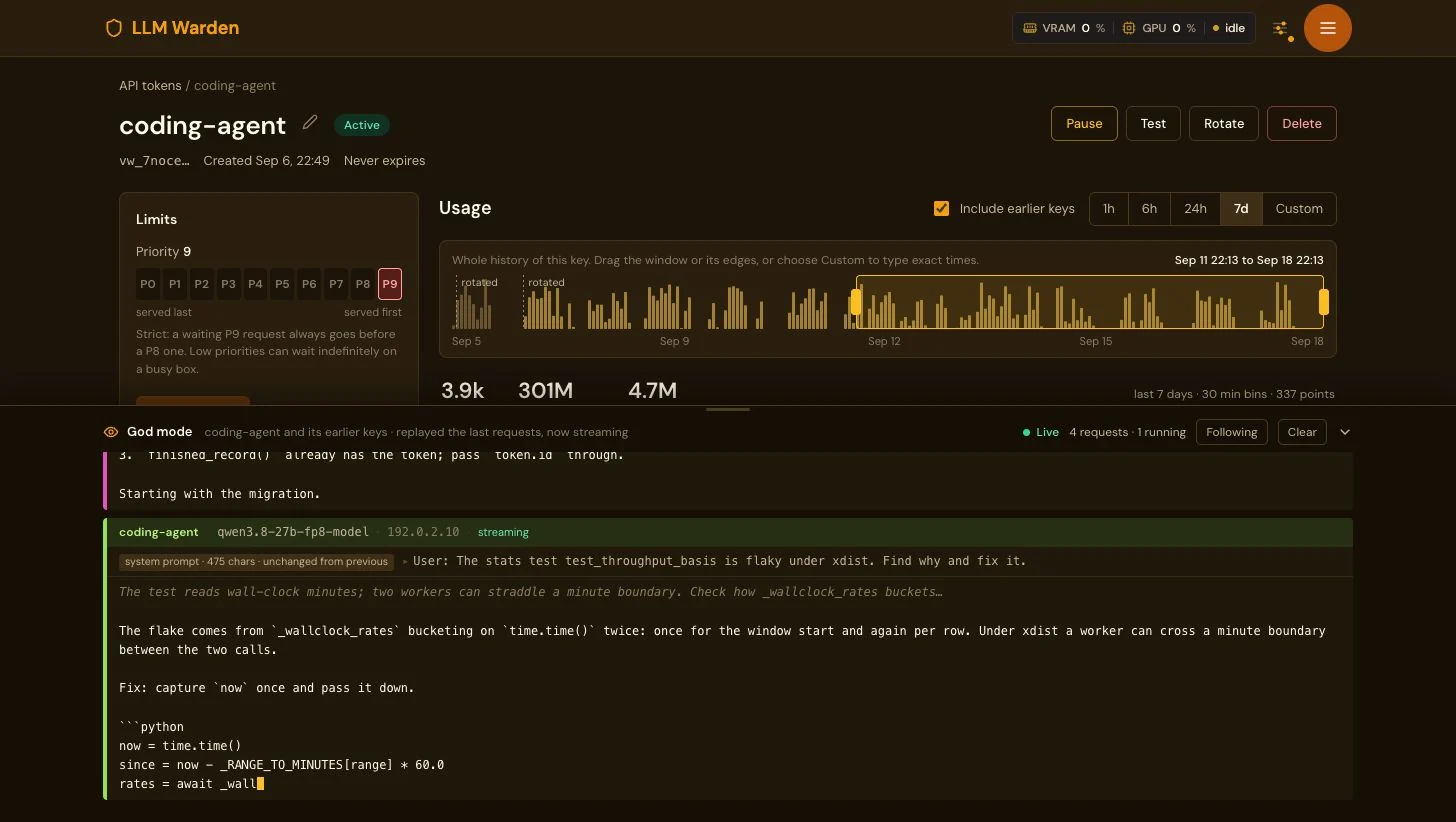
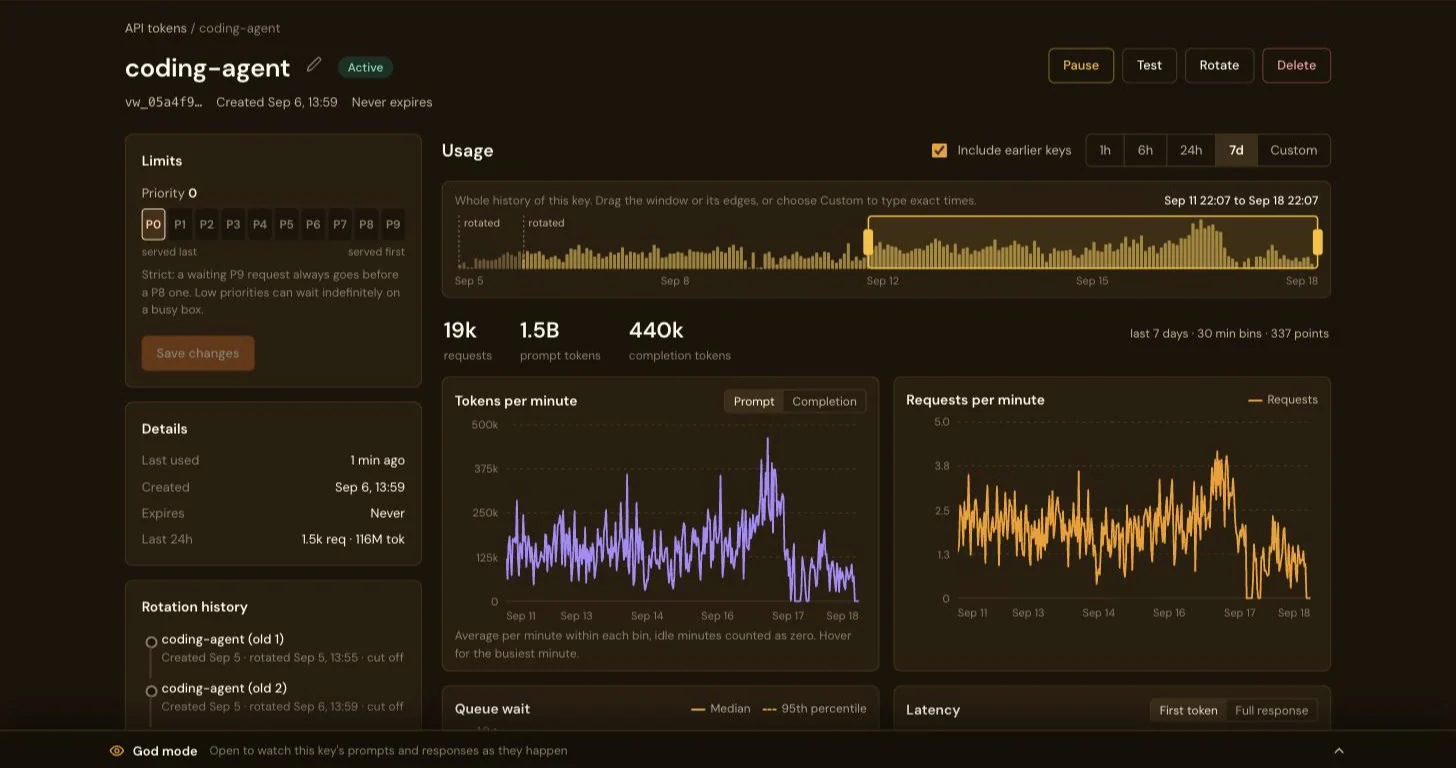
    God mode для налагодження промптів: якщо в розгортанні ввімкнено VW_GODMODE_ENABLED, на сторінці кожного ключа з’являється панель, яка в реальному часі показує промпти й відповіді цього ключа. За замовчуванням вимкнено, а у вимкненому стані його взагалі немає. Обмежений кільцевий буфер у пам’яті: нічого не потрапляє до бази даних чи на диск, усе зникає після перезапуску. Відкрити його може будь-хто із сеансом адміністратора; у LM Warden одна роль адміністратора й інших немає.

    Сторінка ключа API coding-agent із відкритою внизу панеллю God mode: Live, 4 запити, 1 виконується; потік запиту до qwen3.8-27b-fp8 з адреси 192.0.2.10, з промптом користувача про нестабільний тест статистики та відповіддю моделі з виправленням на Python, яка ще пишеться

Агент у кожному раунді заново читає всю розмову.

Агент у кожному раунді заново надсилає всю історію, тому довга розмова — це здебільшого префікс, який рушій уже прочитав. vLLM зберігає цю роботу в кеші префіксів, але лише на тій репліці, яка її виконала, а його власний балансувальник надсилає кожен раунд на репліку з найкоротшою чергою. LM Warden розміщує кожну нову розмову на найменш завантаженій репліці й залишає її там, використовуючи ідентифікатор сеансу, який Claude Code уже надсилає. Запит переноситься, лише коли репліка перевищує свій поріг переповнення.

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Чотири раунди однієї розмови на моделі з чотирма репліками. З балансувальником vLLM кожен раунд проходить prefill (читання промпту в кеш) майже з нуля на тій репліці, якій він дістався. З LM Warden розмова залишається на репліці 2, і prefill проходить лише новий раунд. Це схема механізму, а не вимірювання.

Виміряно на нашому сервері з чотирма картами (4 × RTX A4000, Qwen3-4B як чотири репліки по одній карті, синтетичні сеанси в стилі Claude Code, прив’язку вимкнено, потім увімкнено, поспіль): із закріпленими розмовами частка токенів промпту, обслужених із кешу, зросла з 56 до 86 % на 4 одночасних сеансах, а медіанний час до першого байта знизився з 2,05 до 0,38 с. Вихідних токенів за хвилину було більше на кожному кроці навантаження, а час до першого байта p95 (найповільніші 5 %) був нижчим на кожному кроці. Кількість реплік, що працюють, майже не змінилася (2,71 проти 2,83 з чотирьох на 4 сеансах): виграш дає повторне використання кешу, а не більша кількість задіяних карт.

Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
Частка влучань у кеш префіксів на кожному кроці: токени промпту, обслужені з кешу, поділені на запитані токени промпту, сумарно для всіх чотирьох реплік, за зміною власних лічильників vLLM за крок. Виграш зберігається, доки є запас, і зникає на 32 сеансах, коли розмови через переповнення переходять на інші репліки.
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
Час до першого байта на 4–32 одночасних сеансах, медіана й p95, у логарифмічній шкалі, щоб значення менше за секунду читалися поруч із хвилинними. З прив’язкою медіана значно нижча до 16 сеансів (0,38 проти 2,05 с на 4) і вища на 24 і 32; p95 нижчий на кожному кроці, хоча на 16 різниця (24,9 проти 26,2 с) у межах шуму одного прогону на варіант. Виміряно на клієнті, через інтернет, до першого потокового токена.

Кожен крок навантаження: прив’язка вимк. → увімк.

SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

Виміряно на нашому сервері з чотирма картами на невеликій моделі, спочатку з вимкненою прив’язкою, потім з увімкненою, без перезапуску vLLM між ними: другий варіант починався з прогрітим кешем префіксів, і обидва брали промпти з одного seed. Кожен крок триває 3 хвилини, тому завершує лише від 9 до 31 сеансу, і один сеанс більше чи менше зсуває кількість сеансів за годину на 20; вихідні токени за хвилину — стабільніший стовпець. Ваші модель, карти й навантаження будуть іншими; картка реплік на сторінці моделі показує ті самі лічильники для вашої системи.

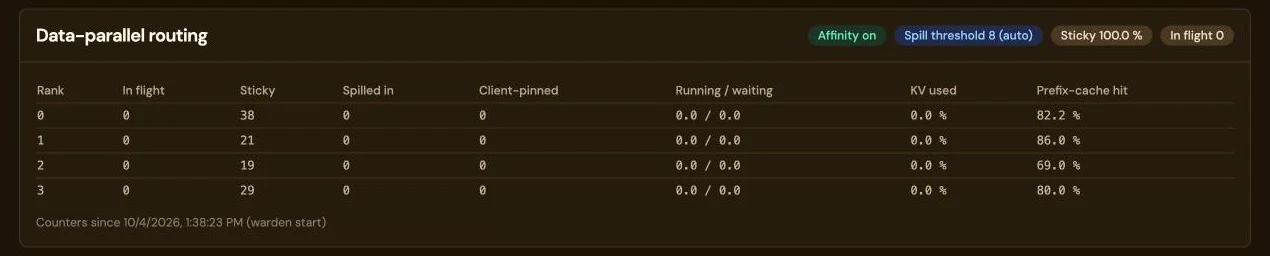
Картка Data-parallel routing на сторінці моделі з мітками Affinity on, Spill threshold 8 (auto), Sticky 100.0% та In flight 0. У таблиці репліки від 0 до 3 зі стовпцями in flight, sticky (38, 21, 19 і 29), spilled in, client-pinned, running і waiting, зайнятий KV і частка влучань у кеш префіксів (82,2; 86,0; 69,0 і 80,0 відсотка), а також рядок про те, що лічильники ведуться від запуску LM Warden.
Ті самі лічильники на сторінці моделі: по рядку на репліку із запитами, які вона тримає, кількістю розмов, що залишилися (sticky) або прийшли через переповнення, тим, що виконується й чекає, зайнятим KV-кешем і часткою влучань у кеш префіксів. Записано 4 жовтня 2026 р. з увімкненою прив’язкою та порогом переповнення 8 (auto): sticky 100 % і частка влучань у кеш префіксів 82,2; 86,0; 69,0 і 80,0 % на репліках з 0 по 3. Це знімок панелі, а не результат тесту. Торкніться зображення, щоб збільшити його.

Де прив’язка програє. Кроки з 24 і 32 сеансами — це навмисне перевантаження чотирьох невеликих карт, і кожна репліка насичена. Вихідних токенів за хвилину все одно більше (11 178 проти 9 048 і 16 638 проти 14 760), а повільний хвіст значно коротший (p95 38 проти 59 с і 39 проти 83 с), але медіанний час до першого байта з прив’язкою гірший: 13,1 проти 5,1 с на 24 сеансах, 27,7 проти 12,3 с на 32. Ми не з’ясували причину, і зниження порогу переповнення з 8 до 4 її не змінило.

На навантаженому сервері виміряйте обидва варіанти. Перевага найбільша, доки є запас; серверу, який працює на межі, варто виміряти обидва налаштування, а прив’язку можна вимкнути для кожної моделі окремо. Репліки, а отже й ця маршрутизація, входять до інсталяції для Linux із GPU NVIDIA; у застосунку для Mac (бета) немає ні тензорного паралелізму, ні паралелізму за даними.

Повна методика: навантаження, тестовий стенд, поріг переповнення та сервер із сімома GPU, який відтоді з нею працює →

Підключіть агента для програмування до власних GPU.

Десять інструментів підключаються за базовою URL-адресою та ключем; два з них можуть також зберегти платну передплату Claude для складної роботи.

Збережіть передплату Claude, а рутинні виклики віддайте своїм GPU

Claude Code та Anthropic SDK — через маршрутизатор. Правило визначає моделі Claude, за які відповідають ваші GPU; усе інше йде до Anthropic під вашим обліковим записом або ключем.

Куди йде запит Claude Code Агент надсилає кожен запит до маршрутизатора LM Warden. Запити до моделей claude-haiku надходять до моделі на вашому GPU, а відповідь повертається від імені запитаної моделі. Усі інші моделі, зокрема Opus, передаються до Anthropic під вашим обліковим записом. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* your GPUanswers as that model everything else,Opus included Anthropicon your own login Куди йде запит Claude Code Агент надсилає кожен запит до маршрутизатора LM Warden. Запити до моделей claude-haiku надходять до моделі на вашому GPU, а відповідь повертається від імені запитаної моделі. Усі інші моделі, зокрема Opus, передаються до Anthropic під вашим обліковим записом. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* everythingelse, Opusincluded your GPUanswers as that model Anthropicon your own login
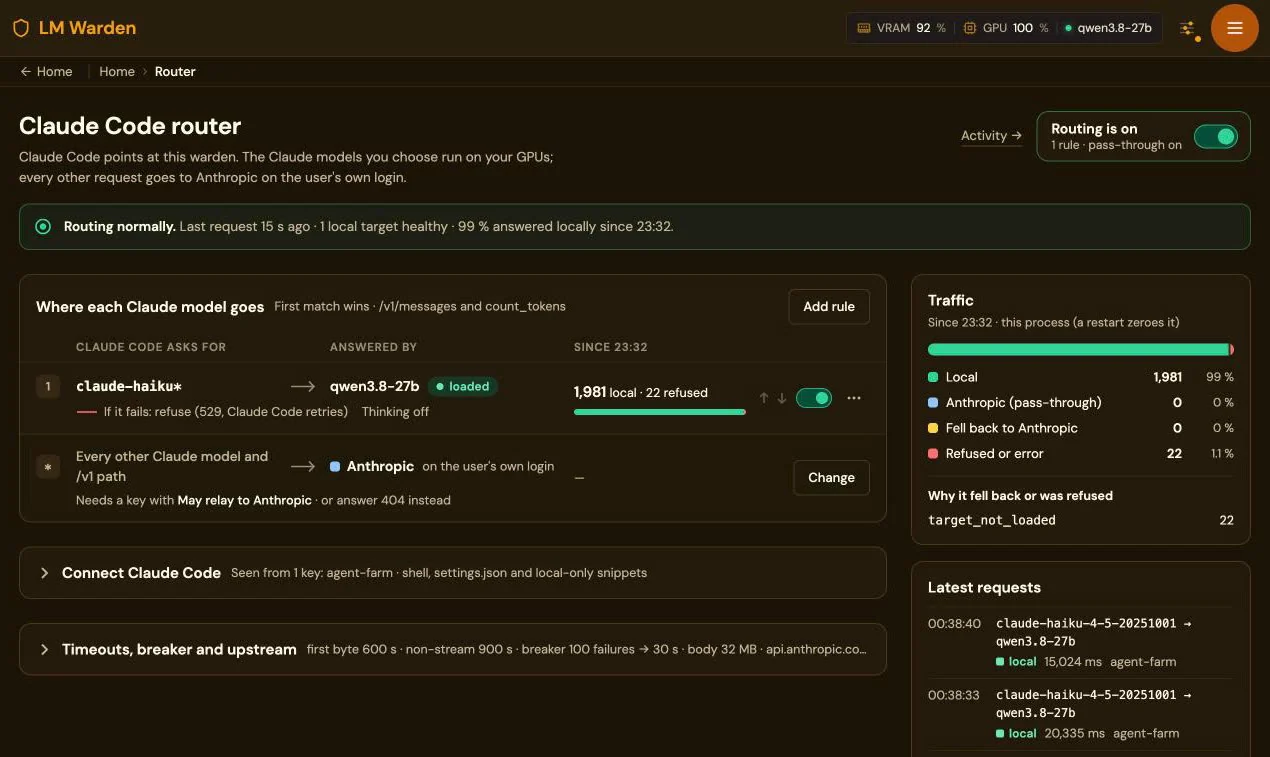
1 981запит оброблено локально — 99 % трафіку Claude Code на сервері від його перезапуску. Зі сторінки Router нашого власного сервера із сімома GPU, 21 жовтня 2026 р.; 22 відхилено, поки цільову модель не було завантажено.
Сторінка маршрутизатора Claude Code: маршрутизацію ввімкнено, 99 % відповідей локально від 23:32; правило 1 надсилає claude-haiku* до qwen3.8-27b, 1 981 локально й 22 відхилено; усі інші моделі Claude йдуть до Anthropic під обліковим записом користувача
Claude Code 2.1.227 або новіший: ANTHROPIC_BASE_URL вказує на LM Warden, ключ LM Warden у ANTHROPIC_CUSTOM_HEADERS, ваш обліковий запис не змінюється. Якість відповідей ми не порівнювали: доручайте локальній моделі рутинну, чітко поставлену роботу.

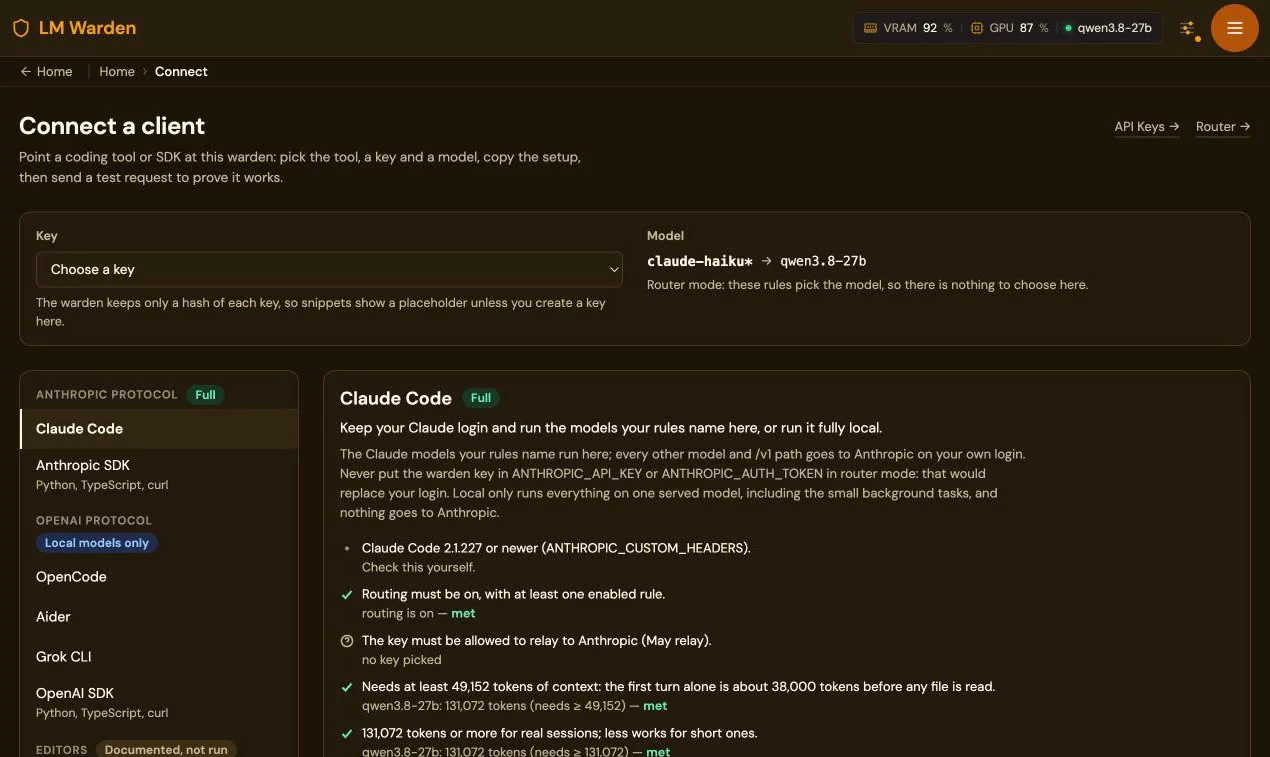
Connect записує конфігурацію кожного клієнта й надсилає тестовий запит.

Виберіть у консолі клієнта, ключ і завантажену модель; консоль звірить кожну вимогу з тим, що справді завантажено (контекстне вікно, виклик інструментів, увімкнений маршрутизатор), і видасть файли для вставлення. Усі агенти для програмування: по сторінці на клієнта з тим, що працює і що ми побачили.

Сторінка Connect a client: вибір ключа, правило маршрутизатора claude-haiku* до qwen3.8-27b, клієнти за протоколами та панель Claude Code з перевіреними вимогами

Нехай ШІ, за який ви вже платите, налаштує ваші GPU.

Вибрати модель для ваших карт — означає вибрати квантування, рушій, спосіб розподілу між GPU, розмір контексту й тип KV-кешу; кожна спроба означає нове завантаження файлів і запуск моделі. Усе, що робить консоль, — це виклик API, тому Claude Code, Codex або інший агент із доступом до командного рядка може виконати цей пошук за вас, на вашому обладнанні та з вашим навантаженням.

Цикл

Цикл налаштування Вивчити GPU, відібрати моделі за допомогою перевірки сумісності до будь-якого завантаження, завантажити варіанти розкладки, провести бенчмарки на реальних запитах, скоригувати налаштування й залишити завантаженим найкращий варіант. Бенчмарк і коригування повторюються, доки агент не буде задоволений. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner Цикл налаштування Вивчити GPU, відібрати моделі за допомогою перевірки сумісності до будь-якого завантаження, завантажити варіанти розкладки, провести бенчмарки на реальних запитах, скоригувати налаштування й залишити завантаженим найкращий варіант. Бенчмарк і коригування повторюються, доки агент не буде задоволений. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner

Що викликає агент: GET /api/system/gpus, POST /api/models/fit-preview до будь-якого завантаження, реєстрацію та suggest-config, завантаження файлів і запуск моделі, стрес-прогін, який знаходить і застосовує реальну межу контексту, GET /api/stats/v2/throughput і latency, а також ключ для інференсу, який він створює для тестового трафіку. Спочатку він читає /agent-guide.md — короткий опис цих викликів, написаний для мовної моделі.

Завантаження моделі на сторінці Models: для кожного кроку — скільки часу минуло і скільки він зазвичай триває
Що агент відстежує, поки завантажується розкладка: для кожного кроку звичайний час за попередніми завантаженнями. Завантаження, яке перестало просуватися, зупиняється, а його GPU звільняються.

Чотири промпти для вставлення і що ви отримаєте

  1. Вивчити й відібрати. Запит: перелічи мої GPU, відбери три моделі з відкритими вагами для агентного програмування, які вміщаються з контекстом щонайменше 65 536 токенів, перевір кожну через fit-preview, нічого не завантажуй. Результат: таблиця з моделлю, квантуванням, рушієм, GPU, контекстом і обґрунтуванням.
  2. Рушій і розкладка для однієї моделі. Запит: вибери vLLM або llama.cpp і тензорний паралелізм або репліки з паралелізмом за даними на моїх картах; завантаж дві найкращі розкладки, надішли кожній ті самі 20 потокових запитів, порівняй за паралелізму 1 і 8. Результат: час до першого токена й токени за секунду для обох, найкраща розкладка лишається завантаженою, другу вивантажено, тестовий ключ відкликано.
  3. Знайти реальні межі й застосувати їх. Запит: проведи стрес-прогін завантаженої моделі, застосуй виміряний контекст, потім проведи бенчмарк за паралелізму 1, 4 і 16 із промптами приблизно на 2 тис. і 30 тис. токенів. Результат: межу контексту записано в налаштування моделі, а також таблиця часу до першого токена й токенів за секунду за паралелізмом і розміром промпту.
  4. Порівняти двох кандидатів на вашій роботі. Запит: повтори промпти з ./workload/*.txt на моделі A та моделі B за паралелізму 4, оціни кожну відповідь. Результат: model-comparison.md із затримкою, токенами за секунду, правильністю за оцінкою агента й рекомендацією; рекомендована модель залишається завантаженою.

Перш ніж почати. Токен адміністратора дає повні права адміністратора в LM Warden (моделі, ключі, налаштування; вужчих прав доступу поки немає): задайте йому короткий строк дії й відкличте його в Settings → Access Tokens, коли роботу завершено. Стрес-прогін навмисно доводить рушій до збою, щоб знайти його межу: запускайте ці промпти на екземплярі, від якого більше ніхто не залежить. Завантаження великі; промпти перевіряють сумісність перед завантаженням, але стежте за місцем на диску.

Вибір рушія й розкладки (vLLM, тензорний паралелізм або паралелізм за даними) стосується інсталяції для Linux; на Mac вибір — MLX або llama.cpp на одному GPU. Налаштування може виконувати будь-яка модель, за яку ви вже платите; а налаштовує вона ту модель, що працює на ваших картах. Сторінка про налаштування агентом: усі чотири промпти повністю.

Один сервер із GPU для всієї команди, родини та ваших агентів.

Створіть стільки ключів API, скільки потрібно, і роздайте їх: колезі, члену родини, завданню CI, цілій групі агентів — кожному свій ключ, свій пріоритет і своя сторінка використання. Обладнання працює на всіх, а важлива робота ніколи не чекає.

Ваше обладнання без прикрас: від Mac до восьми B300.

Та сама консоль читає дані M1 із 16 ГБ, двох різних карт під столом і сервера 8 × B300 з NVSwitch і вказує на вузьке місце, а не ховає його в середньому значенні: з’єднання PCIe, що працює в режимі x4 замість x16, неактивні канали NVLink, різний ECC на різних картах.

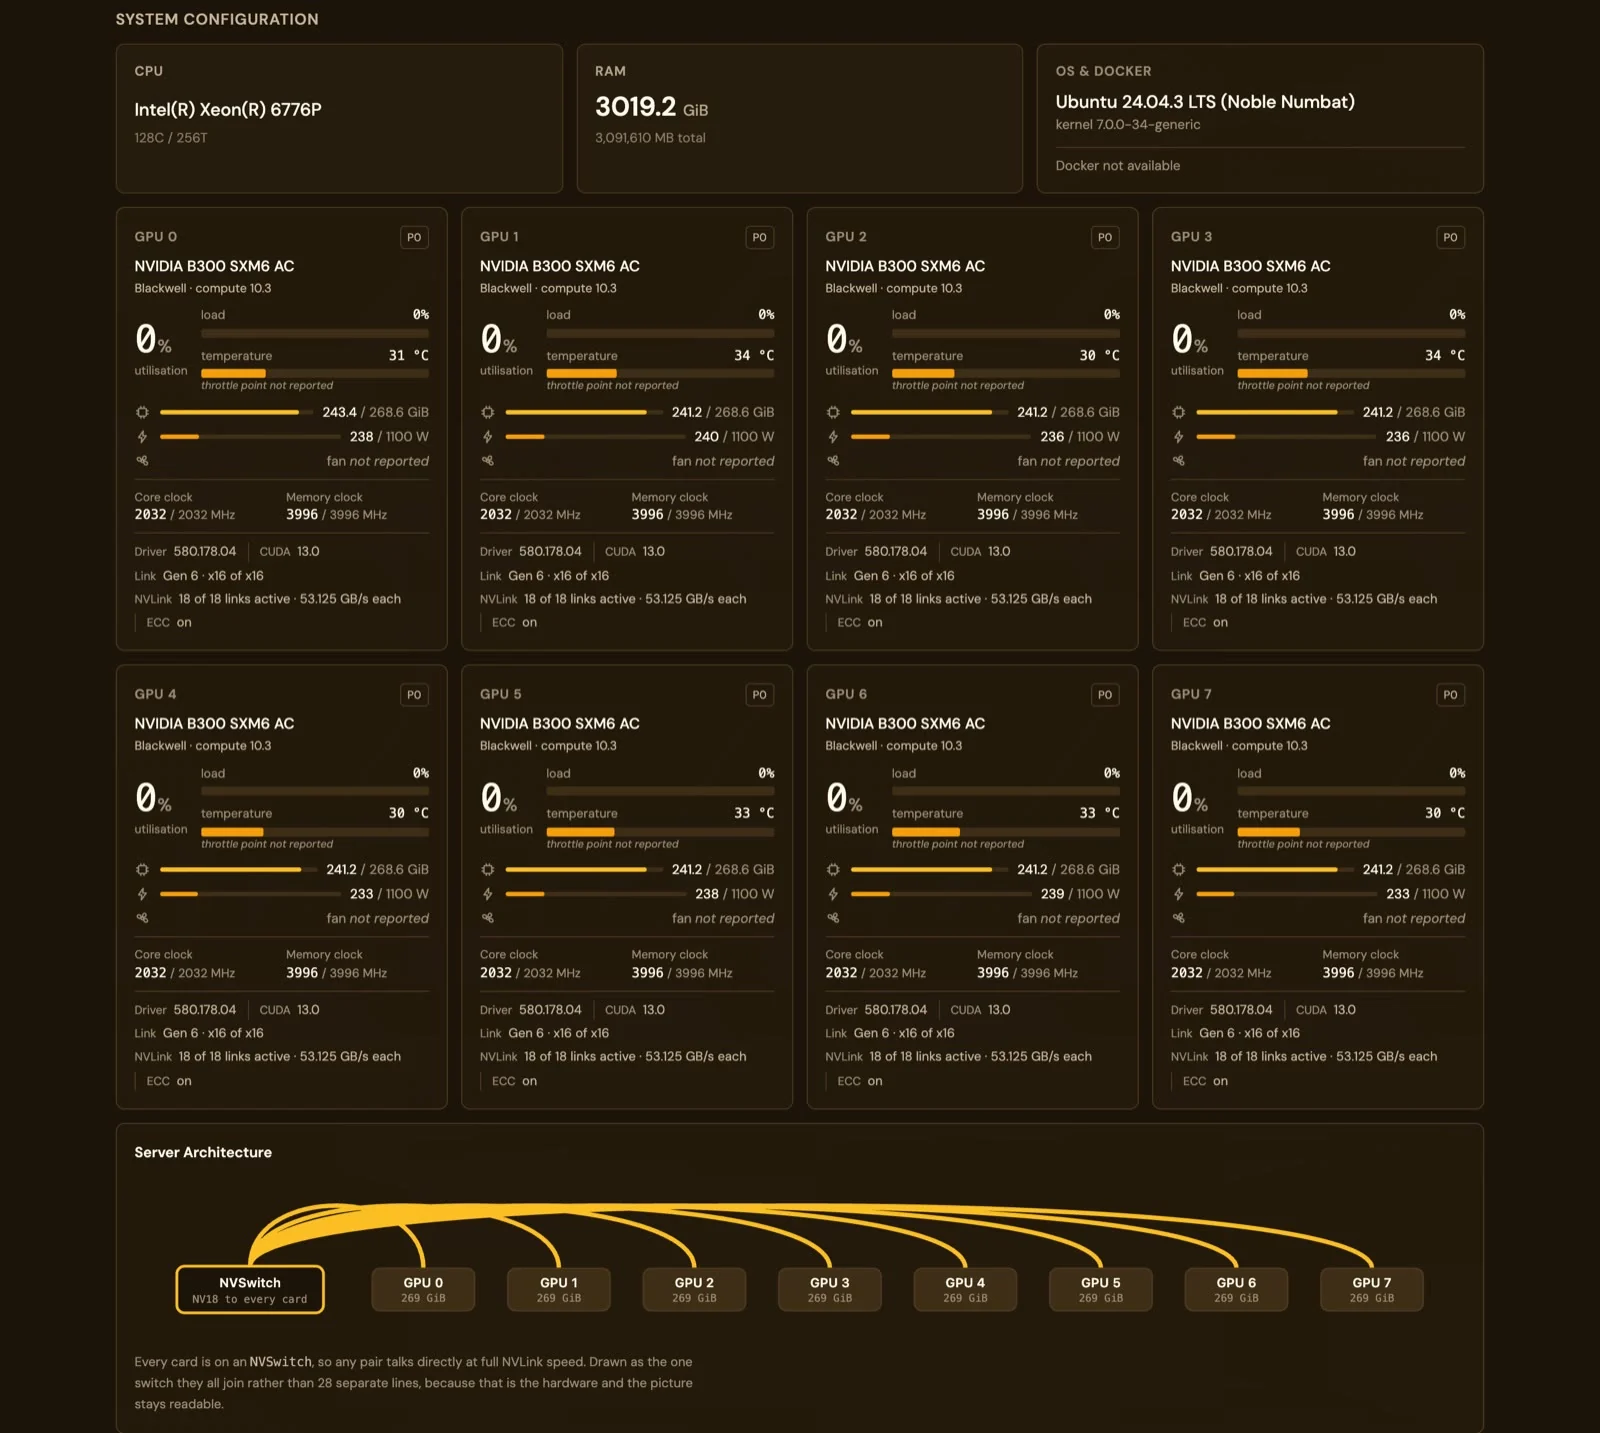
Конфігурація системи на сервері 8 × B300: Intel Xeon 6776P, 3019 ГіБ ОЗП, вісім панелей NVIDIA B300 SXM6, на кожній зайнято 241 з 268,6 ГіБ, Link Gen 6 x16 з x16, NVLink 18 з 18 каналів активні по 53,125 ГБ/с кожен, ECC увімкнено, і схема архітектури сервера з одним NVSwitch, з’єднаним із кожною картою
Вісім карт B300 SXM6 на одному NVSwitch: 18 з 18 каналів NVLink активні на кожній карті, ECC увімкнено, PCIe Gen 6 x16, на кожній карті зайнято 241 з 268,6 ГіБ під час обслуговування GLM-5.2 NVFP4 з тензорним паралелізмом 8.
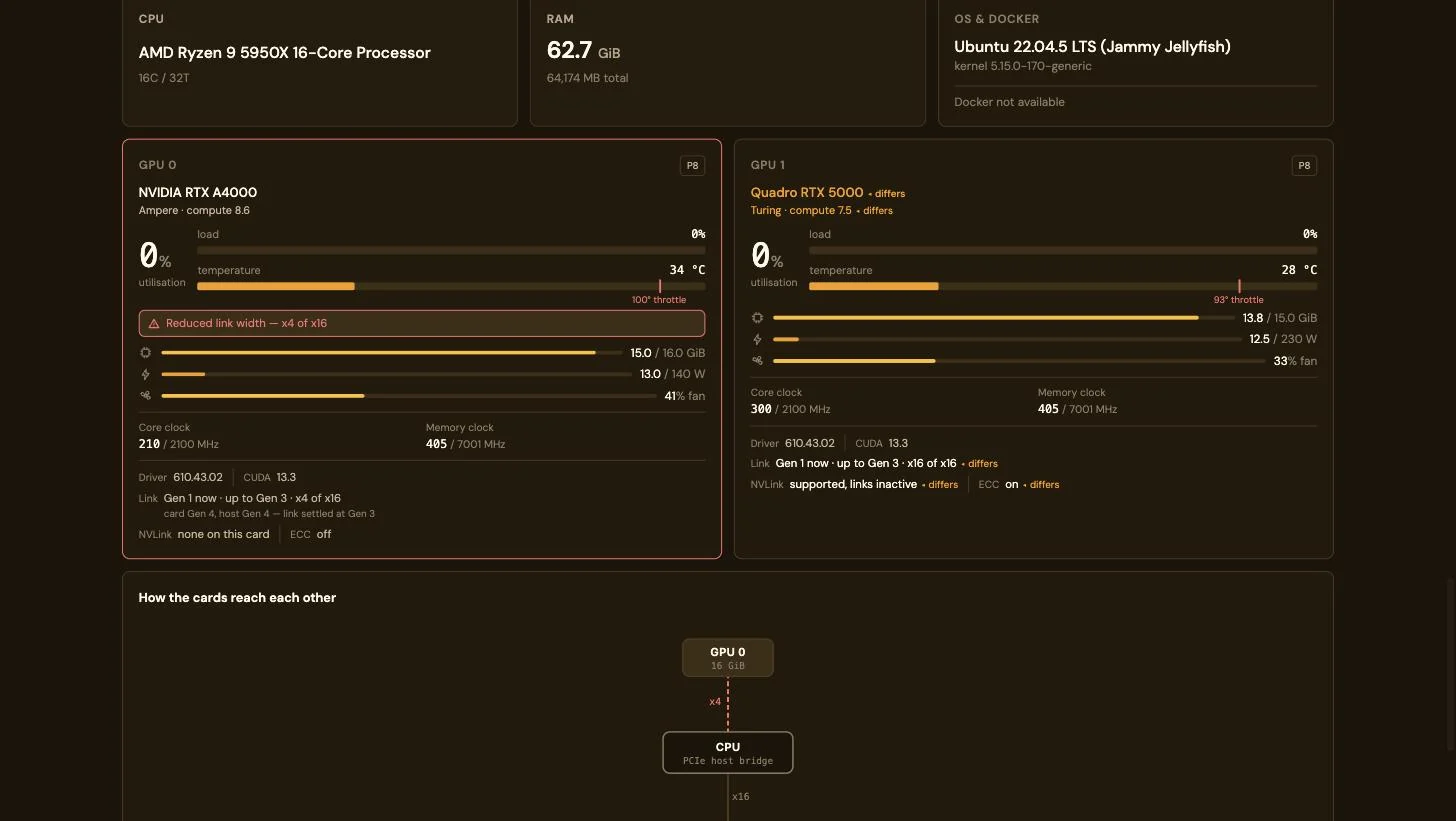
Два різні GPU: NVIDIA RTX A4000 з червоним попередженням Reduced link width x4 of x16 і Link Gen 1 зараз (максимум Gen 3), поруч із Quadro RTX 5000, у якої архітектуру, VRAM, обмеження потужності, з’єднання, NVLink і ECC позначено як differs; нижче — схема того, як карти з’єднані з CPU через канали x4 і x16
Дві карти, куплені з різницею в кілька років: з’єднання A4000 працює в режимі x4 замість x16 і позначене червоним; архітектуру, обмеження потужності, NVLink (підтримується, канали неактивні) та ECC у Quadro позначено як differs. Схема показує, на якому слоті знижено ширину з’єднання.
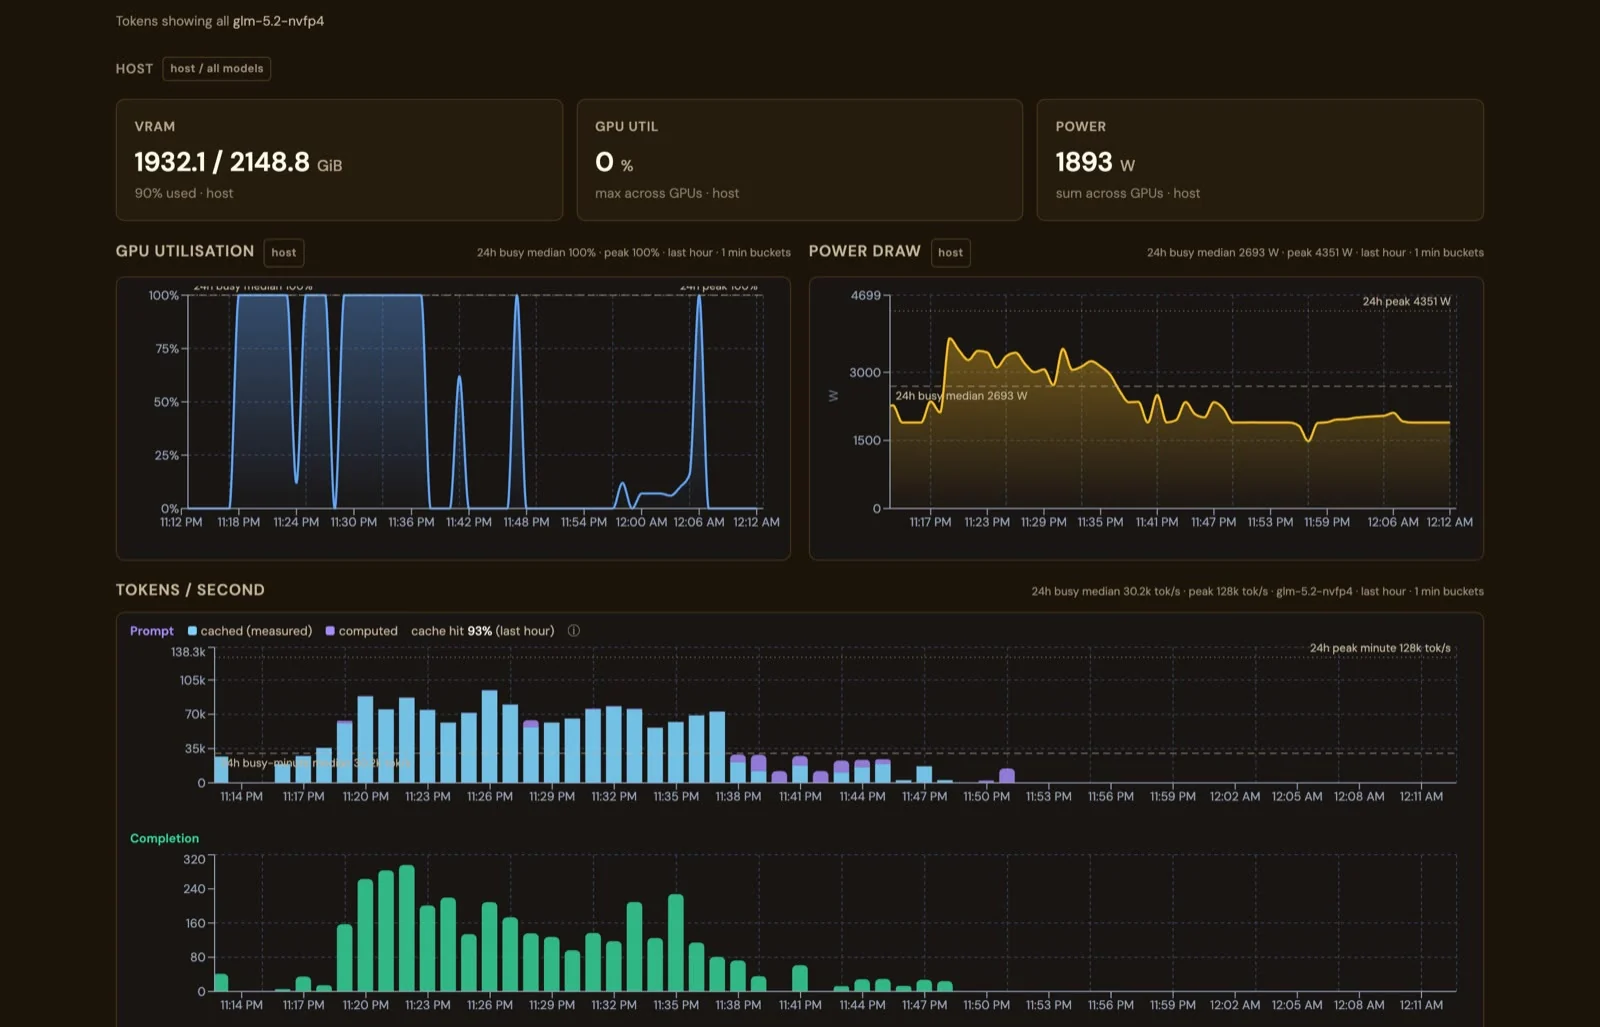
Stats на сервері 8 × B300: VRAM 1932,1 з 2148,8 ГіБ, потужність 1893 Вт сумарно за картами, використання GPU й споживана потужність за останню годину, а також токени промпту за секунду з поділом на кешовані й обчислені за 93 % влучань у кеш
Та сама сторінка Stats на верхньому краю діапазону: 1 932 з 2 149 ГіБ VRAM, 1 893 Вт на всіх картах, пік 4 351 Вт за годину і 93 % токенів промпту з кешу.
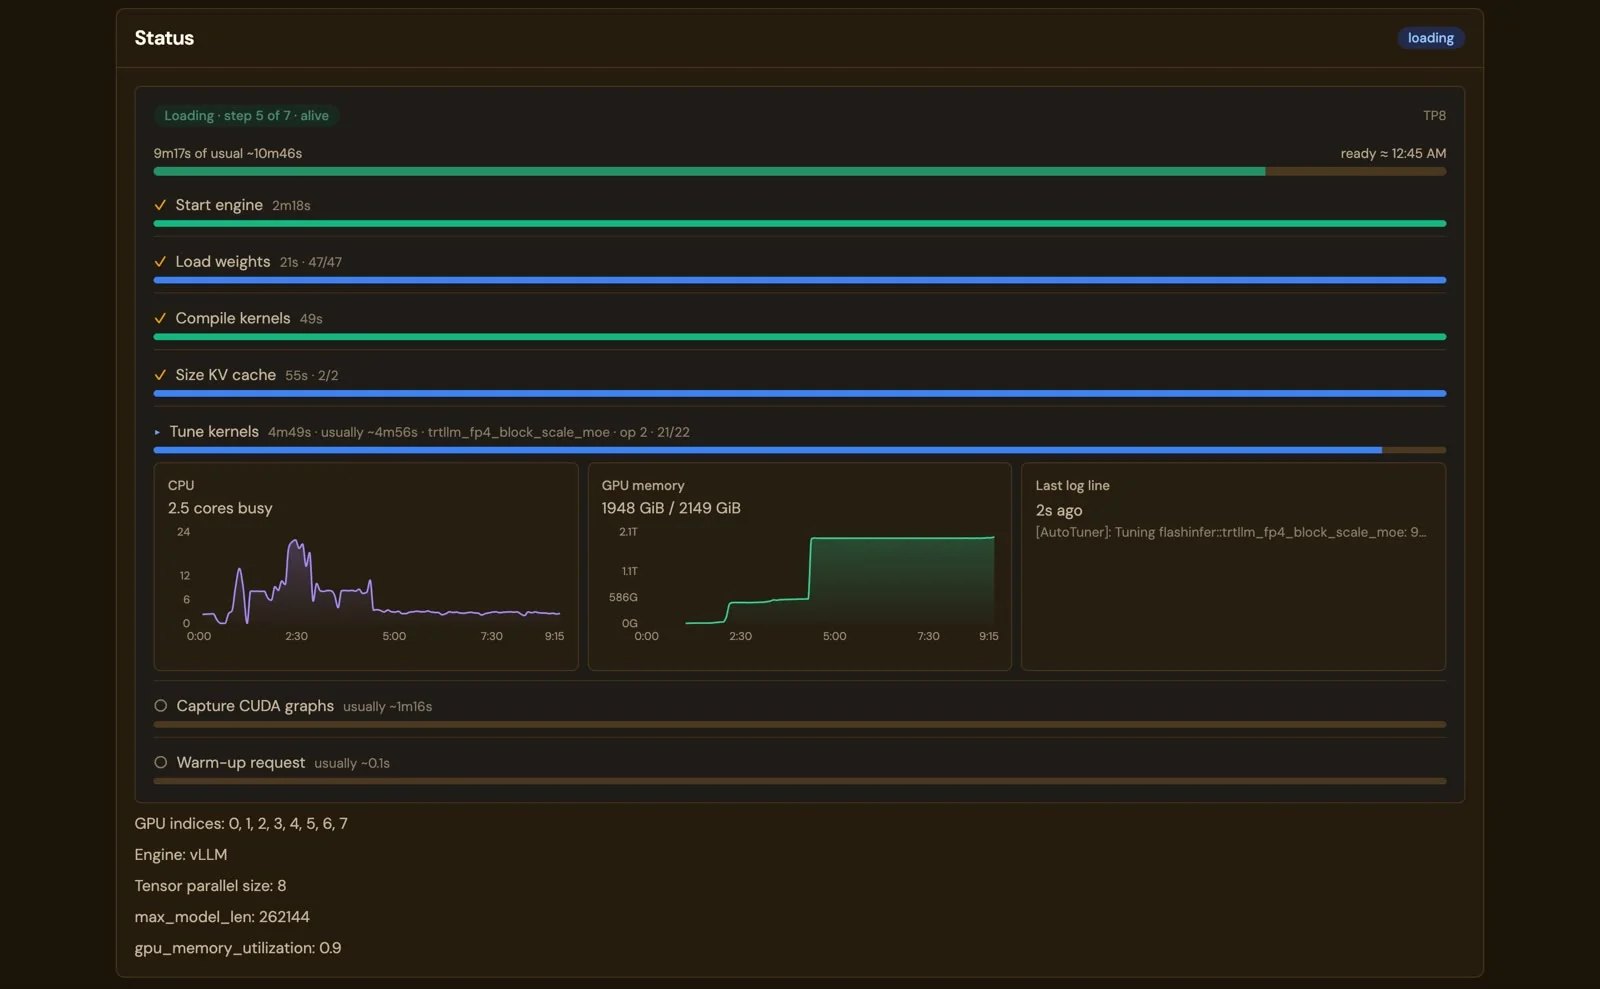
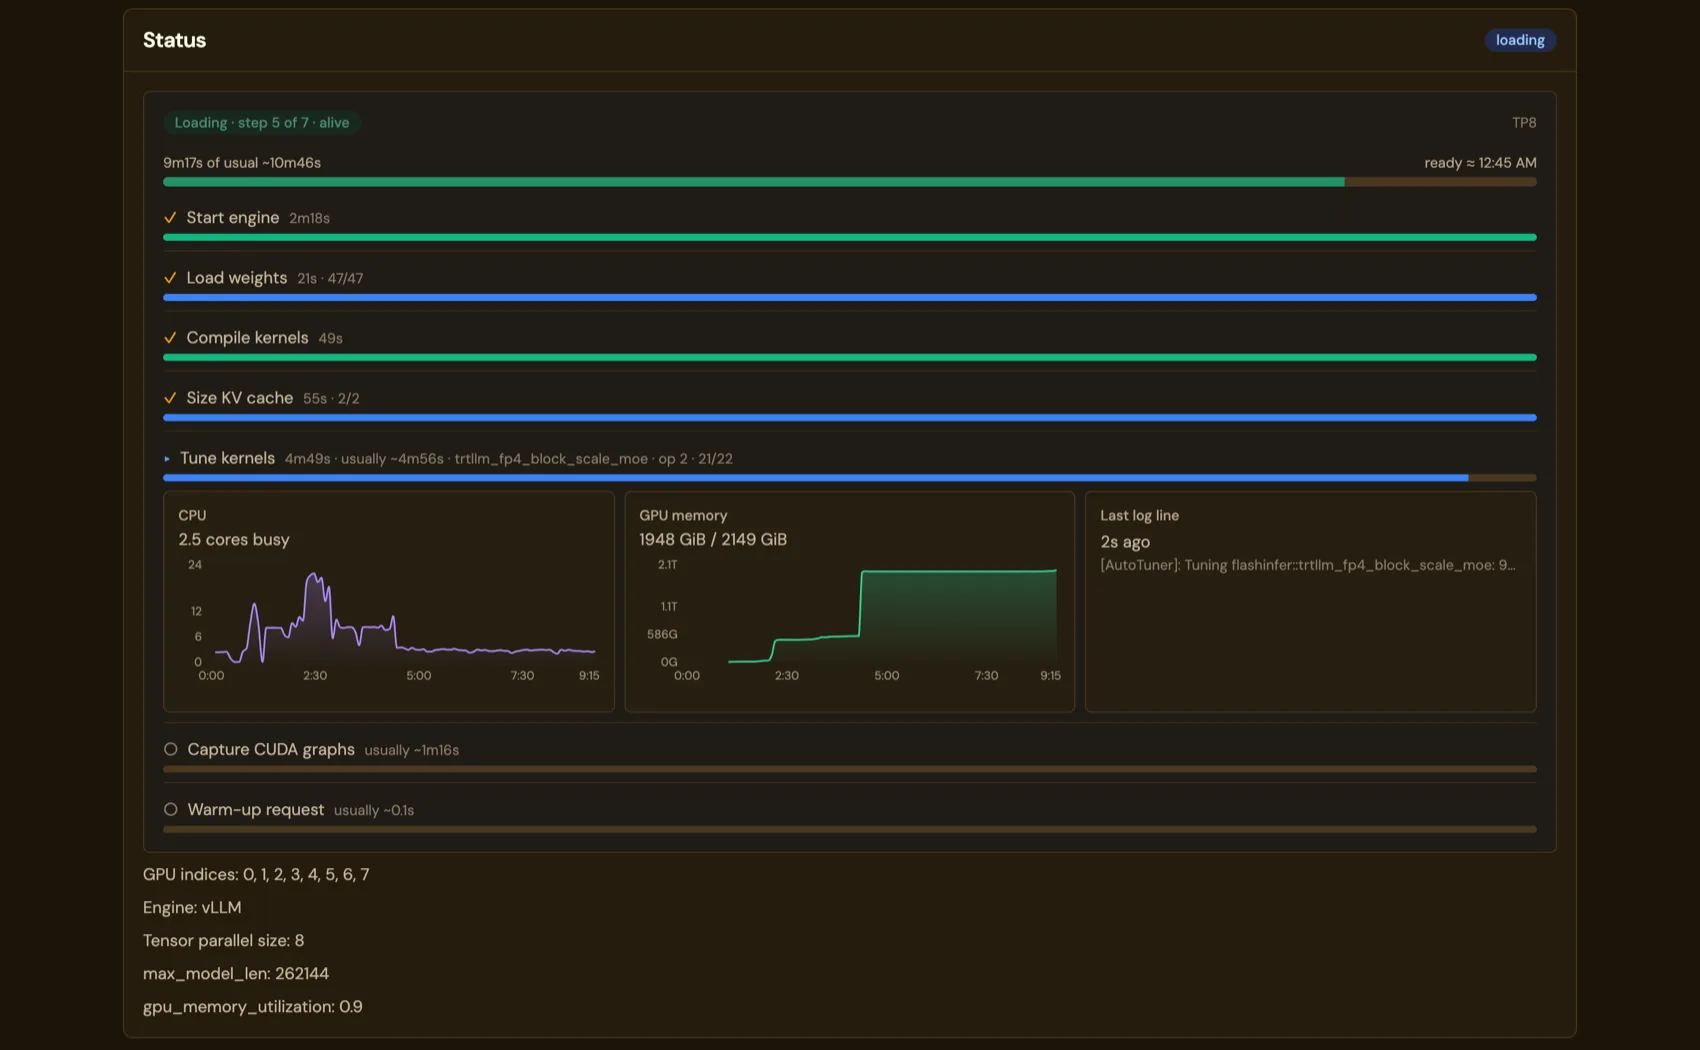
Сторінка моделі під час завантаження GLM-5.2 NVFP4 на восьми B300: 9 хв 17 с зі звичайних 10 хв 46 с, кроки Start engine, Load weights 47 of 47, Compile kernels і Size KV cache виконано, Tune kernels на операції 21 з 22, із графіками CPU й пам’яті GPU та останнім рядком журналу
Завантаження на 10 хвилин, крок за кроком: GLM-5.2 NVFP4 на восьми B300, 9 хв 17 с зі звичайних 10 хв 46 с, нічого червоного, доки процес просувається.

Що показує панель кожної карти: температуру відносно її власної точки тротлінгу, потужність відносно її ліміту, частоти, вентилятор, поточні покоління й ширину з’єднання PCIe, ECC і NVLink, якщо вони є в карти, і процес, що займає пам’ять. Схема з’єднань будується за nvidia-smi topo -m. На Mac: використання GPU й бюджет пам’яті, про який повідомляє Metal, без потужності. А за самим рушієм стежить його власний ендпоінт /health, а не таблиця процесів: якщо рушій перестав відповідати, а обгортка ще працює, модель перезавантажується, а діагностичні дані зберігаються.

Що він показує

Моніторинг GPU

Кожна карта — окремо.

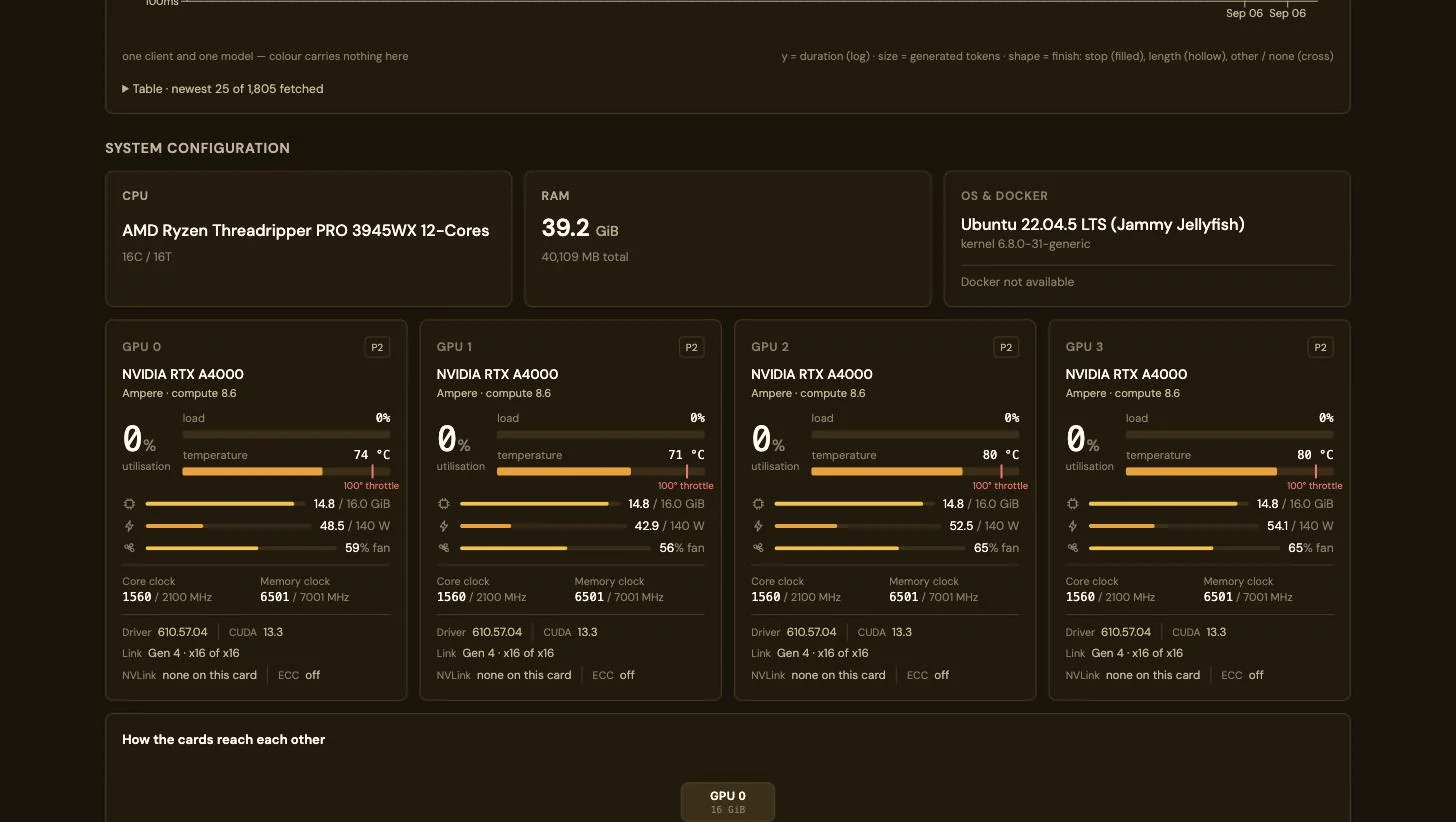
Використання, температура відносно точки тротлінгу цієї карти, потужність відносно її ліміту, VRAM, частоти, з’єднання PCIe і процес, що займає пам’ять. Не середнє для всього сервера.

Конфігурація системи й чотири панелі GPU для карт NVIDIA RTX A4000 з використанням, температурою, VRAM, потужністю, вентилятором і частотами кожної карти

Запити, що виконуються

Дивіться, що кожен агент робить саме зараз.

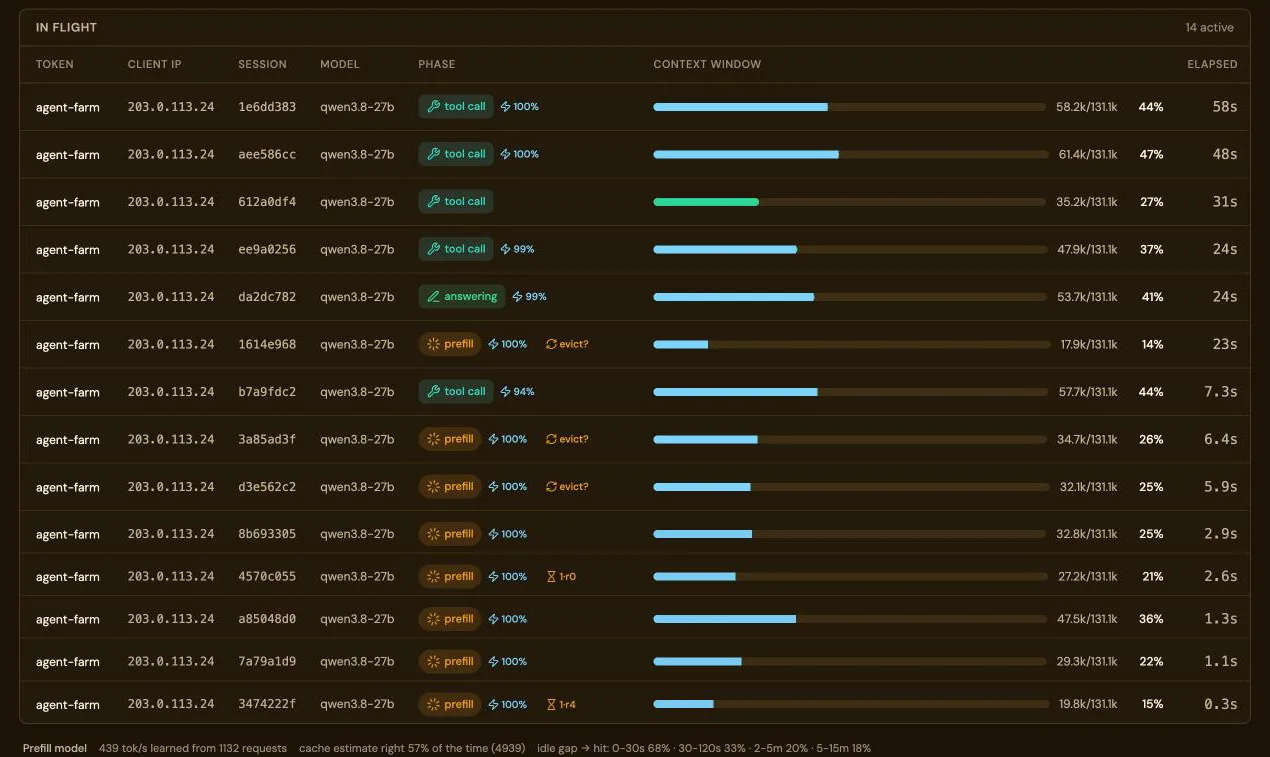
Кожен запит із ключем, сеансом і фазою: у черзі, prefill, міркування, виклик інструмента, відповідь. Яка частина кожного промпту надійшла з кешу префіксів — вимірюється для кожного запиту.

Таблиця запитів, що виконуються: десять активних запитів, у кожного ключ, сеанс, фаза й токени

Агенти для програмування

Claude Code, Codex і OpenCode підключаються з однієї сторінки.

Connect записує конфігурацію кожного інструмента з адресою цього LM Warden, ключем і завантаженою моделлю, звіряє вимоги з тим, що справді завантажено, і надсилає тестовий запит.

Сторінка Connect a client з вибраним Claude Code і перевіреними вимогами

Безкоштовний, з відкритим кодом і відкритою розробкою.

LM Warden поширюється за ліцензією Apache-2.0 на GitHub: скрипт інсталяції й файл Compose — це все розгортання, і обидва можна прочитати. Без облікового запису, без перевірки ліцензії, без телеметрії. vLLM, llama.cpp і MLX — сторонні проєкти, які ми запускаємо без змін.

mlx-rust-lm незабаром

Порт mlx-lm від Apple з Python на Rust на базі офіційного C-інтерфейсу Apple mlx-c, який розробляє й підтримує команда LM Warden як окремий проєкт із відкритим кодом. LM Warden використовуватиме його як третій рушій для Mac, і згодом він замінить рушій mlx-lm на Python, що становить більшу частину нинішнього завантаження для Mac. Неофіційний проєкт, не пов’язаний з Apple.