GPU-Monitoring: der Rechner hinter diesen Zahlen.
Sofern eine Bildunterschrift nichts anderes sagt, stammen die Werte auf dieser Seite von einer Workstation: vier RTX A4000, mit einem einzigen Modell über alle verteilt, ausgelastet mit unserem eigenen Testverkehr. Das sind die Zahlen, die die Konsole zeigte, während wir Abb. 1 und 5 aufzeichneten. Die Fit-Tests weiter unten verwendeten zusätzlich eine Quadro RTX 5000, was dort jeweils vermerkt ist.
Die Panels pro Karte lesen den NVIDIA-Treiber aus und gehören daher zur Linux-Installation. Auf einem Mac mit Apple Silicon zeigt die Mac-App (Beta) die GPU-Nutzung und das Speicherbudget, das Metal meldet, ohne Anzeige der Leistungsaufnahme.
- GPUs
- 4 × NVIDIA RTX A4000, je 16 GiB (Ampere, Compute 8.6)
- Belegter VRAM
- 59,4 von 64,0 GiB, ein Modell über alle vier Karten
- PCIe
- Gen 4 x16 pro Karte
- Treiber
610.57.04, CUDA 13.3
| Messwert | Bei Aufnahme | Median über 24 h (unter Last) | Spitze über 24 h |
|---|---|---|---|
| GPU-Auslastung, am stärksten belastete Karte (%) | 100 | 100 | 100 |
| GPU-Leistungsaufnahme, Summe der vier Karten (W) | 548 | 530 | 559 |
| Token pro Minute (Panel vom 23. Sep.) | nicht angezeigt | 190 Tsd. | 880 Tsd. |
Ihre Zahlen werden anders aussehen – genau deshalb lohnt es sich, sie zu messen. Die Token-Zeile stammt aus der Zeit vor der Umstellung auf Token pro Sekunde; das Stats-Panel stellt jetzt Token pro Sekunde dar, und diese Werte stammen aus der Aufnahme vom 23. September auf dem älteren Panel mit Werten pro Minute.
Was sich nicht messen lässt, wird als „nicht gemeldet“ angezeigt.
Die meisten GPU-Dashboards mitteln vier Karten zu einer Linie und stellen einen fehlenden Wert als 0 dar. Dieses Dashboard gibt jeder Karte ein eigenes Panel: Temperatur im Verhältnis zur Drosselschwelle, die ihr Treiber meldet, Leistungsaufnahme im Verhältnis zum eigenen Limit der Karte, Takte, Lüfter, die PCIe-Verbindung, wie sie gerade ausgehandelt ist, sowie ECC und NVLink, sofern die Karte sie hat. Zwei Karten, die achtzehn Monate auseinander gekauft wurden, bleiben zwei Karten, und ein Wert, den der Treiber nicht liefert, wird als fehlend gekennzeichnet, statt als Null dargestellt zu werden.
 Drosselschwelle vom Treiber, nicht geschätzt
Warum der Takt gesenkt wird, laut Treiber
Leistungsaufnahme im Verhältnis zum eigenen Limit von 140 W
NVLink und ECC, wie die Karte sie meldet
| Pro Karte | Temperatur und Drosselschwelle, Leistungsaufnahme und ihr Limit, Kern- und Speichertakt, Lüfter, PCIe-Generation und -Breite, ECC, NVLink und der Engine-Prozess, der die Karte nutzt |
|---|---|
| Pro Host | Belegter VRAM, GPU-Auslastung (die am stärksten belastete Karte), Leistungsaufnahme (Summe der Karten) und Token pro Sekunde |
| Pro Anfrage | Zeit bis zum ersten Token, Latenz zwischen Token und Dauer, für beide Engines auf dieselbe Weise am Proxy gemessen |
Worauf jede Anfrage wartet.
Die Stats-Seite listet jede laufende Anfrage mit der Sitzung des Clients und der Phase, in der sich die Anfrage befindet: in der Warteschlange des Wardens, Prefill (die Engine liest den Prompt), Nachdenken, Schreiben eines Tool-Aufrufs oder Antworten. Ein Badge gibt den Anteil des Prompts an, der wahrscheinlich im Cache des Replikats liegt. Dauert ein Prefill länger, als die gelernte Prefill-Rate dieses Rechners vorhersagt, wird angezeigt, warum er vermutlich wartet: weil andere Prompts auf demselben Replikat vor ihm liegen, weil der Cache vermutlich verdrängt wurde oder aus einem Grund, den der Warden nicht erkennen kann. Die Sitzung stammt aus der ID, die jedes Tool ohnehin sendet: bei Claude Code, Codex, OpenCode und pi ohne zusätzliche Konfiguration, bei Hermes und Aider mit einer Zeile Konfiguration.
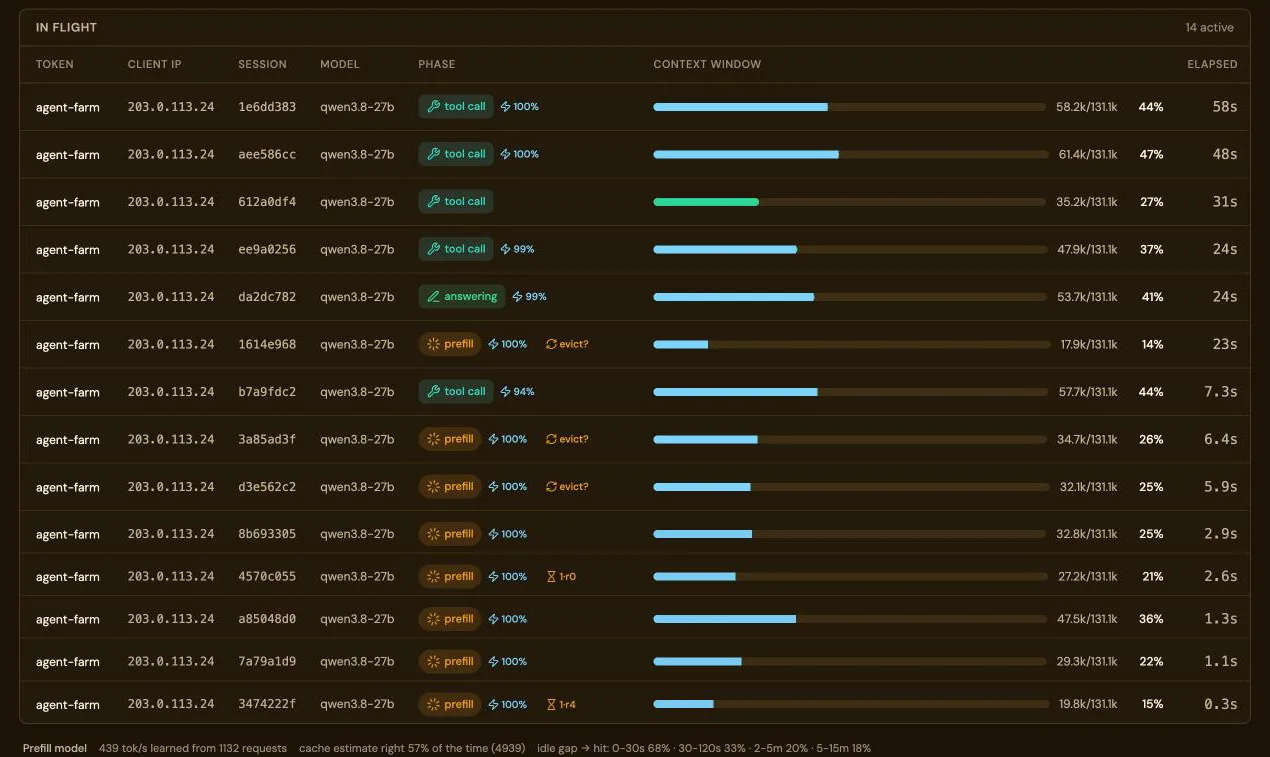 Noch kein Token, Cache wahrscheinlich verdrängt
Ein Prompt vor ihr auf Replikat 4