LM Warden

Kleinere Dinge, die Sie entdecken, sobald LM Warden läuft.

God mode
Verfolgen Sie die Prompts und Antworten eines Schlüssels in Echtzeit, über ein Panel auf seiner Seite. Nur im Arbeitsspeicher gehalten, nur gestreamt, solange das Panel offen ist, und aus, solange Sie VW_GODMODE_ENABLED nicht setzen.
Admin-Token
Mit vwa_-Token bedienen Skripte, CI und Agenten die Steuerungs-API ohne Admin-Passwort, Cookie-Verwaltung oder CSRF-Header. Einmal angezeigt, als SHA-256-Hash gespeichert.
Ein Manager für den HuggingFace-Cache
Was auf der Festplatte liegt und welchem Modell es gehört. Verwaiste Daten aufräumen und den gesamten Cache als Tarball exportieren oder importieren.
Ein Port
Die Oberfläche, die Steuerungs-API und /v1 teilen sich :8080. Ihr eigener TLS-Terminator, Ingress oder SSO lässt sich unverändert davorschalten.
Kein Internetzugang nötig
Drei Image-Tarballs und ein optionaler Tarball des Modell-Caches – mehr braucht ein vom Netz getrennter Host nicht. HF_HUB_OFFLINE=1 unterbindet sogar die Downloads der Gewichte.
Router-Statistik
Jede Entscheidung unter /router/stats: lokal, durchgereicht, zurückgefallen, abgelehnt, mit Grund, pro Regel und pro Ziel, und der Zustand des Circuit Breakers. Zähler pro Prozess; Header und Bodys werden nie gespeichert.
Eine Einrichtungsseite pro Client
Connect erzeugt die Einrichtung für Claude Code, Codex CLI, OpenCode, Aider, Grok CLI, die SDKs von Anthropic und OpenAI und drei Editoren, mit der Adresse dieses Wardens, einem Schlüssel und einem geladenen Modell, und sendet eine Testanfrage.
Codex CLI
Getestet am 5. Oktober 2026 mit Codex 0.160 gegen einen Warden: Aufrufe des Shell-Tools, eine Dateibearbeitung, die Sitzung blieb auf einem Replikat. Das Reasoning ist standardmäßig an; model_reasoning_effort = "none" schaltet es aus. Nur lokale Modelle: Router-Regeln gelten nicht.
Ein Chat-Playground
Testen Sie ein geladenes Modell im Browser-Chat, Bilder eingeschlossen, bevor Sie irgendjemandem einen Schlüssel geben.

Drei Lektionen, die wir teuer lernen mussten.

Die Engine ist an einem Tag viermal abgestürzt, und der Proxy schickte ihr weiterhin Anfragen.

Der Kern der vLLM-Engine stürzte ab, während der Wrapper vllm serve um ihn herum weiterlief; der Prozess wirkte also lebendig, und Anfragen wurden weiter an ihn geschickt. Jetzt fragt ein Watchdog den eigenen Endpunkt /health der Engine ab statt der Prozesstabelle. Wenn die Engine nicht mehr antwortet, sichert er die Diagnosedaten, darunter die letzten Logzeilen, und lädt das Modell neu.

Das Live-Log-Panel eines Modells unter Last: Zeilen des vLLM-API-Servers, die GET /metrics beantworten, POST /v1/chat/completions von einem Client, Engine-Zeilen mit 10 laufenden und 0 wartenden Anfragen und eine Zeile GET /health, alle mit 200 OK Die Abfrage des Watchdogs, von der Engine beantwortet
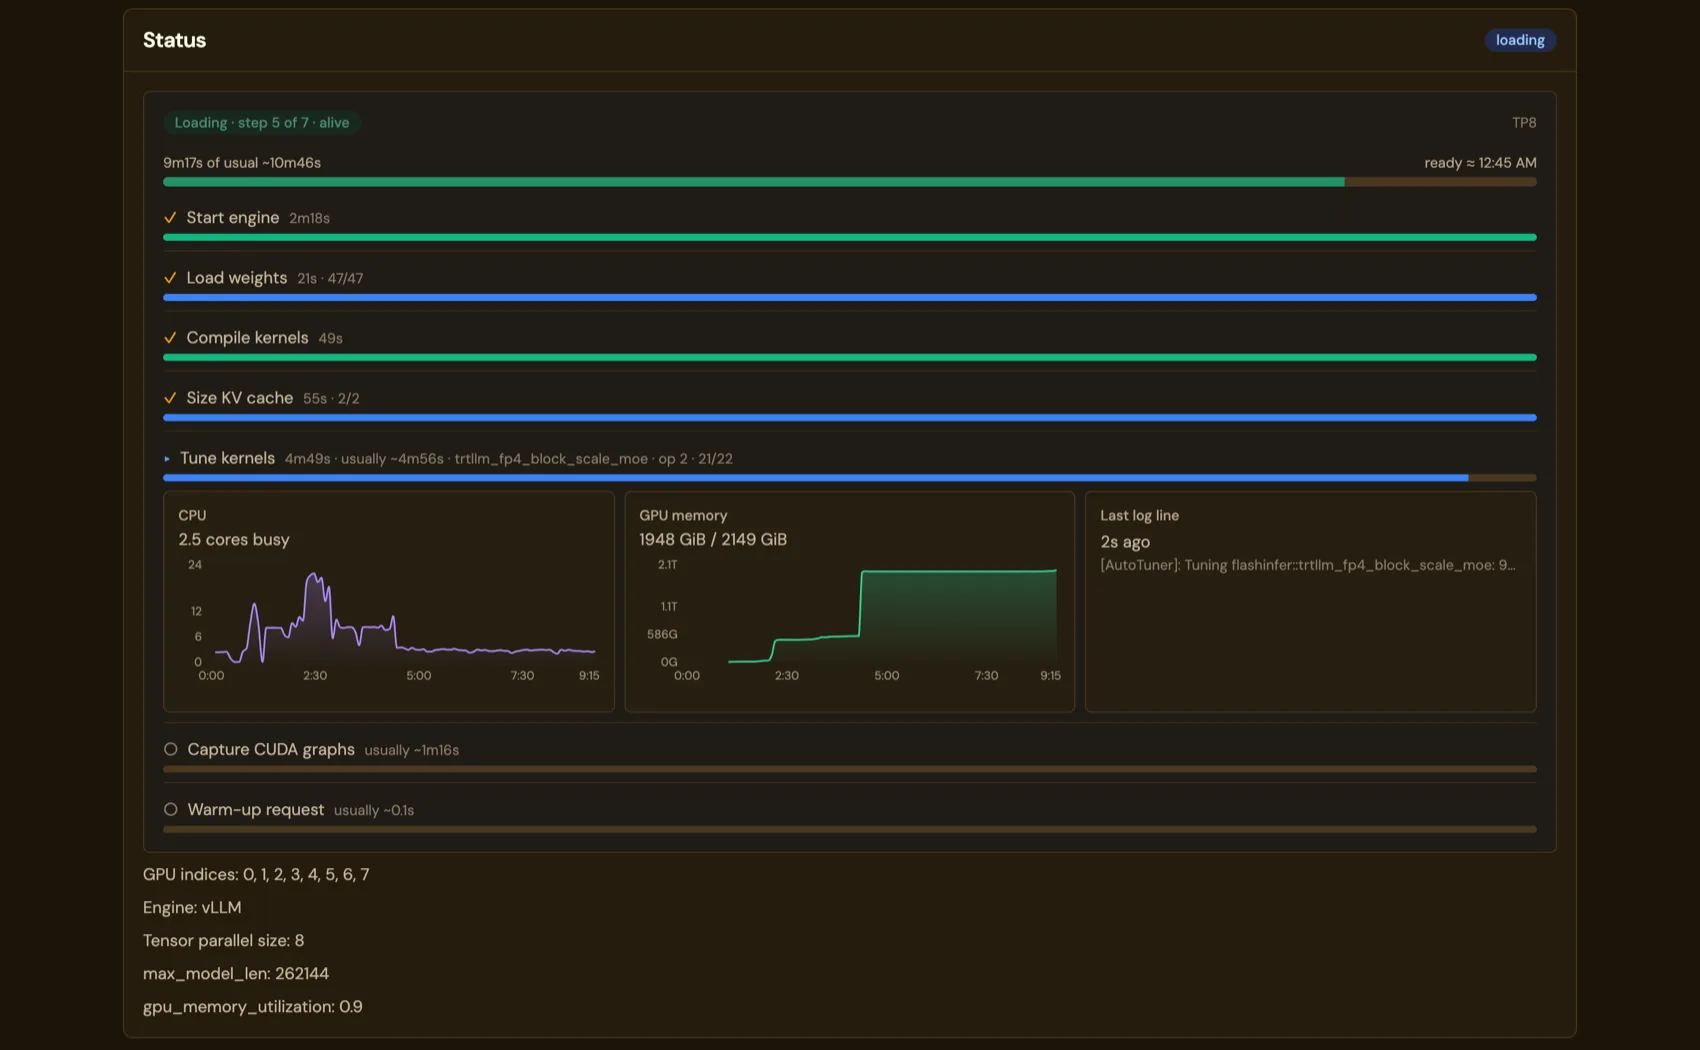
Abb. 15Das Live-Log auf der Seite eines Modells während derselben Last: Abrufe von /metrics, eingehende Chat Completions, die eigene Zählung der Engine von 10 laufenden und keiner wartenden Anfrage und dazwischen eine Abfrage von /health. Scrollen Sie das Bild seitlich, um die ganzen Zeilen zu lesen.

Ein Ladevorgang von 12 Minuten endete früher mit einem Fehler.

Ein großes Modell kann zwölf Minuten oder länger zum Laden brauchen. Bisher galt ein festes Zeitlimit: Lief es ab, schrieb der Warden einen roten Fehler „still loading“ in das Modell, obwohl die Engine weiterlud. Die Modellseite zeigt jetzt jeden Ladeschritt mit seinem Fortschrittsbalken, die übliche Dauer jedes Schritts aus früheren Ladevorgängen und die Vitalwerte von CPU und GPU-Speicher. Ein festgefahrener Ladevorgang wird gestoppt und seine GPUs freigegeben; nichts wird rot, solange ein Ladevorgang vorankommt. GLM-5.2 NVFP4 mit Tensor-Parallelität 8 auf acht NVIDIA B300 lädt in etwa 11 bis 12 Minuten; ein so langer Ladevorgang lief früher in das Timeout von 600 s.

Die Modellseite, während GLM-5.2 NVFP4 auf acht NVIDIA B300 lädt: 9 min 17 s von üblichen 10 min 46 s; Start engine, Load weights 47 von 47, Compile kernels und Size KV cache erledigt; Tune kernels bei Op 2, 21 von 22; Diagramme von CPU und GPU-Speicher mit 1948 von 2149 GiB belegt; Capture CUDA graphs und Warm-up request stehen noch aus, jeweils mit ihrer üblichen Dauer
Abb. 16GLM-5.2 NVFP4 lädt mit Tensor-Parallelität 8 auf acht B300, neun Minuten nach Beginn. Das Kernel-Tuning ist der lange Schritt; die Diagramme zeigen, dass die Engine lebt, während das Log nur den Tuning-Fortschritt wiederholt.

Eine Karte mit 16 GiB fasst weniger, als die Rechnung vermuten lässt.

Die Gewichte eines 8B-Modells in bf16 sind allein etwa 15 GiB groß, und beim Laden geht ihm der Speicher aus. Wir haben jede Zeile unten auf Karten vom Typ RTX A4000 und Quadro RTX 5000 mit 16 GiB ausprobiert und anhand der Antworten des Modells im Chat-Playground beurteilt, statt uns auf einen Health-Check zu verlassen.

ModellWas funktioniertWas nicht funktioniert
openai/gpt-oss-20bZwei Karten, Tensor-Parallelität 2, max_model_len 32000, gpu_memory_utilization 0,7 bis 0,9Eine Karte: Das 20B-MoE passt nicht
Llama 3.1 8B, Klasse Mistral 7BEine Karte, mit einem AWQ-INT4-Checkpoint, --enforce-eager und gpu_memory_utilization 0,9Das bf16-Repo: etwa 15 GiB Gewichte, Speicher beim Laden erschöpft
Zwei Modelle gleichzeitigEin Modell pro Karte, jedes passt auf seine eigene KarteZwei Modelle auf einer gemeinsamen Karte

Geprüft mit vLLM 0.20.0. Die Replikat-Messungen oben verwendeten 0.26.0. Dieses Release liefert 0.32.0 aus; der erste damit gemessene Ladevorgang ist GLM-5.2 NVFP4 mit Tensor-Parallelität 8 auf acht B300, etwa 11 bis 12 Minuten. Die Regeln zur Passung wurden mit 0.32 nicht neu gemessen. Die vollständige Tabelle und die Gründe dahinter stehen in HAZARDS.md. Keine NVIDIA-GPU? Für Apple Silicon gibt es eine Mac-Beta, Windows kommt als Nächstes, und weitere GPUs stehen auf der Roadmap.