LM Warden

Detalhes menores que você descobre depois que ele está rodando.

God mode
Acompanhe os prompts e as respostas de uma chave enquanto acontecem, em um painel na página dela. Guardado só em memória, transmitido só enquanto o painel está aberto, e desligado a menos que você defina VW_GODMODE_ENABLED.
Tokens de administrador
Os tokens vwa_ permitem que scripts, CI e agentes usem a API de controle sem a senha de administrador, sem cookies de sessão e sem cabeçalho CSRF. São exibidos uma única vez e armazenados como hash SHA-256.
Um gerenciador do cache HuggingFace
O que está no disco e qual modelo é dono de cada coisa. Limpe os órfãos e exporte ou importe o cache inteiro como tarball.
Uma porta
A interface, a API de controle e o /v1 compartilham :8080. O seu próprio terminador TLS, ingress ou SSO pode ficar na frente dele sem nenhuma alteração.
Sem precisar de saída para a internet
Três tarballs de imagens e um tarball opcional do cache de modelos são tudo o que você precisa levar para um host isolado da rede (air-gapped). HF_HUB_OFFLINE=1 impede até os downloads de pesos.
Estatísticas do Router
Cada decisão em /router/stats: local, repassada, desviada, recusada, com o motivo, por regra e por destino, e o estado do disjuntor. Os contadores são por processo; cabeçalhos e corpos nunca são registrados.
Uma página de configuração por cliente
O Connect grava a configuração para Claude Code, Codex CLI, OpenCode, Aider, Grok CLI, os SDKs da Anthropic e da OpenAI e três editores, com o endereço deste warden, uma chave e um modelo carregado, e envia uma solicitação de teste.
Codex CLI
Testado com um warden em 5 de outubro de 2026 com o Codex 0.160: chamadas de ferramenta de shell, uma edição de arquivo, a sessão mantida em uma réplica. O raciocínio vem ligado por padrão; model_reasoning_effort = "none" o desliga. Só modelos locais: as regras do roteador não se aplicam.
Um playground de chat
Converse com um modelo carregado no navegador, inclusive com imagens, antes de entregar uma chave a alguém.

Três coisas que aprendemos do jeito difícil.

O mecanismo morreu quatro vezes em um dia, e o proxy continuou encaminhando para ele.

O núcleo do mecanismo vLLM travou enquanto o wrapper vllm serve em volta dele continuava no ar, então o processo parecia vivo e as solicitações continuavam sendo enviadas a ele. Agora um watchdog consulta o próprio endpoint /health do mecanismo em vez da tabela de processos. Quando o mecanismo para de responder, o watchdog guarda as evidências, incluindo as últimas linhas do log (em quantidade limitada), e recarrega o modelo.

O painel de log ao vivo de um modelo sob carga: linhas do servidor de API do vLLM respondendo a GET /metrics, POST /v1/chat/completions de um cliente, linhas do mecanismo informando 10 solicitações em execução e 0 em espera, e uma linha GET /health, todas retornando 200 OK A checagem do watchdog, respondida pelo mecanismo
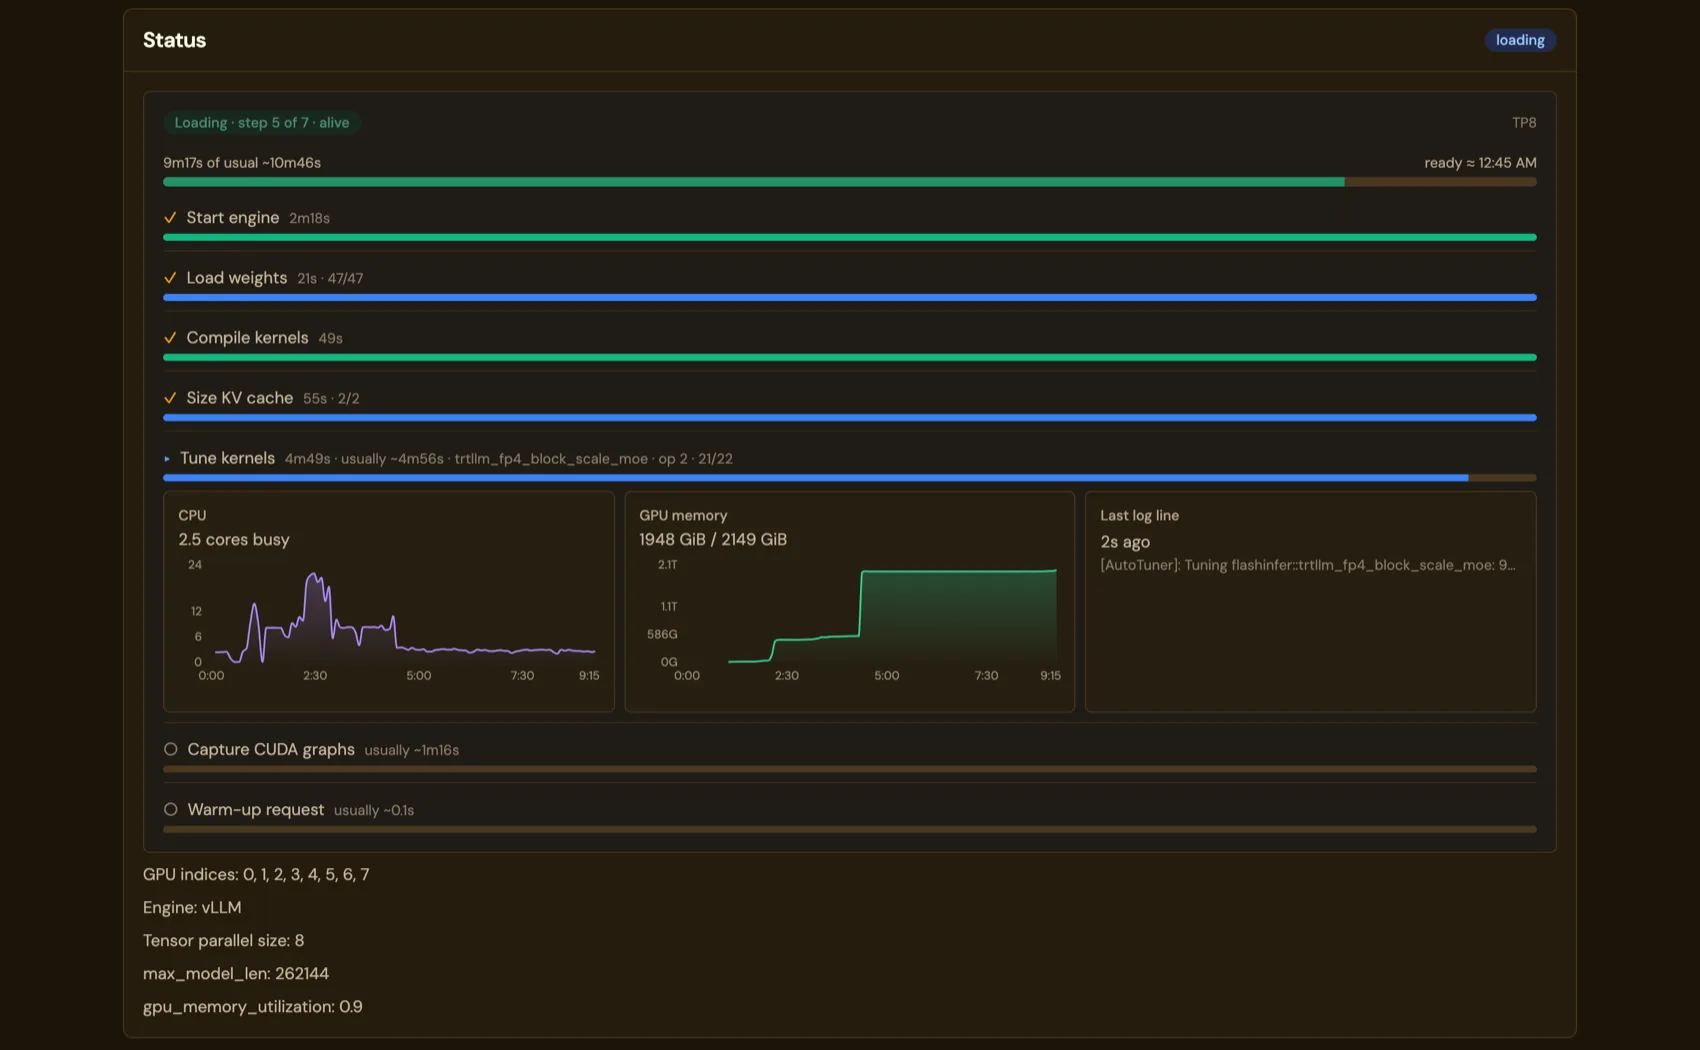
Fig. 15O log ao vivo na página de um modelo durante a mesma carga: coletas de /metrics, chat completions chegando, a contagem do próprio mecanismo de 10 solicitações em execução e nenhuma em espera, e uma checagem /health entre elas. Role a imagem para o lado para ler as linhas inteiras.

Um carregamento de 12 minutos costumava terminar em erro.

Um modelo grande pode levar doze minutos ou mais para carregar. Antes, o warden usava um tempo limite fixo: ao expirar, gravava no modelo um erro vermelho “still loading”, embora o mecanismo continuasse carregando. A página do modelo agora mostra cada etapa do carregamento com a sua barra de progresso, o tempo habitual de cada uma em carregamentos anteriores, e os sinais vitais de CPU e de memória da GPU. Um carregamento travado é interrompido e as GPUs dele são liberadas; nada fica vermelho enquanto um carregamento ainda avança. GLM-5.2 NVFP4 com paralelismo de tensores 8 em oito NVIDIA B300 carrega em cerca de 11 a 12 minutos; um carregamento desse tamanho costumava esbarrar no timeout de 600 s.

A página do modelo enquanto o GLM-5.2 NVFP4 carrega em oito NVIDIA B300: 9 min 17 s de um tempo habitual de 10 min 46 s; Start engine, Load weights 47 de 47, Compile kernels e Size KV cache concluídos; Tune kernels na op 2, 21 de 22; gráficos de CPU e de memória da GPU com 1948 de 2149 GiB em uso; Capture CUDA graphs e Warm-up request ainda por vir, cada um com o seu tempo habitual
Fig. 16GLM-5.2 NVFP4 carregando com paralelismo de tensores 8 em oito B300, aos nove minutos. O ajuste de kernels é a etapa longa; os gráficos mostram que o mecanismo está vivo enquanto o log só repete o progresso do ajuste.

Uma placa de 16 GiB comporta menos do que a aritmética diz.

Os pesos de um modelo bf16 8B ocupam cerca de 15 GiB por si só, e o modelo fica sem memória durante o carregamento. Testamos cada linha abaixo em placas RTX A4000 e Quadro RTX 5000 de 16 GiB e avaliamos o resultado lendo as respostas do modelo no playground de chat, sem confiar em uma verificação de saúde.

ModeloO que funcionaO que não funciona
openai/gpt-oss-20bDuas placas, paralelismo de tensores 2, max_model_len 32000, gpu_memory_utilization de 0,7 a 0,9Uma placa: o MoE de 20B não cabe
Llama 3.1 8B, classe Mistral 7BUma placa, com um checkpoint AWQ-INT4, --enforce-eager e gpu_memory_utilization 0,9O repositório bf16: cerca de 15 GiB de pesos, sem memória durante o carregamento
Dois modelos ao mesmo tempoUm modelo por placa, cada um cabendo na própria placaDois modelos dividindo uma placa

Verificado com o vLLM 0.20.0. As medições de réplicas acima usaram o 0.26.0. Esta versão traz o 0.32.0; o primeiro carregamento cronometrado nele é o GLM-5.2 NVFP4 com paralelismo de tensores 8 em oito B300, cerca de 11 a 12 minutos. As regras sobre o que cabe em cada placa não foram medidas de novo no 0.32. A tabela completa e os motivos por trás dela estão em HAZARDS.md. Não usa NVIDIA? Para Mac com chip Apple, há uma versão beta, o Windows é o próximo e outras GPUs estão no roadmap.