LM Warden

Detalles que irás descubriendo cuando esté en marcha.

God mode
Observa los prompts y las respuestas de una clave en tiempo real, desde un panel en su página. Solo se guardan en memoria y solo se transmiten mientras el panel está abierto; la función está desactivada a menos que definas VW_GODMODE_ENABLED.
Tokens de administrador
Los tokens vwa_ permiten que scripts, sistemas de CI y agentes usen la API de control sin la contraseña de administrador, sin gestionar cookies y sin encabezado CSRF. Se muestran una sola vez y se guardan como hash SHA-256.
Un gestor de la caché de HuggingFace
Qué hay en el disco y a qué modelo pertenece. Elimina los archivos huérfanos y exporta o importa toda la caché como archivo tar.
Un solo puerto
La interfaz, la API de control y /v1 comparten :8080. Puedes poner delante tu propio terminador TLS, ingress o SSO sin cambiar nada.
Sin salida a internet
Tres archivos tar de imágenes y, opcionalmente, uno con la caché de modelos son todo lo que hay que llevar a un host aislado de la red. HF_HUB_OFFLINE=1 impide incluso la descarga de pesos.
Estadísticas del Router
Cada decisión en /router/stats: local, reenviada, desviada por fallo o rechazada, con el motivo, por regla y por destino, y el estado del disyuntor. Contadores por proceso; nunca se guarda ningún encabezado ni cuerpo de solicitud.
Una página de configuración por cliente
Connect genera la configuración para Claude Code, Codex CLI, OpenCode, Aider, Grok CLI, los SDK de Anthropic y OpenAI y tres editores, con la dirección de este warden, una clave y un modelo cargado, y envía una solicitud de prueba.
Codex CLI
Probado con un warden el 5 de octubre de 2026 con Codex 0.160: llamadas a la herramienta de shell, edición de un archivo y la sesión mantenida en una misma réplica. El razonamiento está activado de forma predeterminada; model_reasoning_effort = "none" lo desactiva. Solo modelos locales: las reglas del enrutador no se aplican.
Un chat de pruebas
Habla con un modelo cargado desde el navegador, con imágenes incluidas, antes de darle una clave a nadie.

Tres cosas que aprendimos por las malas.

El motor se cayó cuatro veces en un día y el proxy seguía enviándole solicitudes.

El núcleo del motor vLLM fallaba mientras el proceso vllm serve que lo envuelve seguía en marcha, así que el proceso parecía vivo y se le seguían enviando solicitudes. Ahora un watchdog consulta el propio punto de conexión /health del motor en lugar de la tabla de procesos. Cuando el motor deja de responder, conserva los datos de diagnóstico, incluidas las últimas líneas del registro, y vuelve a cargar el modelo.

El panel de registro en directo de un modelo con carga: líneas del servidor de API de vLLM que responden a GET /metrics y a POST /v1/chat/completions de un cliente, líneas del motor que indican 10 solicitudes en ejecución y 0 en espera, y una línea GET /health, todas con 200 OK La comprobación del watchdog, respondida por el motor
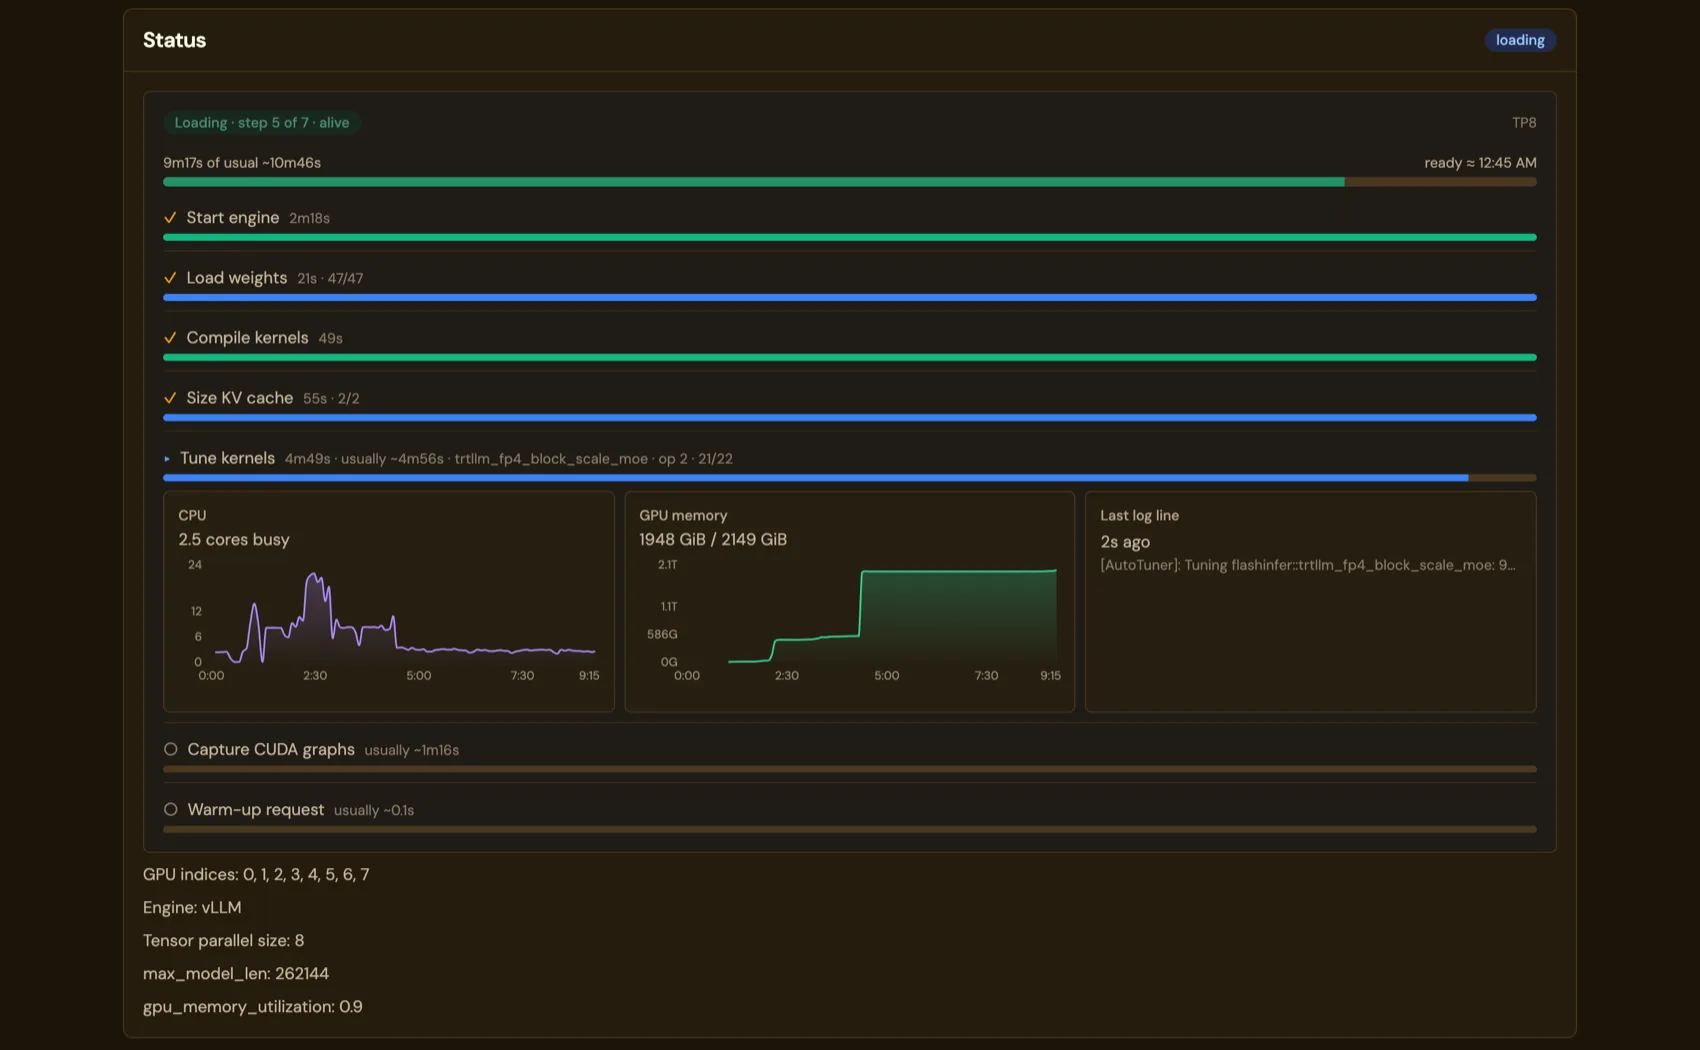
Fig. 15El registro en directo en la página de un modelo durante la misma carga: lecturas de /metrics, solicitudes de chat completions entrantes, el recuento del propio motor de 10 solicitudes en ejecución y ninguna en espera, y una comprobación de /health entre ellas. Desplaza la imagen lateralmente para leer las líneas completas.

Una carga de 12 minutos antes acababa en error.

Un modelo grande puede tardar doce minutos o más en cargarse. Antes, el warden aplicaba un tiempo límite fijo: al vencer, marcaba el modelo con un error rojo «still loading», aunque el motor siguiera cargando. Ahora la página del modelo muestra cada paso de la carga con su barra de progreso, el tiempo habitual de cada uno según cargas anteriores y las constantes vitales de CPU y memoria de GPU. Una carga atascada se detiene y sus GPU quedan libres; nada se pone en rojo mientras la carga siga avanzando. GLM-5.2 NVFP4 con paralelismo de tensores 8 en ocho NVIDIA B300 se carga en unos 11 a 12 minutos; una carga tan larga antes superaba el tiempo de espera de 600 s.

La página del modelo mientras GLM-5.2 NVFP4 se carga en ocho NVIDIA B300: a los 9 min 17 s de unos 10 min 46 s habituales; Start engine, Load weights 47 de 47, Compile kernels y Size KV cache terminados; Tune kernels en la op 2, 21 de 22; gráficos de CPU y memoria de GPU con 1948 de 2149 GiB en uso; Capture CUDA graphs y Warm-up request aún pendientes, cada uno con su tiempo habitual
Fig. 16GLM-5.2 NVFP4 cargándose con paralelismo de tensores 8 en ocho B300, a los nueve minutos. La optimización de kernels es el paso más largo; los gráficos muestran que el motor sigue vivo aunque el registro solo repita el progreso de esa optimización.

En una tarjeta de 16 GiB cabe menos de lo que dicen las cuentas.

Los pesos de un modelo bf16 8B ocupan por sí solos unos 15 GiB, y la carga se queda sin memoria. Probamos cada fila de abajo en tarjetas RTX A4000 y Quadro RTX 5000 de 16 GiB y la evaluamos leyendo las respuestas del modelo en el chat de pruebas, no fiándonos de una comprobación de estado.

ModeloLo que funcionaLo que no funciona
openai/gpt-oss-20bDos tarjetas, paralelismo de tensores 2, max_model_len 32000, gpu_memory_utilization de 0,7 a 0,9Una tarjeta: el MoE 20B no cabe
Llama 3.1 8B, clase Mistral 7BUna tarjeta, con un checkpoint AWQ-INT4, --enforce-eager y gpu_memory_utilization 0,9El repositorio bf16: unos 15 GiB de pesos; se queda sin memoria durante la carga
Dos modelos a la vezUn modelo por tarjeta, cada uno cabiendo en la suyaDos modelos compartiendo una tarjeta

Comprobado con vLLM 0.20.0. Las mediciones de réplicas de arriba usaron la 0.26.0. Esta versión incluye la 0.32.0; la primera carga cronometrada con ella es la de GLM-5.2 NVFP4 con paralelismo de tensores 8 en ocho B300: unos 11 a 12 minutos. Las reglas de capacidad no se han vuelto a medir con la 0.32. La tabla completa y sus motivos están en HAZARDS.md. ¿No tienes NVIDIA? Para chips de Apple hay una beta para Mac, Windows es lo siguiente y otras GPU están en la hoja de ruta.