LM Warden

Suas GPUs funcionando como uma API hospedada.

O LM Warden executa vLLM, llama.cpp ou MLX no seu próprio hardware e expõe um único endpoint compatível com OpenAI: uma chave por app, uso por chave e um painel em tempo real para cada GPU. Em uma máquina Linux com placas NVIDIA ou em um Mac com chip Apple.

Código aberto, Apache-2.0Sem conta, sem telemetriaLinux + NVIDIA · macOS (beta) · Windows é o próximo

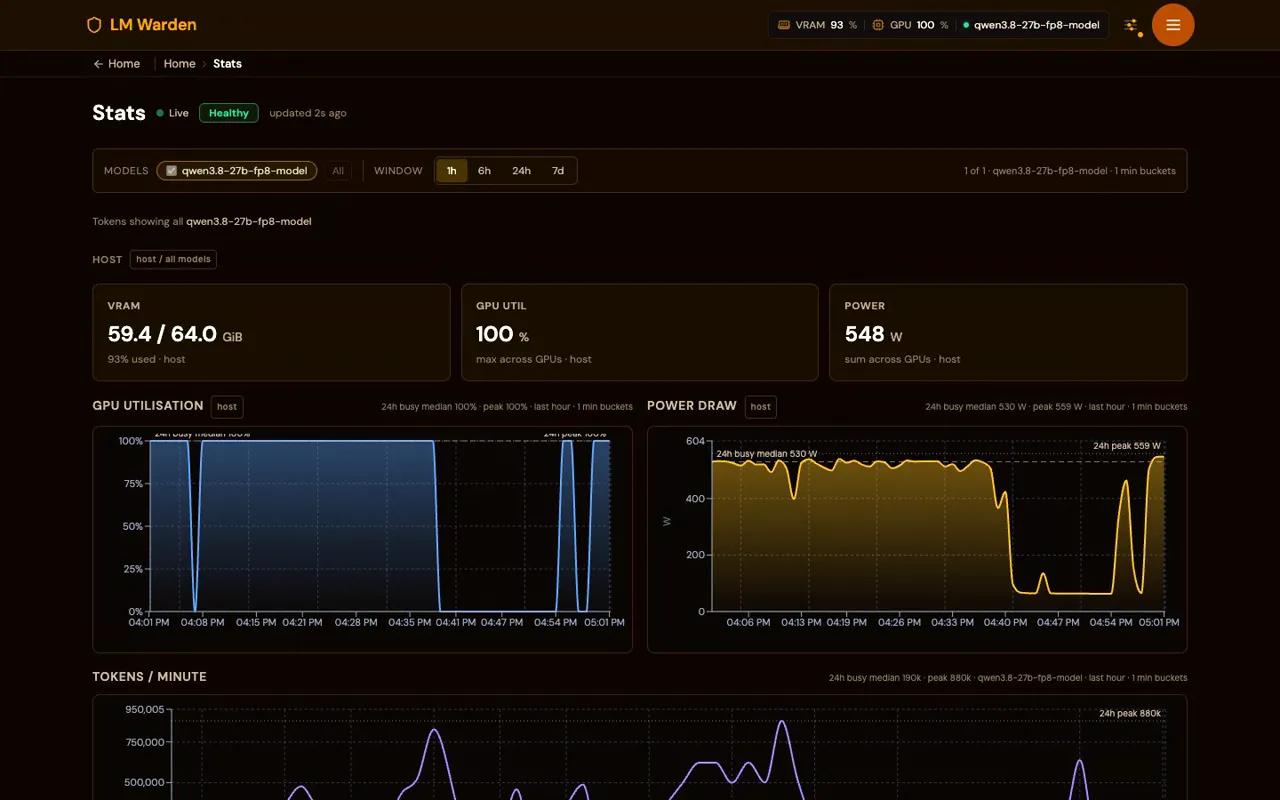
A página Stats de uma instância do LM Warden sob carga: VRAM 59,4 de 64 GiB, utilização da GPU 100%, potência 548 W e gráficos de utilização da GPU, consumo de energia e tokens por minuto na última hora
  • Linux · NVIDIA vLLM v0.32.0 e llama.cpp b11719 com CUDA
  • macOS · chip Apple MLX e llama.cpp com Metal
  • API OpenAI, Anthropic Messages e Responses em uma só porta
  • Agentes de programação Claude Code, Codex CLI, OpenCode e mais 7 já configurados

Para que as pessoas usam o LM Warden

Onde você vai executá-lo?

Escolha uma plataforma acima para ver as etapas ou mostre as quatro.

Um único comando no host com GPU.

curl -fsSL https://raw.githubusercontent.com/Podwarden/lm-warden/main/install.sh | sh -s -- --dir /opt/vllm-warden
  • Host x86_64, Docker Compose v2.24+, o NVIDIA Container Toolkit e uma placa Turing ou mais recente.
  • Depois abra http://HOST:8080/ui/, conclua o assistente de primeira execução, adicione um modelo e gere uma chave. Seu endpoint é http://HOST:8080/v1.
  • Várias GPUs em uma máquina: paralelismo de tensores ou uma réplica por placa com roteamento orientado a cache.
  • NVIDIA hoje. O suporte a GPUs AMD ROCm e Intel chega em breve; ainda sem datas. Conte para nós em qual você usaria: Radeon · Intel.
  • Guia de instalação · Offline / isolado · Do código-fonte · Atualização
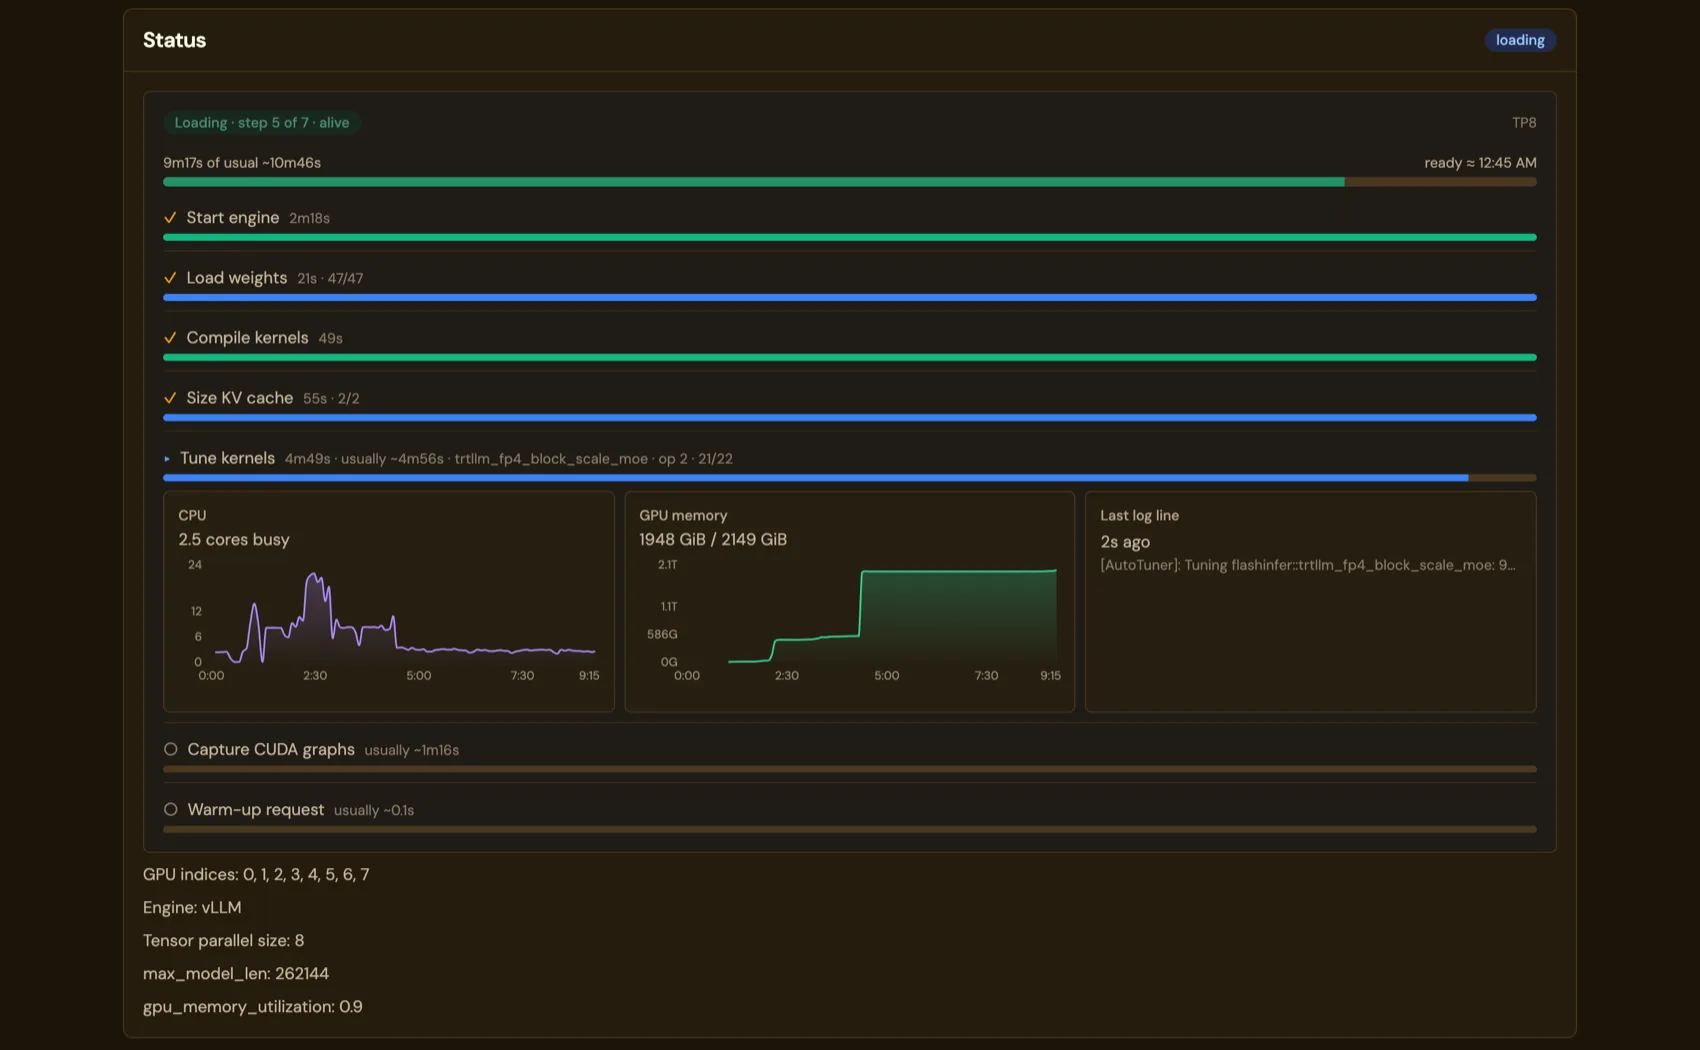
Um carregamento de modelo em andamento na página Models, cada etapa com o tempo decorrido e o tempo habitual
Um modelo carregando após a instalação: cada etapa com o tempo habitual de carregamentos anteriores.

Um app da barra de menus, em beta.

Baixar para Mac (beta)

  • Cerca de 110 MB. Mac com chip Apple (M1 ou posterior), macOS 14 ou posterior. SHA-256 · notas da versão.
  • Mecanismos: MLX e llama.cpp compilados com Metal. O mesmo painel e a mesma API OpenAI; sem vLLM, sem leitura de potência.
  • O que significa ser beta: assinado ad hoc e não notarizado, então, na primeira execução, o macOS pede que você o autorize em Privacidade e Segurança; para atualizar, é preciso baixar de novo. Como abrir pela primeira vez.
  • Escuta apenas em 127.0.0.1 até você escolher Share on Local Network.
  • Em breve: mlx-rust-lm, um terceiro mecanismo. A equipe do LM Warden está portando o mlx-lm da Apple de Python para Rust, sobre os bindings oficiais mlx-c da Apple; ele vai rodar ao lado do MLX e do llama.cpp e, com o tempo, substituir o mecanismo mlx-lm em Python, que, junto com o Python e as suas bibliotecas, ocupa a maior parte do download atual. Não oficial, sem afiliação com a Apple.
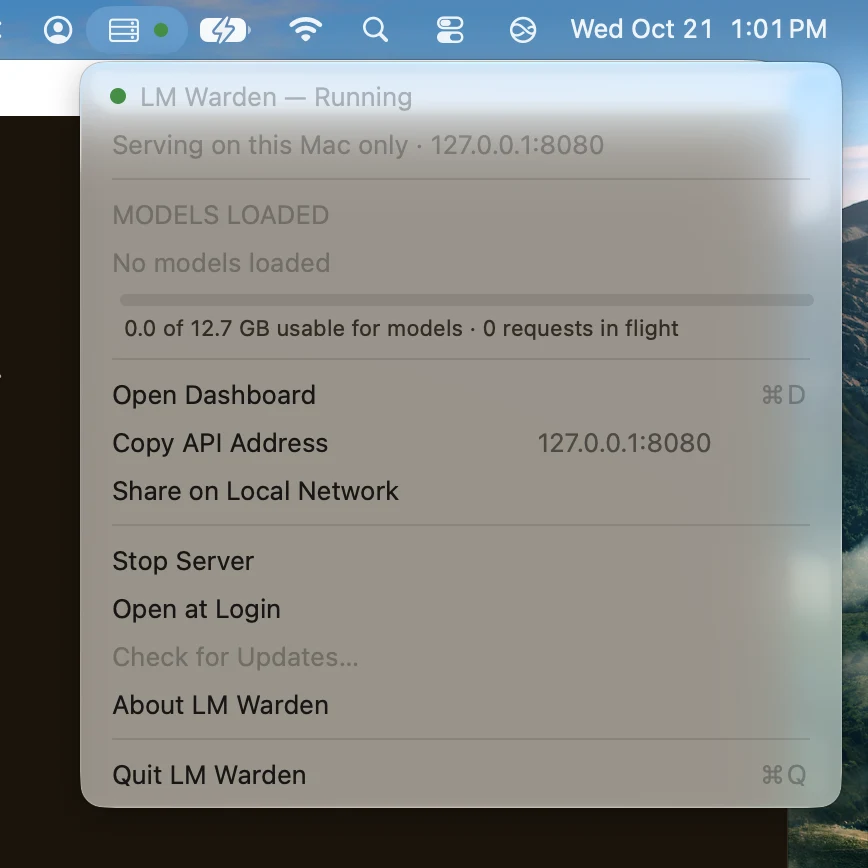
O menu do LM Warden na barra de menus de um Mac: Running, atendendo só neste Mac em 127.0.0.1:8080, nenhum modelo carregado, uma barra de memória, Open Dashboard, Copy API Address, Share on Local Network
O menu da versão beta na barra de menus de um M1 de 16 GB.

O Windows é o próximo. Não há data.

Estamos desenvolvendo a versão para Windows agora e vamos publicar a build aqui no dia em que ela existir, sem formulário de cadastro antes disso. Até lá, há duas opções concretas:

  • Execute o LM Warden em uma máquina Linux com GPU e use-o a partir do Windows: qualquer cliente OpenAI, o Claude Code e o Codex se conectam pela rede.
  • Acompanhe as versões no GitHub para saber da primeira build para Windows.
  • GPUs AMD Radeon e Intel vêm depois; conte para nós em qual você usaria: Radeon · Intel.

O appliance: em breve, sem data.

Uma quarta forma de executar o LM Warden, para uma máquina que não deve fazer mais nada.

  • Você conecta um pendrive USB a um chassi com GPUs. Ele instala um Linux enxuto que faz uma coisa só: executar o LM Warden.
  • Ele configura para você a rede e o armazenamento dos modelos.
  • As atualizações chegam pela internet, ou a máquina funciona totalmente isolada da rede (air-gapped).
  • Feito para um servidor de LLM seguro e dedicado: uma equipe que quer uma máquina fechada e controlada, ou um local sem nenhuma saída para a rede externa.

Até ele ser lançado, a instalação Linux acima faz o mesmo trabalho em um host que você configura, inclusive a instalação offline / isolada da rede. Acompanhe as versões no GitHub.

Ainda sem imagem: não há nome de produto nem hardware para mostrar, e não vamos desenhar um.

Já usa? No Linux, a atualização é feita na própria instalação: baixe as novas imagens, reinicie, e o banco de dados é migrado para a nova versão. Etapas · Registro de alterações.

Hospedar LLMs por conta própria traz oito problemas. Veja cada um deles resolvido.

Um mecanismo sozinho atende um modelo em uma porta. A seguir, tudo o que vem em volta dele, com números nossos sempre que os temos.

  1. Este modelo cabe na minha GPU?

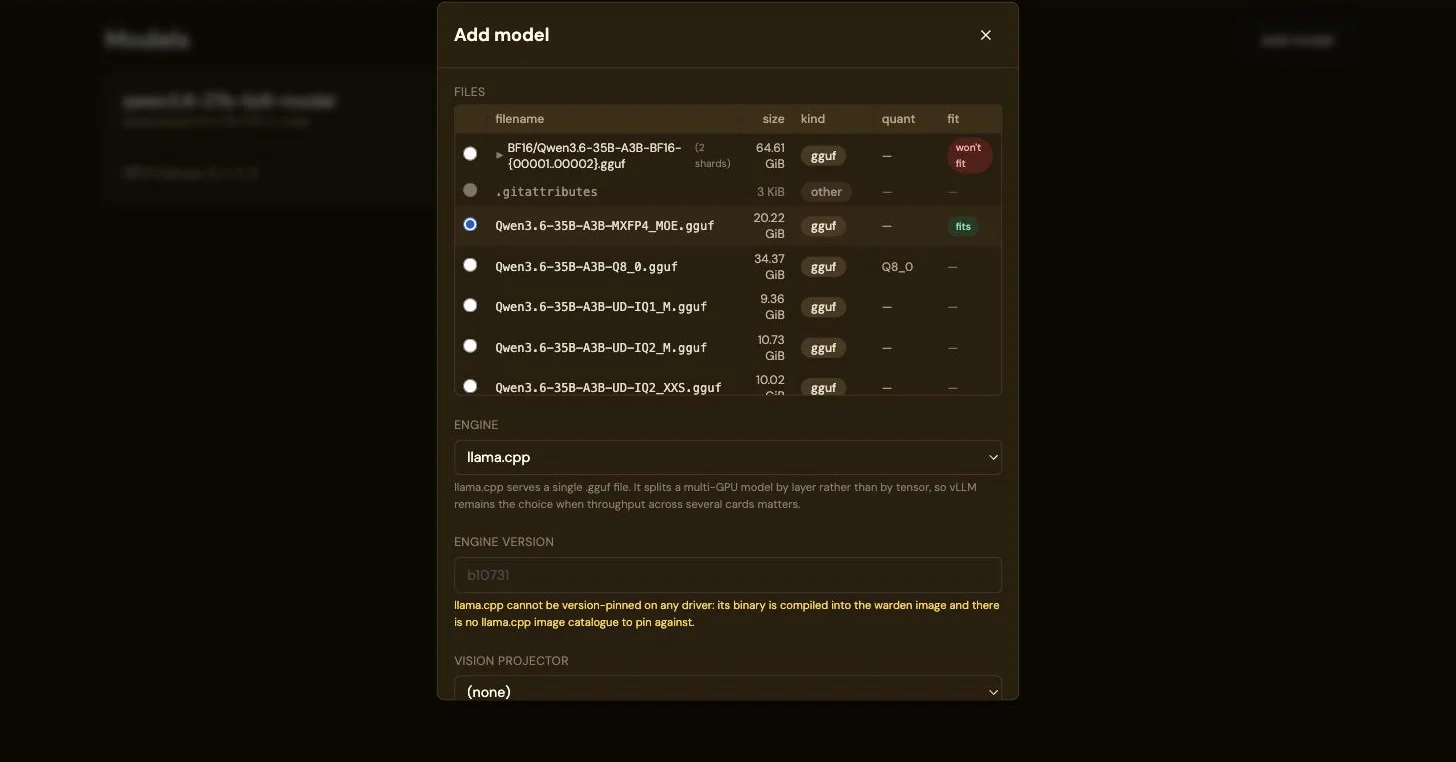
    Cole um repositório do Hugging Face em Add model. Cada arquivo aparece com uma avaliação para as placas que você marcar: cabe, cabe com pouca folga ou não cabe. Marque mais placas e a memória delas se soma. Nada é baixado até que algo caiba.

    O mesmo arquivo de 20,22 GiB passa a caber quando quatro GPUs são selecionadas
  2. Você comprou GPUs. Elas estão trabalhando ou esperando?

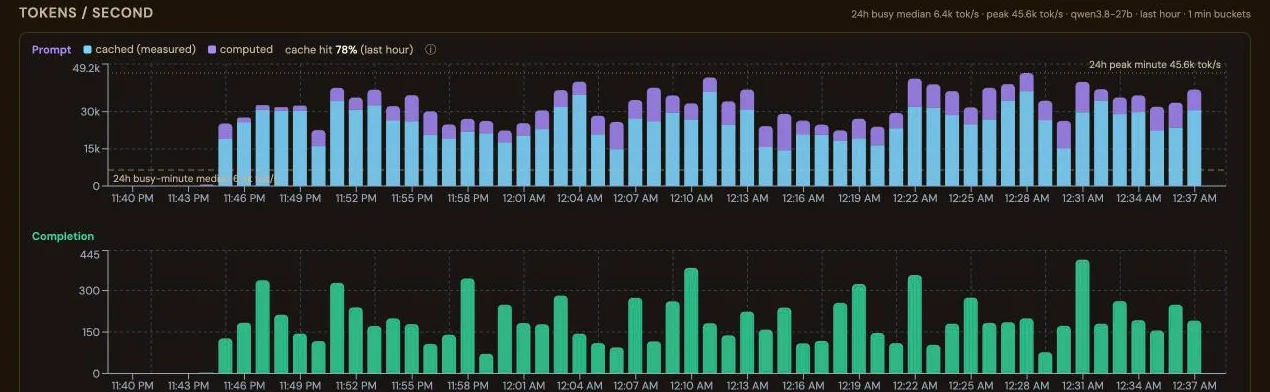
    A vazão é concorrência × tamanho do prompt × reaproveitamento do cache, e um mecanismo sozinho não mostra nada disso junto. A página Stats mostra, de 1 h a 7 dias: VRAM, utilização da GPU, potência (Linux), tokens por segundo com os tokens de prompt divididos em atendidos pelo cache e calculados, latência p50/p95, taxa de acerto do cache de prompts, preempções, solicitações por chave e por IP do cliente. Utilização estável com fila indica que é preciso mais concorrência; uma taxa de acerto do cache baixa indica que é hora de fixar as sessões.
    Tokens por segundo: tokens de prompt divididos em atendidos pelo cache e calculados, tokens de resposta abaixo
  3. Converse com o modelo antes de conectar qualquer coisa.

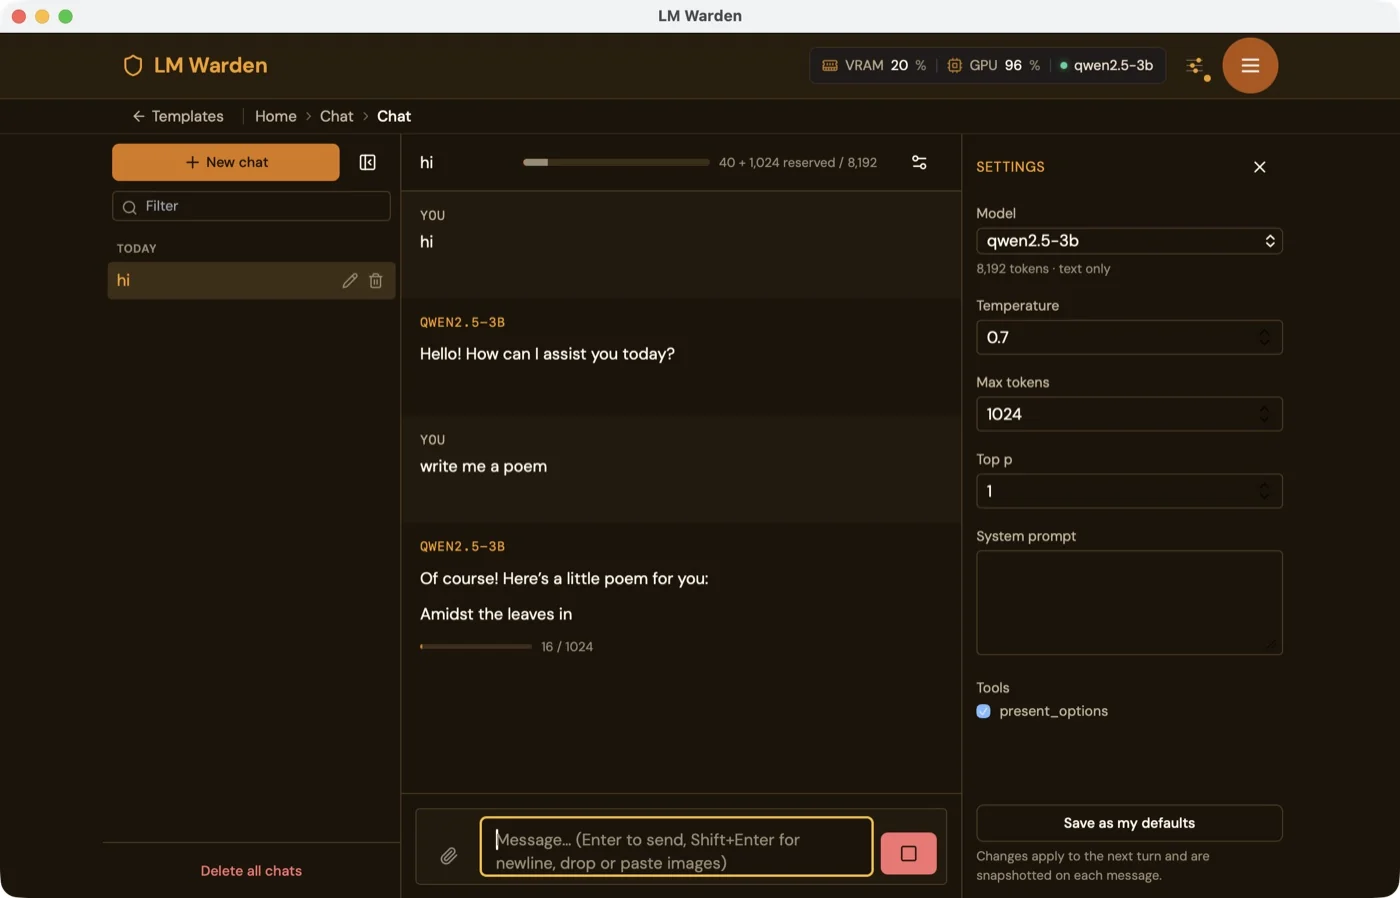
    O chat fica na mesma janela que todo o resto. Markdown em streaming com destaque de código e fórmulas matemáticas; até oito imagens PNG, JPEG ou WebP por mensagem para um modelo de visão; temperatura, top-p, máximo de tokens e prompt do sistema por chat, salvos como padrão; as conversas ficam salvas, com título, e podem ser ramificadas. As chamadas de ferramentas que o modelo faz são exibidas, para você conferi-las antes que um agente dependa delas.

    O chat na janela do painel do app para Mac, em streaming a partir do qwen2.5-3b com GPU em 96% no cabeçalho
  4. O que o modelo realmente recebeu e respondeu?

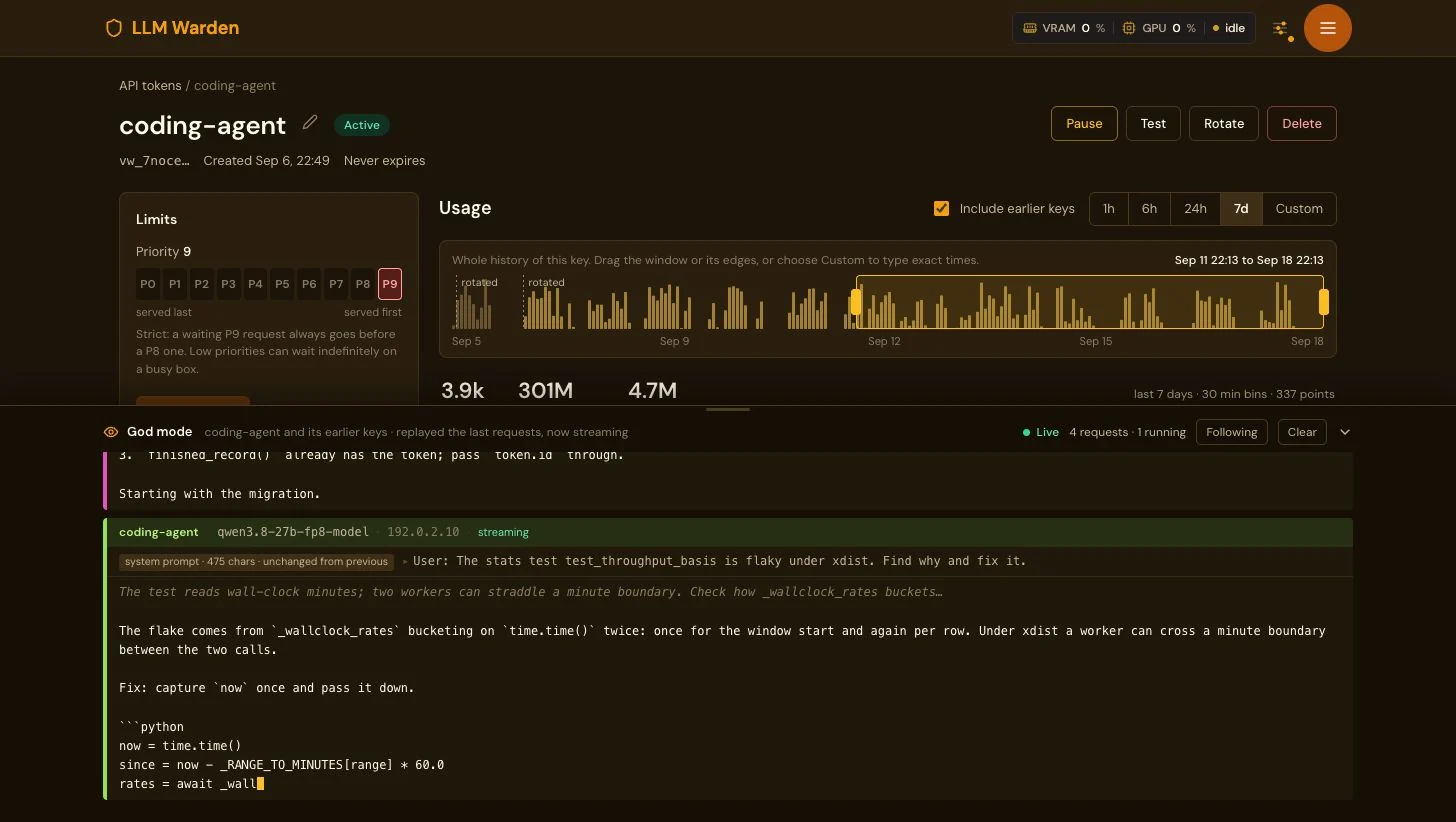
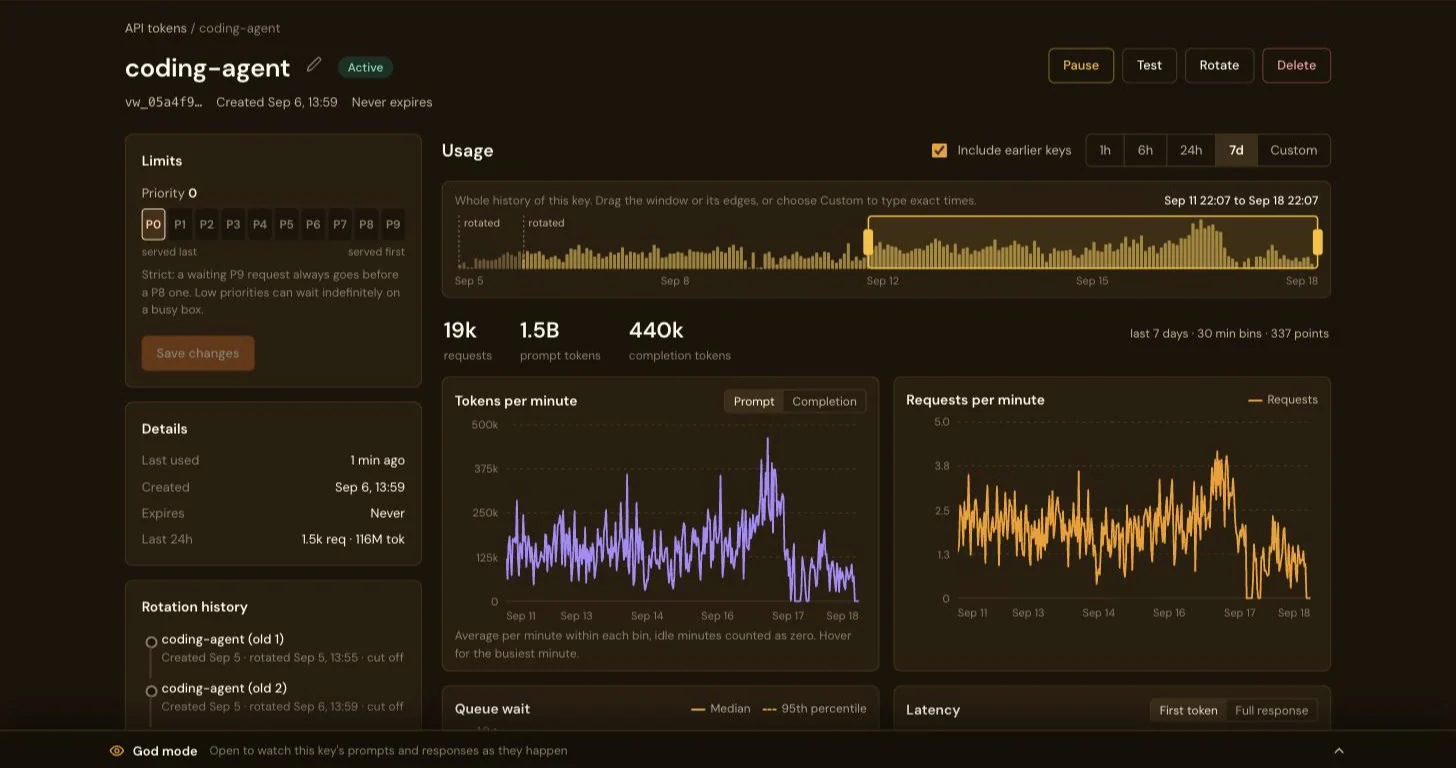
    God mode, para depurar prompts: com VW_GODMODE_ENABLED na implantação, a página de cada chave ganha um painel que transmite ao vivo os prompts e as respostas daquela chave. Desativado por padrão, e ausente quando desativado. Um buffer circular limitado na memória: nada vai para o banco de dados ou para o disco, e tudo some ao reiniciar. Qualquer pessoa com a sessão de administrador pode abri-lo; o warden tem uma única função de administrador e nenhuma outra.

    A página da chave de API coding-agent com o painel God mode aberto na parte inferior: Live, 4 requests, 1 running; uma solicitação ao qwen3.8-27b-fp8 vinda de 192.0.2.10 em streaming, mostrando o prompt do usuário sobre um teste de estatísticas instável e a resposta do modelo com uma correção em Python enquanto é escrita

Cada turno de um agente relê a conversa inteira.

Um agente reenvia todo o histórico a cada turno, então uma conversa longa é principalmente um prefixo que o mecanismo já leu. O vLLM guarda esse trabalho no cache de prefixos, mas só na réplica que o fez, e o próprio balanceador dele envia cada turno para a réplica com a fila mais curta. O LM Warden coloca cada conversa nova na réplica menos carregada e a mantém lá, usando o id de sessão que o Claude Code já envia. Ele só move uma solicitação quando essa réplica passa do limite de transbordo.

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Quatro turnos de uma conversa em um modelo com quatro réplicas. Com o balanceador do vLLM, cada turno passa pelo prefill (o prompt é lido para o cache) quase do zero na réplica que o recebeu. Com o LM Warden, a conversa fica na réplica 2 e só o turno novo passa pelo prefill. Um desenho do mecanismo, não uma medição.

Medido na nossa máquina de quatro placas (4 × RTX A4000, Qwen3-4B como quatro réplicas de uma placa, sessões sintéticas no estilo do Claude Code, afinidade desligada e depois ligada, uma rodada após a outra): com as conversas fixadas, a parcela de tokens de prompt atendidos pelo cache subiu de 56% para 86% com 4 sessões simultâneas, e o tempo mediano até o primeiro byte caiu de 2,05 para 0,38 s. Os tokens de saída por minuto foram maiores em todas as etapas que executamos, e o tempo p95 até o primeiro byte (os 5% mais lentos) foi menor em todas as etapas. O número de réplicas trabalhando quase não mudou (2,71 contra 2,83 de quatro com 4 sessões): o ganho vem do reaproveitamento do cache, não de mais placas trabalhando.

Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
Taxa de acerto do cache de prefixos em cada etapa: tokens de prompt atendidos pelo cache divididos pelos tokens de prompt solicitados, somando as quatro réplicas, calculada pela variação dos contadores do próprio vLLM durante a etapa. O ganho se mantém enquanto há folga e desaparece com 32 sessões, quando as conversas transbordam.
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
Tempo até o primeiro byte com 4 a 32 sessões simultâneas, mediana e p95, em escala logarítmica para que as etapas abaixo de um segundo possam ser lidas ao lado das que levam minutos. Com afinidade, a mediana é bem menor até 16 sessões (0,38 contra 2,05 s com 4) e maior com 24 e 32; o p95 é menor em todas as etapas, embora com 16 a diferença (24,9 contra 26,2 s) esteja dentro do ruído de uma única execução por variante. Medido no cliente, pela internet, até o primeiro token transmitido.

Cada etapa da rampa de carga, afinidade desligada → ligada

SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

Medido na nossa máquina de quatro placas com um modelo pequeno, primeiro com a afinidade desligada e depois ligada, sem reiniciar o vLLM entre as rodadas: a segunda variante começou com o cache de prefixos já aquecido, e as duas geraram os prompts a partir da mesma semente. Cada etapa dura 3 minutos, então conclui só de 9 a 31 sessões, e uma sessão a mais ou a menos muda as sessões por hora em 20; os tokens de saída por minuto são a coluna mais estável. Seu modelo, suas placas e sua carga de trabalho serão diferentes; o painel de réplicas na página de um modelo mostra os mesmos contadores para o seu caso.

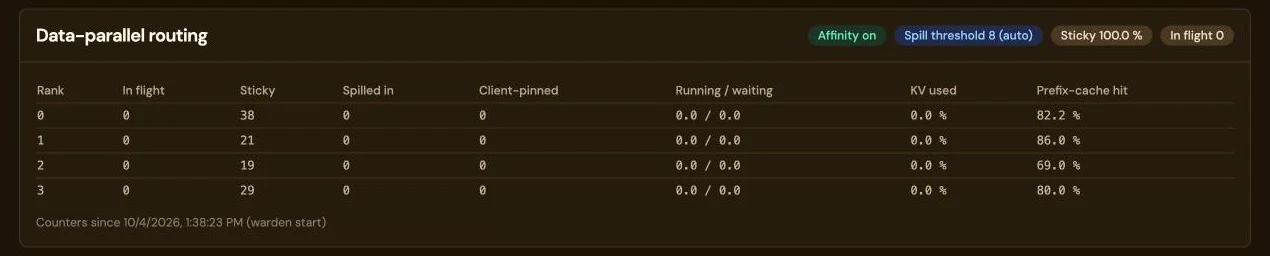
O painel Data-parallel routing na página de um modelo, com os indicadores Affinity on, Spill threshold 8 (auto), Sticky 100.0% e In flight 0. Uma tabela lista as réplicas 0 a 3 com in flight, sticky (38, 21, 19 e 29), spilled in, client-pinned, running e waiting, KV usado e taxa de acerto do cache de prefixos (82,2; 86,0; 69,0 e 80,0 por cento), e uma nota informando que os contadores começaram quando o warden foi iniciado.
Os mesmos contadores na página de um modelo: uma linha por réplica com as solicitações que ela tem, quantas conversas ficaram (sticky) ou chegaram por transbordo, o que está rodando e o que está esperando, o cache KV em uso e a taxa de acerto do cache de prefixos. Registrado em 4 de outubro de 2026 com a afinidade ligada e o limite de transbordo em 8 (auto): sticky 100% e uma taxa de acerto do cache de prefixos de 82,2; 86,0; 69,0 e 80,0% nas réplicas 0 a 3. É uma captura do painel, não um resultado de teste. Toque no painel para ampliá-lo.

Onde a afinidade perde. As etapas de 24 e 32 sessões são uma sobrecarga proposital de quatro placas pequenas, e todas as réplicas estão saturadas. O número de tokens de saída ainda é maior (11.178 contra 9.048 e 16.638 contra 14.760 tokens por minuto) e a cauda lenta é bem mais curta (p95 38 contra 59 s, e 39 contra 83 s), mas o tempo mediano até o primeiro byte é pior com afinidade: 13,1 contra 5,1 s com 24 sessões, 27,7 contra 12,3 s com 32. Não isolamos a causa, e baixar o limite de transbordo de 8 para 4 não mudou isso.

Meça os dois em uma máquina ocupada. A vantagem é maior enquanto há folga; uma máquina que roda no limite deve medir as duas configurações, e a afinidade pode ser desligada por modelo. As réplicas, e portanto este roteamento, fazem parte da instalação Linux com GPUs NVIDIA; o app para Mac (beta) não tem paralelismo de tensores nem de dados.

O método completo: a carga de trabalho, o ambiente de teste, o limite de transbordo e uma máquina com sete GPUs que usa esse roteamento desde então →

Use as suas próprias GPUs no seu agente de programação.

Dez ferramentas se conectam com uma URL base e uma chave; duas delas também podem manter uma assinatura paga do Claude para as tarefas difíceis.

Mantenha sua assinatura do Claude e leve as chamadas de rotina para as suas GPUs

O Claude Code e o Anthropic SDK, pelo roteador. Uma regra define por quais modelos Claude as suas GPUs respondem; todo o resto vai para a Anthropic com o seu próprio login ou chave.

Para onde vai uma solicitação do Claude Code O agente envia cada solicitação ao roteador do LM Warden. As solicitações para modelos claude-haiku vão para um modelo na sua GPU e são respondidas como esse modelo. Qualquer outro modelo, inclusive o Opus, é repassado à Anthropic com o seu próprio login. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* your GPUanswers as that model everything else,Opus included Anthropicon your own login Para onde vai uma solicitação do Claude Code O agente envia cada solicitação ao roteador do LM Warden. As solicitações para modelos claude-haiku vão para um modelo na sua GPU e são respondidas como esse modelo. Qualquer outro modelo, inclusive o Opus, é repassado à Anthropic com o seu próprio login. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* everythingelse, Opusincluded your GPUanswers as that model Anthropicon your own login
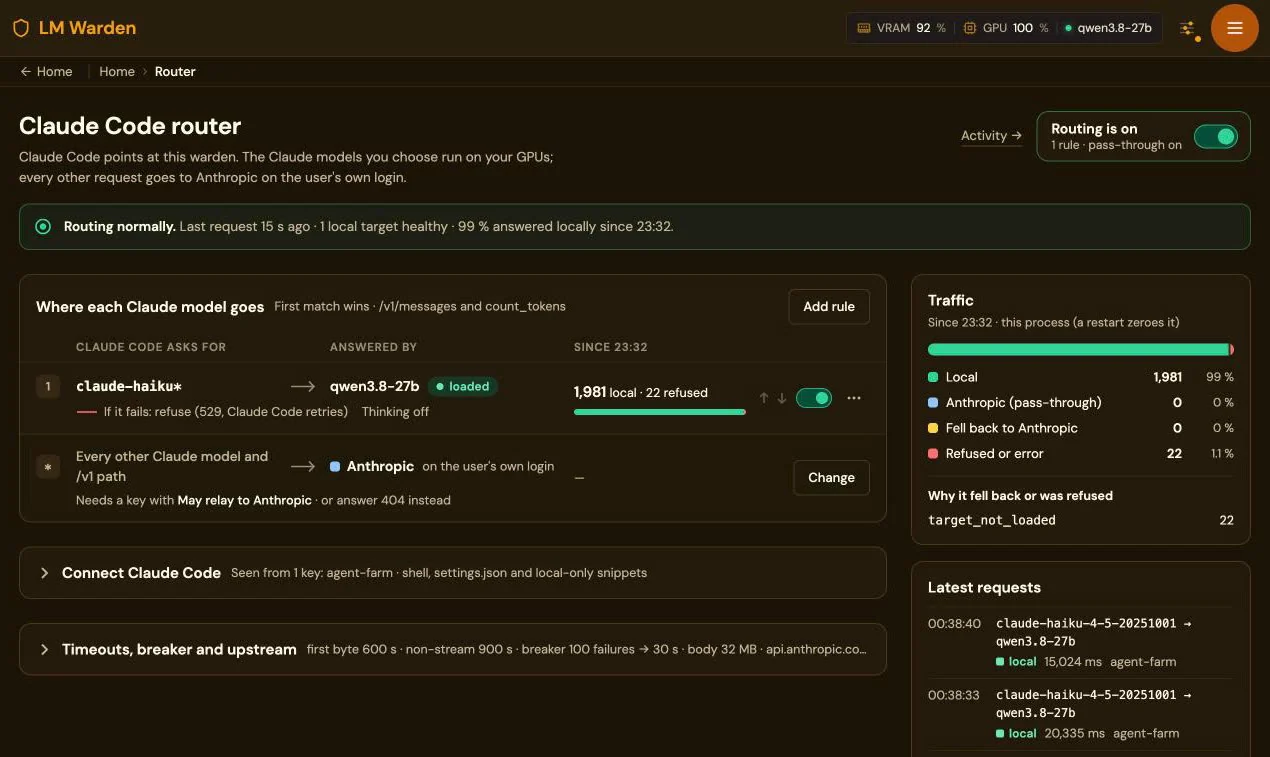
1.981solicitações respondidas localmente, 99% do tráfego do Claude Code da máquina desde que ela foi reiniciada. Da página Router da nossa própria máquina com sete GPUs, 21 de outubro de 2026; 22 recusadas enquanto o destino não estava carregado.
A página do roteador do Claude Code: roteamento ligado, 99% respondido localmente desde as 23:32; a regra 1 envia claude-haiku* para qwen3.8-27b, 1.981 locais e 22 recusadas; qualquer outro modelo Claude vai para a Anthropic com o próprio login do usuário
Claude Code 2.1.227 ou mais recente: ANTHROPIC_BASE_URL apontando para o warden, a chave do warden em ANTHROPIC_CUSTOM_HEADERS e o seu login continua intacto. Não fizemos benchmark da qualidade das respostas: dê ao modelo local o trabalho de rotina e bem especificado.

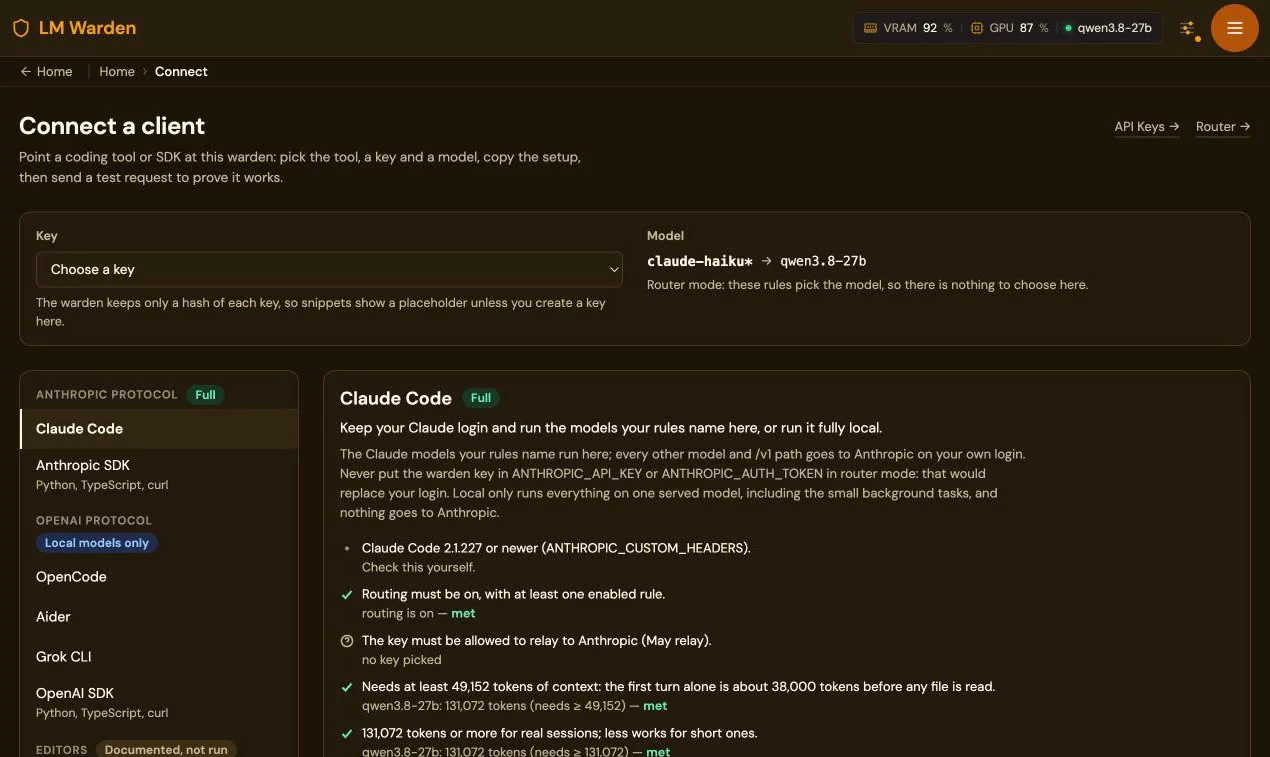
O Connect grava a configuração de cada cliente e envia uma solicitação de teste.

Escolha no console o cliente, uma chave e um modelo carregado; ele verifica cada requisito em relação ao que está de fato carregado (janela de contexto, chamada de ferramentas, roteador ligado) e entrega os arquivos para colar. Todos os agentes de programação, uma página por cliente com o que funciona e o que vimos.

A página Connect a client: um seletor de chave, a regra do roteador claude-haiku* para qwen3.8-27b, os clientes agrupados por protocolo e o painel do Claude Code com os requisitos verificados

Deixe a IA que você já assina ajustar as suas próprias GPUs.

Escolher um modelo para as suas placas é escolher uma quantização, um mecanismo, como dividi-lo entre as GPUs, quanto contexto dar a ele e o tipo de cache KV; cada tentativa custa um download e um carregamento. Tudo o que o console faz é uma chamada de API, então o Claude Code, o Codex ou outro agente com um shell pode fazer essa busca para você, no seu hardware, com a sua carga de trabalho.

O ciclo

O ciclo de ajuste Examinar as GPUs, pré-selecionar modelos com a verificação de compatibilidade antes de qualquer download, carregar layouts candidatos, fazer benchmarks com solicitações reais, ajustar as configurações e manter carregada a configuração vencedora. Benchmark e ajuste se repetem até o agente ficar satisfeito. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner O ciclo de ajuste Examinar as GPUs, pré-selecionar modelos com a verificação de compatibilidade antes de qualquer download, carregar layouts candidatos, fazer benchmarks com solicitações reais, ajustar as configurações e manter carregada a configuração vencedora. Benchmark e ajuste se repetem até o agente ficar satisfeito. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner

O que o agente chama: GET /api/system/gpus, POST /api/models/fit-preview antes de qualquer download, o registro e suggest-config, o download e o carregamento, um teste de estresse que encontra e aplica o teto real de contexto, GET /api/stats/v2/throughput e latency, e uma chave de inferência que ele emite para enviar tráfego de teste. Ele lê primeiro /agent-guide.md, uma descrição curta dessas chamadas escrita para um modelo de linguagem.

Um carregamento de modelo em andamento na página Models: cada etapa com o tempo decorrido e o tempo habitual
O que o agente acompanha enquanto um layout carrega: cada etapa com o tempo habitual de carregamentos anteriores. Um carregamento que para de progredir é interrompido e as GPUs dele são liberadas.

Quatro prompts para colar, e o que você recebe

  1. Examinar e pré-selecionar. Peça: liste minhas GPUs, pré-selecione três modelos de pesos abertos para programação com agentes que caibam com pelo menos 65.536 tokens de contexto, confira cada um com fit-preview e não baixe nada. Você recebe: uma tabela com modelo, quantização, mecanismo, GPUs, contexto e o motivo da escolha.
  2. Mecanismo e layout para um modelo. Peça: decida entre vLLM e llama.cpp, e entre paralelismo de tensores e réplicas em paralelismo de dados nas minhas placas; carregue os dois melhores layouts, envie a cada um as mesmas 20 solicitações em streaming e compare com concorrência 1 e 8. Você recebe: o tempo até o primeiro token e os tokens por segundo dos dois, o vencedor carregado, o outro descarregado e a chave de teste revogada.
  3. Encontrar os limites reais e aplicá-los. Peça: faça um teste de estresse no modelo carregado, aplique o contexto medido e depois faça benchmark com concorrência 1, 4 e 16 com prompts de cerca de 2k e 30k tokens. Você recebe: o teto de contexto gravado nas configurações do modelo e uma tabela de tempo até o primeiro token e tokens por segundo por concorrência e tamanho de prompt.
  4. Comparar dois candidatos no seu próprio trabalho. Peça: reexecute os prompts em ./workload/*.txt no modelo A e no modelo B com concorrência 4 e avalie cada resposta. Você recebe: model-comparison.md com latência, tokens por segundo, correção segundo o julgamento do agente e uma recomendação; o modelo recomendado fica carregado.

Antes de começar. Um token de administrador tem direitos plenos de administração sobre o warden (modelos, chaves, configurações; ainda não há escopos mais restritos): dê a ele uma validade curta e revogue-o em Settings → Access Tokens quando o trabalho terminar. Um teste de estresse derruba um mecanismo de propósito para encontrar o limite dele: execute esses prompts em um warden do qual ninguém mais dependa. Os downloads são grandes; os prompts verificam se o modelo cabe antes de baixar, mas fique de olho no espaço em disco.

As escolhas de mecanismo e layout (vLLM, paralelismo de tensores ou de dados) são da instalação Linux; no Mac, a escolha é entre MLX e llama.cpp em uma GPU. O modelo que faz o ajuste pode ser qualquer um que você já assine; o modelo ajustado é o que roda nas suas placas. A página de ajuste com agente de IA: os quatro prompts completos.

Uma máquina com GPU, compartilhada por toda a sua equipe, sua família e seus agentes.

Crie quantas chaves de API precisar e distribua: um colega, alguém da família, um job de CI, um grupo de agentes, cada um com sua própria chave, sua própria prioridade e sua própria página de uso. O hardware trabalha para todos, e o trabalho importante nunca fica esperando.

Seu hardware como ele é: de um Mac a oito B300.

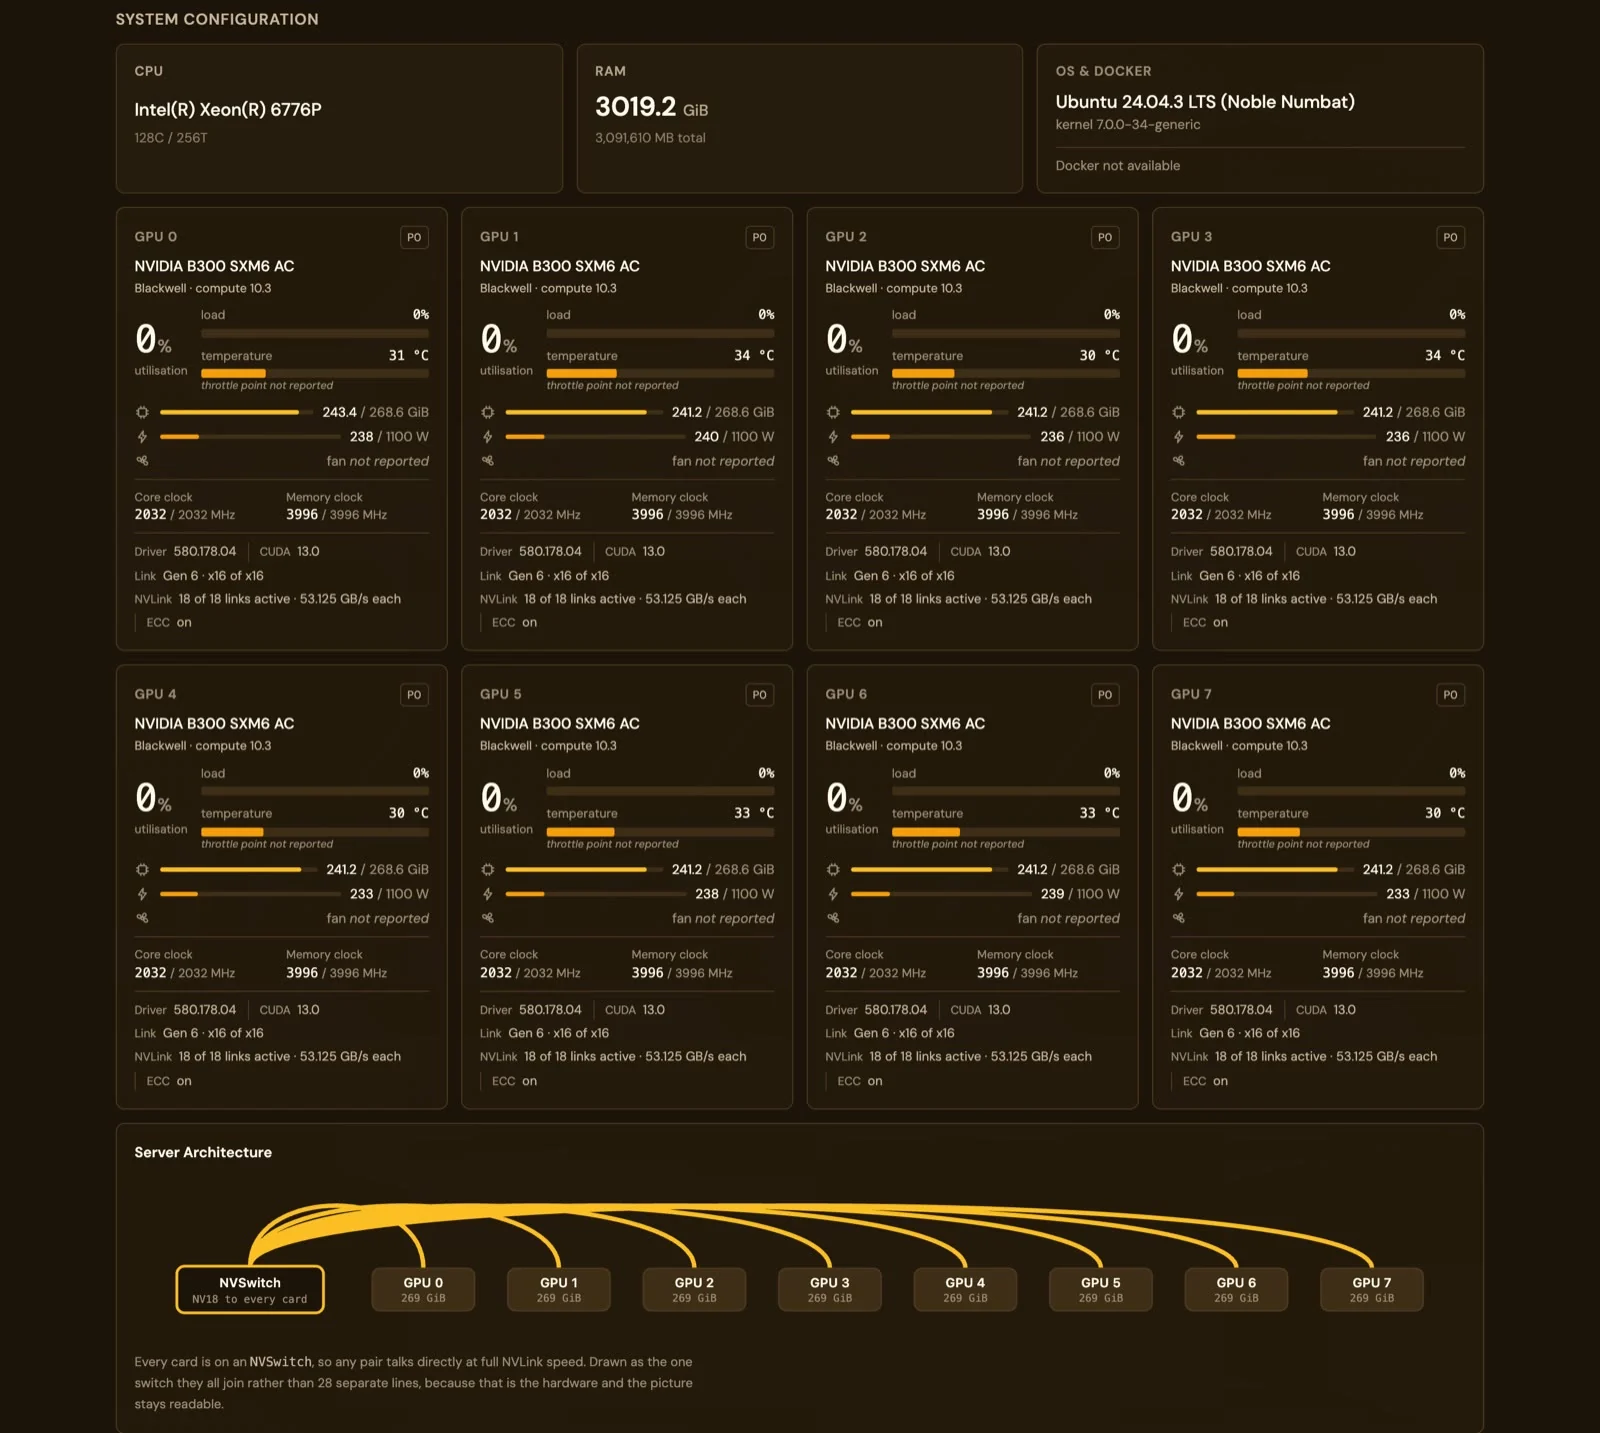
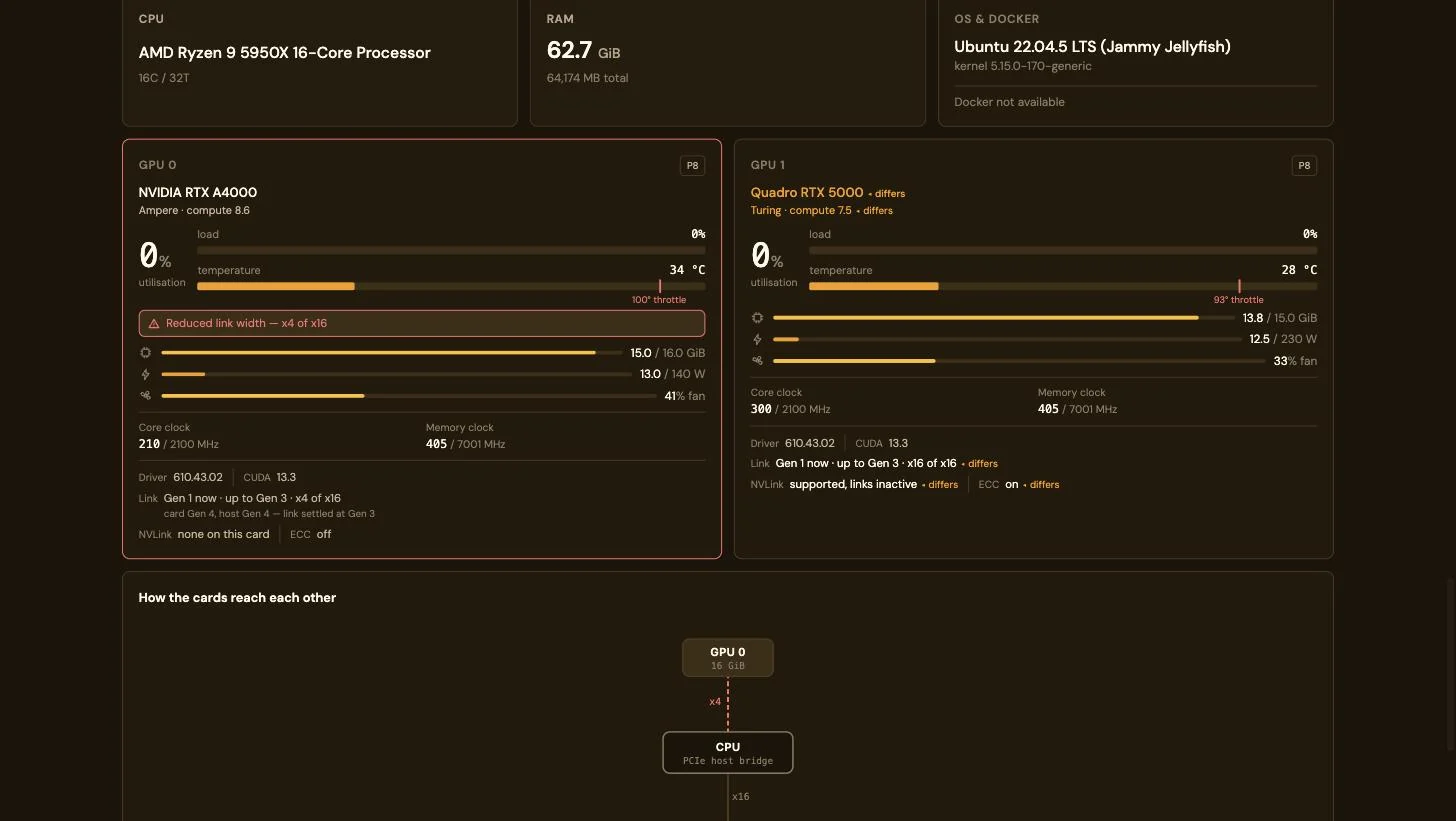
O mesmo console lê um M1 de 16 GB, duas placas diferentes embaixo de uma mesa e um servidor NVSwitch 8 × B300, e aponta o gargalo em vez de escondê-lo numa média: um link PCIe que negociou x4 em vez de x16, links NVLink inativos, ECC diferente entre as placas.

Configuração do sistema em um servidor 8 × B300: Intel Xeon 6776P, 3019 GiB de RAM, oito painéis NVIDIA B300 SXM6, cada um com 241 de 268,6 GiB em uso, Link Gen 6 x16 de x16, NVLink com 18 de 18 links ativos a 53,125 GB/s cada, ECC ligado e um desenho da arquitetura do servidor com um NVSwitch ligado a cada placa
Oito placas B300 SXM6 em um NVSwitch: 18 de 18 links NVLink ativos por placa, ECC ligado, PCIe Gen 6 x16, 241 de 268,6 GiB em uso por placa servindo GLM-5.2 NVFP4 com paralelismo de tensores 8.
Duas GPUs diferentes: uma NVIDIA RTX A4000 com um aviso vermelho Reduced link width x4 de x16 e Link Gen 1 agora, até Gen 3, ao lado de uma Quadro RTX 5000 cuja arquitetura, VRAM, limite de potência, link, NVLink e ECC estão marcados como differs; abaixo, um desenho de como as placas chegam à CPU por links x4 e x16
Duas placas compradas com anos de diferença: o link da A4000 negociou x4 em vez de x16 e aparece em vermelho; a arquitetura, o limite de potência, o NVLink (compatível, links inativos) e o ECC da Quadro estão marcados como differs. O desenho mostra qual slot está com a largura reduzida.
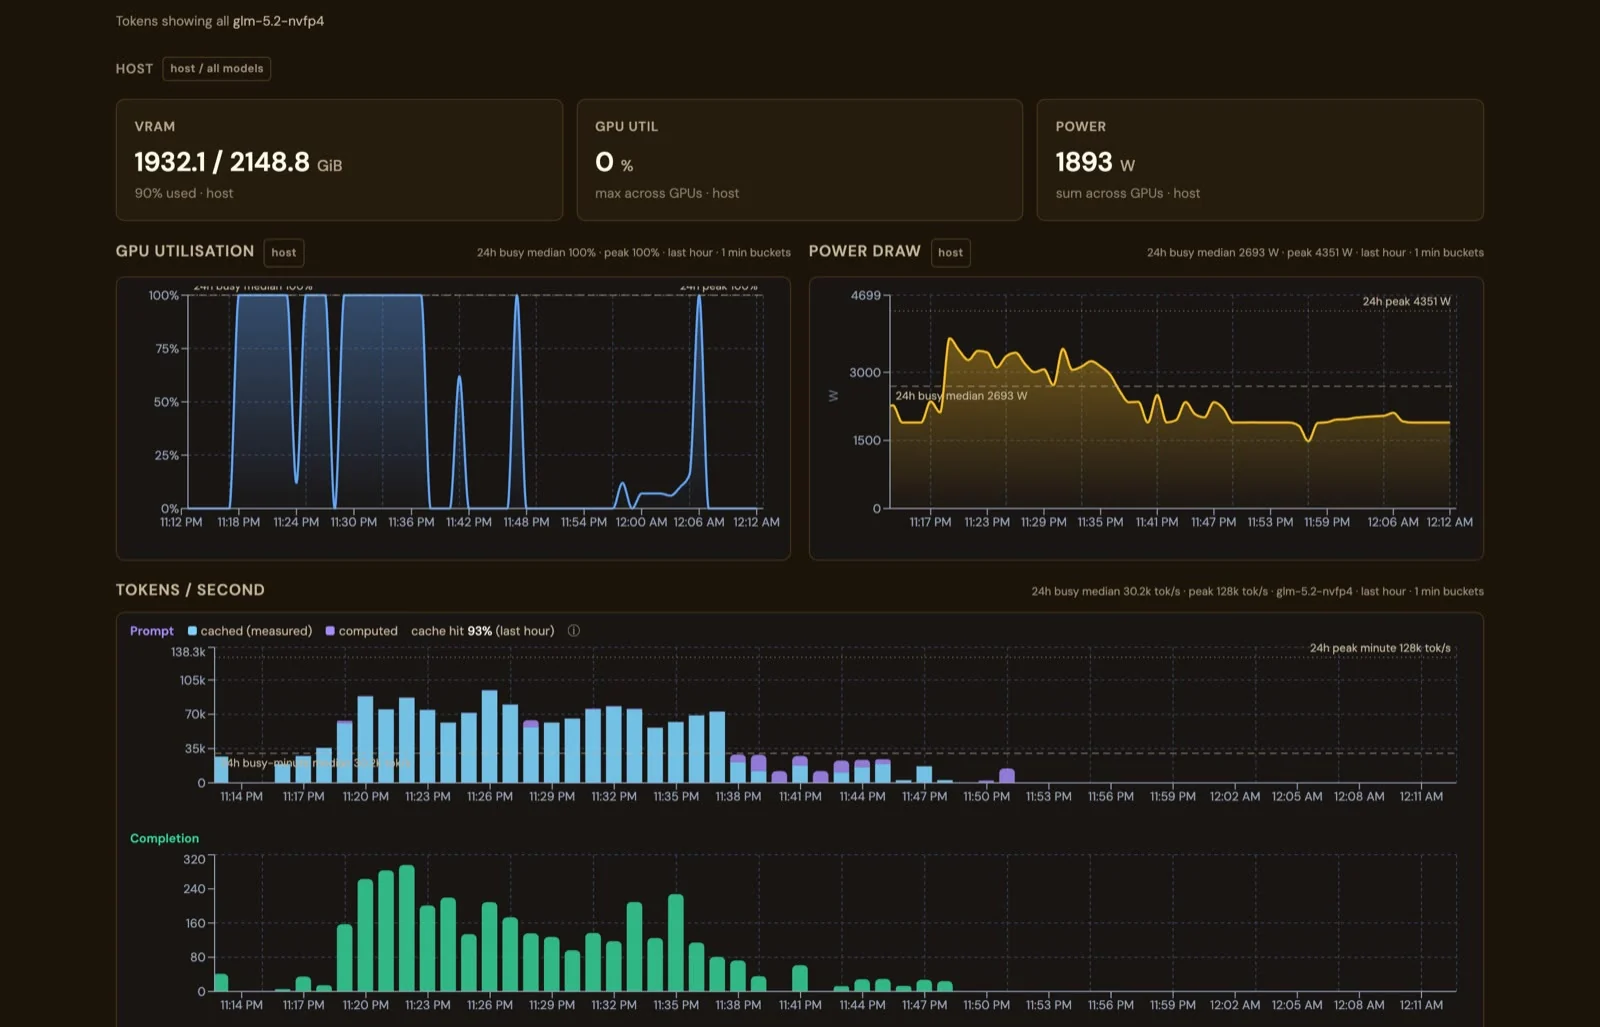
Stats no servidor 8 × B300: VRAM 1932,1 de 2148,8 GiB, potência de 1893 W somada entre as placas, utilização da GPU e consumo de energia na última hora, e tokens de prompt por segundo divididos em atendidos pelo cache e calculados, com taxa de acerto do cache de 93%
A mesma página Stats no hardware mais potente: 1.932 de 2.149 GiB de VRAM, 1.893 W somando as placas, um pico de 4.351 W na hora e 93% dos tokens de prompt vindos do cache.
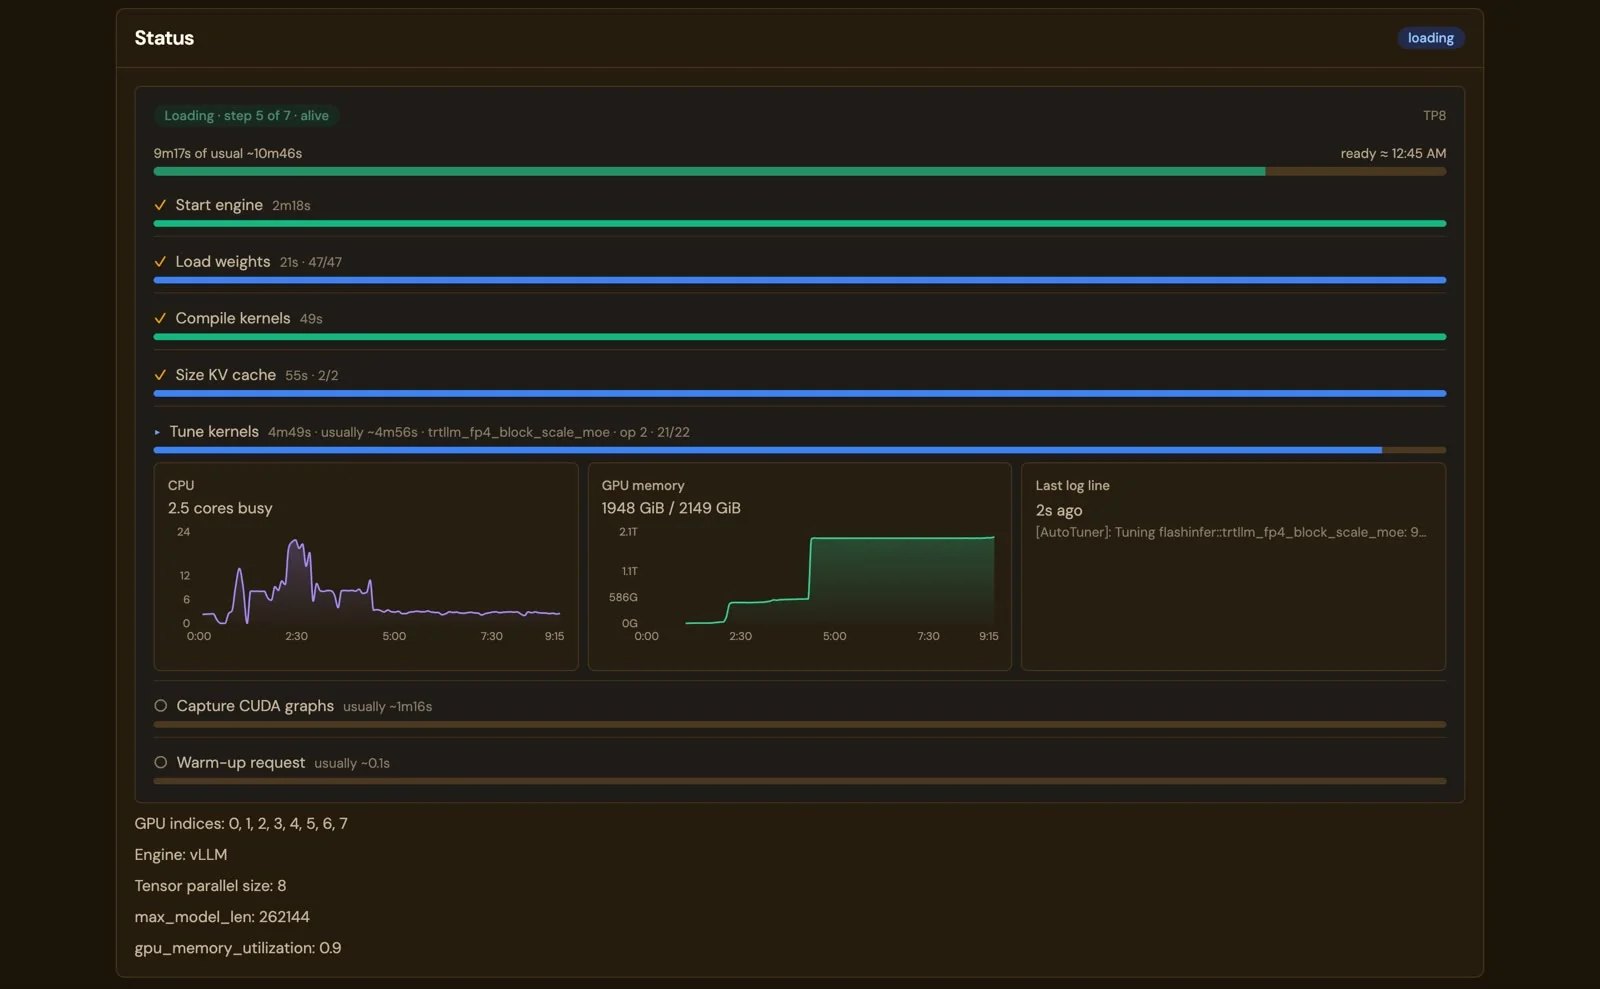
A página do modelo enquanto o GLM-5.2 NVFP4 carrega em oito B300: 9 min 17 s de um tempo habitual de 10 min 46 s, etapas Start engine, Load weights 47 of 47, Compile kernels e Size KV cache concluídas, Tune kernels em op 21 of 22, com gráficos de CPU e memória da GPU e a última linha de log
Um carregamento de 10 minutos, etapa por etapa: GLM-5.2 NVFP4 em oito B300, 9 min 17 s de um tempo habitual de 10 min 46 s, nada em vermelho enquanto ainda está avançando.

O que cada painel mostra por placa: a temperatura em relação ao próprio ponto de throttling, a potência em relação ao limite, clocks, ventoinha, a geração e a largura PCIe negociadas naquele momento, ECC e NVLink quando a placa os tem e o processo que ocupa a memória. O desenho da interconexão é lido de nvidia-smi topo -m. No Mac: o uso da GPU e a memória disponível informada pelo Metal, sem potência. E o mecanismo por baixo de tudo é monitorado pelo seu próprio /health, não pela tabela de processos: um mecanismo travado por trás de um wrapper ainda ativo é recarregado, e as evidências são guardadas.

O que ele mostra

Monitoramento de GPU

Cada placa com os seus próprios números.

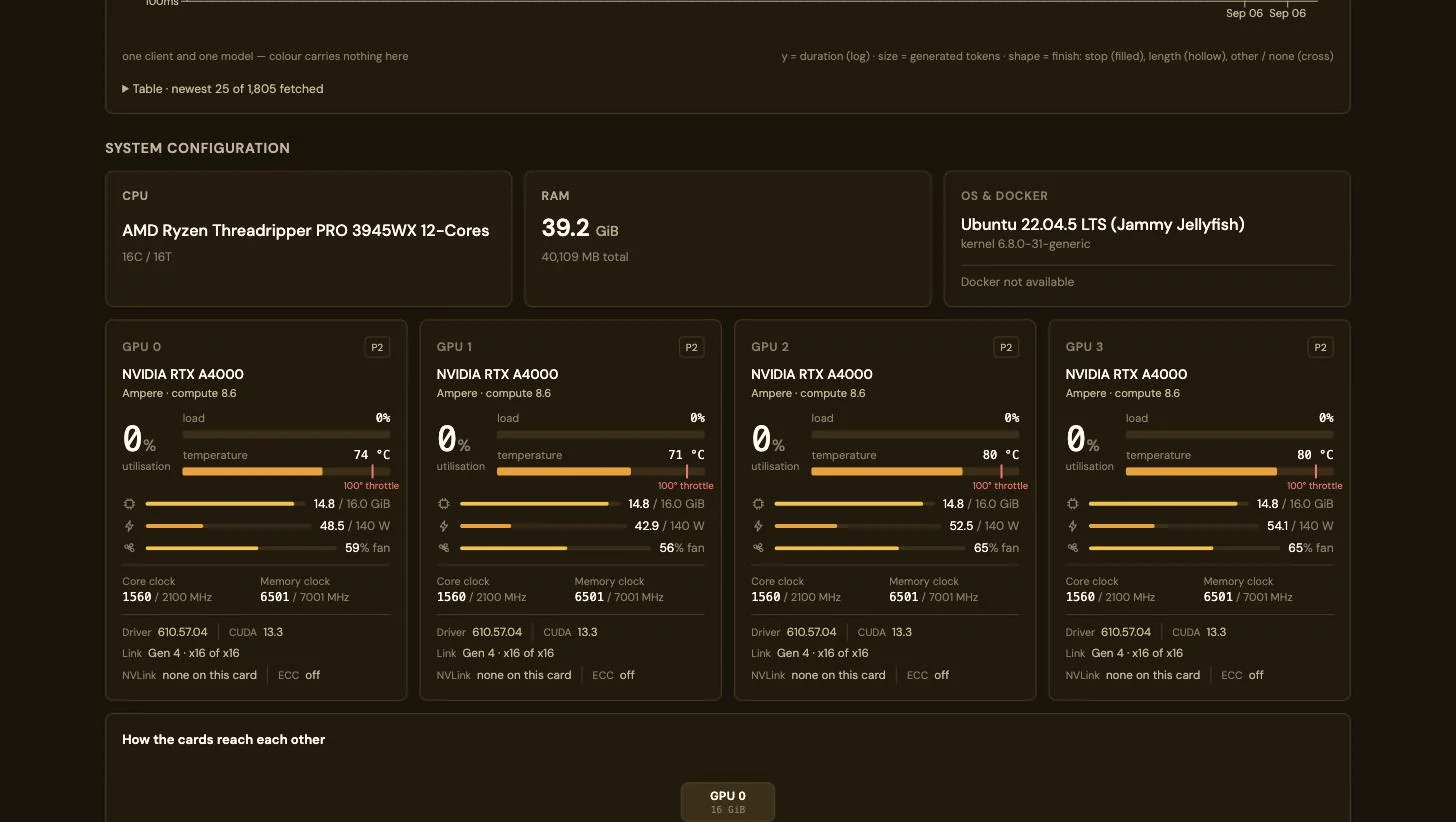
Utilização, temperatura em relação ao ponto de throttling daquela placa, potência em relação ao limite, VRAM, clocks, link PCIe e qual processo ocupa a memória. E não uma média da máquina inteira.

Configuração do sistema e quatro painéis de GPU para placas NVIDIA RTX A4000 com utilização, temperatura, VRAM, potência, ventoinha e clocks por placa

Solicitações em andamento

Veja o que cada agente está fazendo agora.

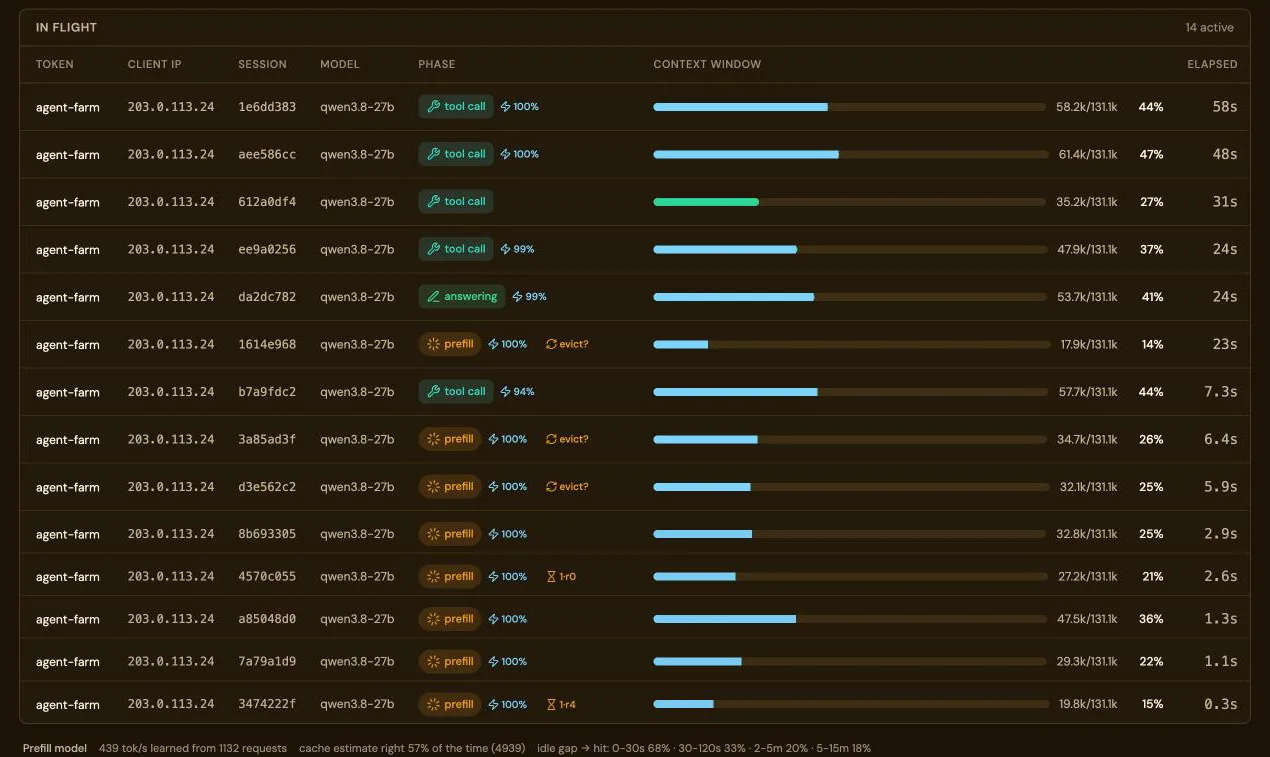
Cada solicitação com a chave, a sessão e a fase: na fila, prefill, pensando, chamada de ferramenta, respondendo. Quanto de cada prompt veio do cache de prefixos, medido por solicitação.

A tabela de solicitações em andamento: dez solicitações ativas, cada uma com chave, sessão, fase e tokens

Agentes de programação

Claude Code, Codex e OpenCode, conectados a partir de uma só página.

O Connect grava a configuração de cada ferramenta com o endereço deste warden, uma chave e um modelo carregado, verifica os requisitos em relação ao que está de fato carregado e envia uma solicitação de teste.

A página Connect a client com o Claude Code selecionado e os requisitos verificados

Gratuito, de código aberto e desenvolvido abertamente.

O LM Warden é Apache-2.0 no GitHub: o script de instalação e o arquivo Compose são toda a implantação, e você pode ler os dois. Sem conta, sem verificação de licença, sem telemetria. vLLM, llama.cpp e MLX são projetos upstream que executamos sem modificações.

mlx-rust-lm em breve

Um port do mlx-lm da Apple de Python para Rust sobre os bindings oficiais mlx-c da Apple, desenvolvido e mantido pela equipe do LM Warden como projeto de código aberto independente, que o LM Warden vai usar como terceiro mecanismo no Mac e que, com o tempo, vai substituir o mecanismo mlx-lm em Python, que hoje é a maior parte do download para Mac. Não oficial, sem afiliação com a Apple.