Следующий шаг диалога попадает туда, где предыдущий оставил свой кэш.
Агент на каждом шаге заново отправляет всю историю, поэтому длинный диалог — это в основном префикс, который движок уже обработал. vLLM сохраняет эту работу в кэше префиксов (состояние механизма внимания для уже обработанных промптов) и не повторяет ее, когда тот же префикс приходит снова, — но только на той реплике, которая эту работу выполнила: у каждой полной копии модели свой кэш. Собственный балансировщик vLLM отправляет каждый шаг на реплику с самой короткой очередью, а она обычно этот диалог еще не видела и заново обрабатывает всю историю. LM Warden размещает каждый новый диалог на наименее загруженной реплике (с учетом выполняющихся запросов, заполненности кэша и числа активных диалогов) и закрепляет его там по идентификатору сессии, который Claude Code и так отправляет. На другую реплику запрос уходит, только когда текущая превышает порог переноса: по умолчанию — когда выполняющихся запросов больше четверти лимита одновременных последовательностей модели; на нашем сервере с четырьмя картами это 8.
Реплики, а значит и эта маршрутизация, есть только в установке для Linux с GPU NVIDIA; в приложении для Mac (бета-версия) нет ни тензорного параллелизма, ни параллелизма по данным.
Рис. 6Четыре шага одного диалога на модели с четырьмя репликами. С балансировщиком vLLM каждый шаг проходит prefill (чтение промпта в кэш) почти с нуля на той реплике, которой он достался. С LM Warden диалог остается на реплике 2, и prefill проходит только новый шаг. Это схема механизма, а не результат замера.
Замеры на сервере с четырьмя картами: при закрепленных диалогах доля токенов промпта, взятых из кэша, выросла с 56 до 86 % при 4 одновременных сессиях, а медианное время до первого байта сократилось с 2,05 до 0,38 с. Выходных токенов в минуту было больше на каждой ступени нагрузки, а время до первого байта p95 (самые медленные 5 %) — меньше на каждой ступени. Число занятых реплик почти не изменилось (2,71 против 2,83 из четырех при 4 сессиях): выигрыш дает повторное использование кэша, а не то, что работает больше карт.
Ступени с 24 и 32 сессиями — намеренная перегрузка четырех небольших карт, когда ожидание доходит до десятков секунд и с привязкой, и без нее. Здесь проявляется компромисс: хвост медленных запросов с привязкой по-прежнему короче, но медиана выше. Цифры ниже.
GPU
4 × NVIDIA RTX A4000, по 16 ГиБ
Модель
qwen3-4b-dp4 (Qwen/Qwen3-4B-Instruct-2507), bf16
Схема размещения
data_parallel_size 4, tensor_parallel_size 1
vLLM
0.26.0
LM Warden
Текущий выпуск
Дата замера
4 октября 2026 г., оба варианта сразу друг за другом
Нагрузка
Синтетические сессии в стиле Claude Code с нашего собственного стенда, а не сам Claude Code: общий системный промпт примерно на 3,5 тыс. токенов, первое сообщение, уникальное для каждой сессии (номинально 6 тыс., по замерам около 7,2–7,5 тыс.), затем еще пять шагов примерно по 400 новых токенов, не более 256 выходных токенов за шаг. Замкнутый цикл: сессия начинает следующий шаг, как только закончился предыдущий. 3 минуты на ступень.
Рис. 7Время до первого байта при 4–32 одновременных сессиях, медиана и p95, в логарифмической шкале, чтобы на одном графике уместились значения и меньше секунды, и в несколько минут. С привязкой медиана намного ниже вплоть до 16 сессий (0,38 против 2,05 с при 4) и выше при 24 и 32; p95 ниже на каждой ступени, хотя при 16 разница (24,9 против 26,2 с) не выходит за пределы шума при одном прогоне на вариант. Измерено на стороне клиента, через интернет, до первого токена потокового ответа.
Sessions
Sessions/h off → on
Output tokens/min off → on
TTFB p50 off → on (s)
TTFB p95 off → on (s)
Replicas busy off → on
Prefix hits off → on (%)
Stayed on replica (%)
4
180 → 240
5,886 → 6,744
2.05 → 0.38
3.5 → 2.84
2.71 → 2.83
56.2 → 86.4
100
8
300 → 380
8,364 → 10,752
2.33 → 0.48
6.32 → 5.03
3.74 → 3.74
44.3 → 86.1
100
16
300 → 360
9,558 → 12,204
3.25 → 0.85
26.24 → 24.88
3.91 → 3.69
33.2 → 48.6
100
24
300 → 420
9,048 → 11,178
5.06 → 13.14
58.82 → 38.34
3.91 → 4
32.8 → 37.9
89.1
32
520 → 620
14,760 → 16,638
12.32 → 27.66
82.84 → 38.92
4 → 4
31.6 → 31.6
67.3
Замеры на нашем сервере с четырьмя картами и небольшой моделью: сначала с выключенной привязкой, затем с включенной, без перезапуска vLLM между прогонами. Поэтому второй прогон начинался с прогретым кэшем префиксов; промпты в обоих прогонах генерировались с одним и тем же начальным значением (seed). Каждая ступень длится 3 минуты, так что за нее успевает завершиться лишь от 9 до 31 сессии, и одна сессия больше или меньше сдвигает показатель «сессий в час» на 20; выходные токены в минуту — более устойчивый показатель. Ваши модель, карты и нагрузка будут другими; карточка реплик на странице модели показывает те же счетчики для вашей системы.
Вплоть до 16 сессий привязка выигрывает на каждой ступени по пропускной способности, попаданиям в кэш префиксов и обоим показателям времени до первого байта: доля попаданий растет с 56 до 86 % при 4 сессиях, медианное время до первого байта сокращается с 2,05 до 0,38 с, а число выходных токенов растет с 5 886 до 6 744 в минуту (сессий в час — со 180 до 240). При 24 и 32 сессиях, на ступенях перегрузки, каждая реплика загружена полностью. Выходных токенов все равно больше (11 178 против 9 048 и 16 638 против 14 760 токенов в минуту), а хвост медленных запросов намного короче (p95 38 против 59 с и 39 против 83 с), но медианное время до первого байта с привязкой хуже: 13,1 против 5,1 с при 24 сессиях и 27,7 против 12,3 с при 32. Причину мы пока не выяснили, и снижение порога переноса с 8 до 4 ничего не изменило. Преимущество максимально, пока есть запас мощности; если сервер работает на пределе, стоит измерить оба варианта, а привязку можно отключить для каждой модели отдельно.
Рис. 8Сколько реплик из четырех занято: число реплик с выполняющимися запросами при каждом опросе, усредненное за ступень. Это не загрузка GPU. Привязка почти не меняет этот показатель; выигрыш виден на рис. 9.
Рис. 9Доля попаданий в кэш префиксов на каждой ступени: отношение токенов промпта, взятых из кэша, ко всем запрошенным токенам промпта, суммарно по четырем репликам, по приросту собственных счетчиков vLLM за ступень. Выигрыш сохраняется, пока есть запас мощности, и исчезает при 32 сессиях, когда диалоги начинают уходить на другие реплики.
Привязка включена, порог переноса 8 (auto)Доля попаданий по репликам по собственным счетчикам vLLM
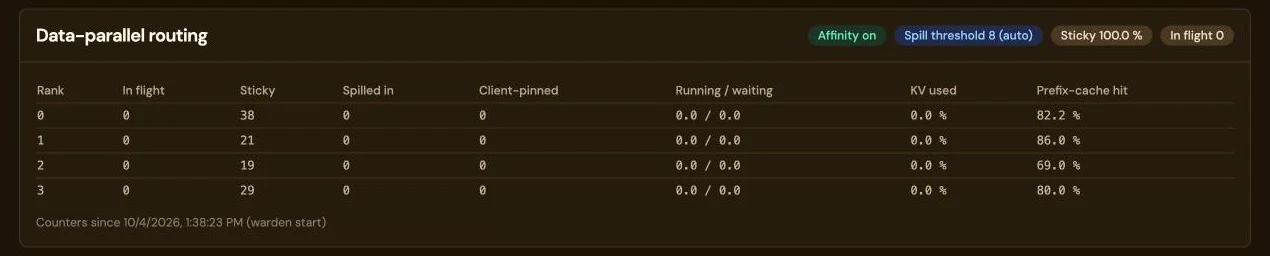
Рис. 10Те же счетчики на странице модели: по строке на реплику — запросы, которые она обрабатывает, сколько диалогов на ней осталось (sticky) и сколько перенесено с других реплик, выполняющиеся и ожидающие запросы, занятый KV-кэш и доля попаданий в кэш префиксов. Снимок от 4 октября 2026 г. с включенной привязкой и порогом переноса 8 (auto): sticky 100 %, 38, 21, 19 и 29 закрепленных диалогов на репликах с 0 по 3 и доля попаданий в кэш префиксов 82,2; 86,0; 69,0 и 80,0 %. Счетчики ведутся с момента перезапуска LM Warden, и весь трафик за это время шел с включенной привязкой: синтетические сессии агентов плюс реальные шаги Claude Code. Это снимок карточки интерфейса, а не результат замера. Прокрутите изображение вбок, чтобы увидеть все столбцы.
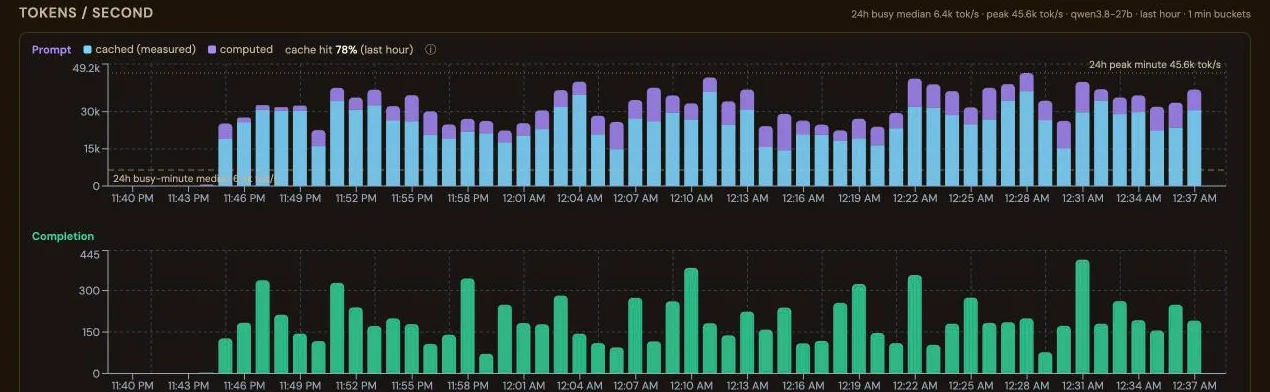
Сервер, на котором впервые понадобилась маршрутизация по репликам, с тех пор работает с ней. В нем семь RTX 5090, которые обслуживают модель 27B в виде семи реплик по одной карте для фермы агентов Claude Code, работающих в фоновом (headless) режиме. Наше первое правило размещения хешировало идентификатор сессии: диалоги закреплялись, но нагрузка не учитывалась. При 26 сессиях агентов примерно по 58 тыс. токенов каждая три реплики простаивали, а другие заполняли кэш до 93 %, и доля токенов промпта, взятых из кэша, примерно за 35 минут упала с 81 % после перезапуска до 28 %. Тогда мы сократили ферму до 16 сессий, примерно по две на реплику, чтобы рабочие наборы помещались в кэш, и стали размещать новые диалоги на наименее загруженной реплике. В следующий час доля держалась на уровне 78–79 %. Это наблюдение, а не A/B-тест: одна нагрузка и два изменения одновременно, так что выигрыш нельзя приписать только размещению. Практическое правило отсюда: число одновременных сессий, умноженное на их типичный размер контекста, должно быть меньше общего объема кэша на сервере.
Измеряется движком для каждого запроса
Рис. 11Токены промпта в секунду на сервере с семью GPU: что каждая реплика взяла из кэша префиксов и что пришлось вычислить, и доля из кэша за последний час — 78 %. Часть из кэша — собственный подсчет движка для каждого завершенного запроса, а не оценка; запрос, для которого замера нет, считается вычисленным. Снято 5 октября 2026 г. Прокрутите изображение вбок, чтобы увидеть весь час.
Этот сайт использует файлы cookie Google Analytics для подсчета посещений и оценки эффективности рекламы, но только с вашего разрешения. Конфиденциальность
 Привязка включена, порог переноса 8 (auto)
Доля попаданий по репликам по собственным счетчикам vLLM
 Измеряется движком для каждого запроса