O próximo turno vai para a réplica onde o anterior deixou o cache.
Um agente reenvia todo o histórico a cada turno, então uma conversa longa é, na maior parte, um prefixo que o mecanismo já leu. O vLLM guarda esse trabalho no cache de prefixos (o estado de atenção dos prompts que já viu) e não o refaz da próxima vez que o mesmo prefixo chega, mas só na réplica que fez o trabalho: cada cópia completa do modelo tem o seu próprio cache. O balanceador do próprio vLLM envia cada turno para a réplica com a menor fila, que normalmente nunca viu a conversa, e por isso lê todo o histórico de novo. O LM Warden coloca cada conversa nova na réplica menos carregada (solicitações em andamento, quão cheio está o cache e quantas conversas ativas ela tem) e a mantém lá, usando o id de sessão que o Claude Code já envia. Ele só move uma solicitação quando essa réplica passa do limite de transbordo: por padrão, solicitações em andamento acima de um quarto do limite de sequências simultâneas do modelo, 8 na nossa máquina de quatro placas.
As réplicas, e portanto este roteamento, fazem parte da instalação Linux com GPUs NVIDIA; o app para Mac (beta) não tem paralelismo de tensores nem de dados.
Fig. 6Quatro turnos de uma conversa em um modelo com quatro réplicas. Com o balanceador do vLLM, cada turno passa por prefill (o prompt lido para o cache) quase do zero na réplica que o recebeu. Com o LM Warden, a conversa fica na réplica 2 e só o turno novo passa por prefill. Um desenho do mecanismo, não uma medição.
Medido na máquina de quatro placas: com as conversas fixadas, a parcela de tokens de prompt atendidos pelo cache subiu de 56% para 86% com 4 sessões simultâneas, e o tempo mediano até o primeiro byte caiu de 2,05 para 0,38 s. Os tokens de saída por minuto foram maiores em todas as etapas que rodamos, e o p95 do tempo até o primeiro byte (os 5% mais lentos) foi menor em todas as etapas. O número de réplicas trabalhando quase não mudou (2,71 contra 2,83 de quatro com 4 sessões): o ganho vem da reutilização do cache, não de mais placas trabalhando.
As etapas de 24 e 32 sessões são uma sobrecarga proposital de quatro placas pequenas, em que as esperas chegam a dezenas de segundos com ou sem afinidade. É ali que aparece a contrapartida: a cauda continua menor com afinidade, mas a mediana é maior. Os números vêm a seguir.
GPUs
4 × NVIDIA RTX A4000, 16 GiB cada
Modelo
qwen3-4b-dp4 (Qwen/Qwen3-4B-Instruct-2507), bf16
Layout
data_parallel_size 4, tensor_parallel_size 1
vLLM
0.26.0
LM Warden
Esta versão
Capturado
4 de outubro de 2026, as duas variantes em sequência
Carga
Sessões sintéticas no estilo do Claude Code, geradas pela nossa própria ferramenta de teste, não pelo Claude Code em si: um prompt de sistema compartilhado de cerca de 3,5 mil tokens, uma primeira mensagem exclusiva da sessão (6 mil nominais, cerca de 7,2 mil a 7,5 mil medidos), depois mais cinco turnos de cerca de 400 tokens novos cada, no máximo 256 tokens de saída por turno. Ciclo fechado: uma sessão começa o próximo turno quando o anterior termina. 3 minutos por etapa.
Fig. 7Tempo até o primeiro byte com 4 a 32 sessões simultâneas, mediana e p95, em escala logarítmica para que as etapas abaixo de um segundo possam ser lidas ao lado das que levam minutos. Com afinidade, a mediana é bem menor até 16 sessões (0,38 contra 2,05 s com 4) e maior com 24 e 32; o p95 é menor em todas as etapas, embora com 16 a diferença (24,9 contra 26,2 s) esteja dentro do ruído de uma execução por variante. Medido no cliente, pela internet, até o primeiro token em streaming.
Sessions
Sessions/h off → on
Output tokens/min off → on
TTFB p50 off → on (s)
TTFB p95 off → on (s)
Replicas busy off → on
Prefix hits off → on (%)
Stayed on replica (%)
4
180 → 240
5,886 → 6,744
2.05 → 0.38
3.5 → 2.84
2.71 → 2.83
56.2 → 86.4
100
8
300 → 380
8,364 → 10,752
2.33 → 0.48
6.32 → 5.03
3.74 → 3.74
44.3 → 86.1
100
16
300 → 360
9,558 → 12,204
3.25 → 0.85
26.24 → 24.88
3.91 → 3.69
33.2 → 48.6
100
24
300 → 420
9,048 → 11,178
5.06 → 13.14
58.82 → 38.34
3.91 → 4
32.8 → 37.9
89.1
32
520 → 620
14,760 → 16,638
12.32 → 27.66
82.84 → 38.92
4 → 4
31.6 → 31.6
67.3
Medido na nossa máquina de quatro placas com um modelo pequeno, primeiro com a afinidade desligada e depois ligada, sem reiniciar o vLLM entre as rodadas: a segunda variante começou com o cache de prefixos já aquecido, e as duas variantes geraram os prompts a partir da mesma semente. Cada etapa dura 3 minutos, então completa só 9 a 31 sessões, e uma sessão a mais ou a menos muda as sessões por hora em 20; os tokens de saída por minuto são a coluna mais estável. O seu modelo, as suas placas e a sua carga de trabalho serão diferentes; o painel de réplicas na página de um modelo mostra os mesmos contadores para o seu caso.
Até 16 sessões, a afinidade fica à frente em todas as etapas em vazão, acertos do cache de prefixos e nas duas colunas de tempo até o primeiro byte: os acertos vão de 56% para 86% com 4 sessões, o tempo mediano até o primeiro byte de 2,05 para 0,38 s, e os tokens de saída de 5.886 para 6.744 por minuto (sessões por hora de 180 para 240). Com 24 e 32 sessões, as etapas de sobrecarga, todas as réplicas estão saturadas. O número de tokens de saída ainda é maior (11.178 contra 9.048 e 16.638 contra 14.760 tokens por minuto) e a cauda lenta é bem menor (p95 38 contra 59 s, e 39 contra 83 s), mas o tempo mediano até o primeiro byte é pior com afinidade: 13,1 contra 5,1 s com 24 sessões, 27,7 contra 12,3 s com 32. Ainda não isolamos a causa, e baixar o limite de transbordo de 8 para 4 não mudou isso. A vantagem é maior enquanto há folga; uma máquina que roda no limite deve medir as duas configurações, e a afinidade pode ser desligada por modelo.
Fig. 8Réplicas ocupadas, de quatro: quantas réplicas tinham solicitações em execução em cada amostragem, em média ao longo de uma etapa. Não é a utilização da GPU. A afinidade quase não muda isso; o ganho está na fig. 9.
Fig. 9Taxa de acerto do cache de prefixos em cada etapa: tokens de prompt atendidos pelo cache divididos pelos tokens de prompt solicitados, somando as quatro réplicas, calculada pela variação dos contadores do próprio vLLM durante a etapa. O ganho se mantém enquanto há folga e desaparece com 32 sessões, quando as conversas transbordam.
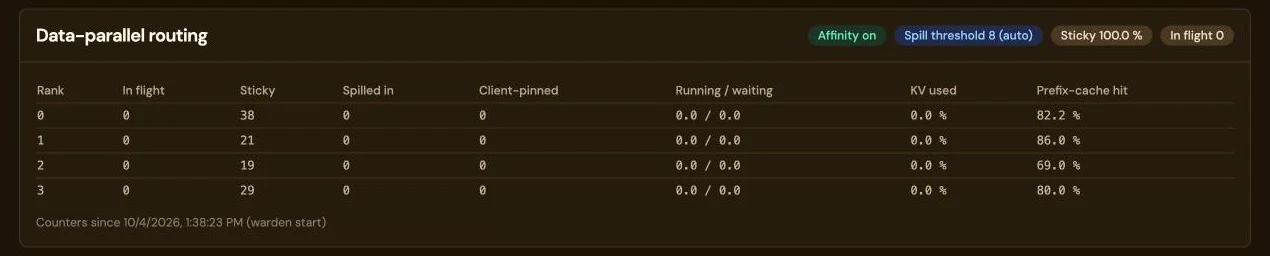
Afinidade ligada, limite de transbordo 8 (auto)Taxa de acerto por réplica, dos próprios contadores do vLLM
Fig. 10Os mesmos contadores na página de um modelo: uma linha por réplica com as solicitações que ela tem, quantas conversas ficaram (sticky) ou chegaram por transbordo, o que está em execução e em espera, o cache KV em uso e a taxa de acerto do cache de prefixos. Registrado em 4 de outubro de 2026 com a afinidade ligada e o limite de transbordo em 8 (auto): sticky 100%, 38, 21, 19 e 29 solicitações sticky nas réplicas 0 a 3, e uma taxa de acerto do cache de prefixos de 82,2; 86,0; 69,0 e 80,0%. Os contadores começaram na reinicialização do warden, e todo o tráfego nesse período rodou com a afinidade ligada: sessões sintéticas de agentes mais turnos reais do Claude Code. É uma captura do painel, não um resultado de teste. Role a imagem para o lado para ver todas as colunas.
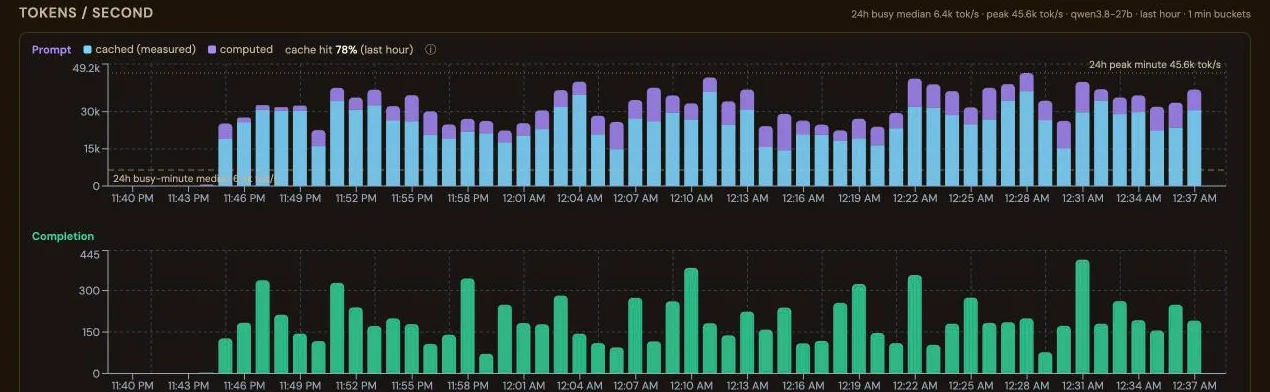
A máquina que primeiro motivou o roteamento de réplicas usa esse roteamento desde então. Ela tem sete RTX 5090 servindo um modelo de 27B como sete réplicas de uma placa para um grupo de agentes Claude Code headless. A nossa primeira regra de posicionamento fazia hash do id de sessão: era estável, mas ignorava a carga. Com 26 sessões de agentes de cerca de 58 mil tokens cada, três réplicas ficaram ociosas enquanto outras levavam o cache a 93%, e a parcela de tokens de prompt atendidos pelo cache caiu de 81% depois de uma reinicialização para 28% em cerca de 35 minutos. Então reduzimos o grupo para 16 sessões, cerca de duas por réplica, para que os conjuntos de trabalho coubessem no cache, e passamos a colocar conversas novas na réplica menos carregada. Na hora seguinte, a taxa ficou em 78 a 79%. Isso é uma observação, não um teste A/B: uma carga de trabalho e duas mudanças feitas juntas, então o ganho não é só do posicionamento. A regra prática que isso sugere: mantenha o número de sessões simultâneas multiplicado pelo contexto típico delas abaixo do cache total da máquina.
Medido pelo mecanismo, por solicitação
Fig. 11Tokens de prompt por segundo na máquina de sete GPUs, divididos entre o que cada réplica leu do cache de prefixos e o que teve de calcular, com a parcela da última hora: 78%. A parte em cache é a contagem do próprio mecanismo para cada solicitação concluída, não uma estimativa; uma solicitação que ele não mediu conta como calculada. Registrado em 5 de outubro de 2026. Role a imagem para o lado para ver a hora inteira.
 Afinidade ligada, limite de transbordo 8 (auto)
Taxa de acerto por réplica, dos próprios contadores do vLLM
 Medido pelo mecanismo, por solicitação