Cada turno va a parar a la réplica donde el anterior dejó su caché.
Un agente reenvía todo su historial en cada turno, así que una conversación larga es, sobre todo, un prefijo que el motor ya ha leído. vLLM guarda ese trabajo en su caché de prefijos (el estado de atención de los prompts que ya ha visto) y se lo ahorra la próxima vez que llega el mismo prefijo, pero solo en la réplica que hizo el trabajo: cada copia completa del modelo tiene su propia caché. El propio balanceador de vLLM envía cada turno a la réplica con la cola más corta, que normalmente nunca ha visto la conversación, así que vuelve a leer todo el historial. LM Warden asigna cada conversación nueva a la réplica menos cargada (según las solicitudes en curso, lo llena que está su caché y cuántas conversaciones activas tiene) y la mantiene allí, gracias al ID de sesión que Claude Code ya envía. Solo mueve una solicitud cuando esa réplica supera su umbral de desbordamiento: de forma predeterminada, cuando las solicitudes en curso superan un cuarto del límite de secuencias simultáneas del modelo, 8 en nuestra máquina de cuatro tarjetas.
Las réplicas, y por tanto este enrutamiento, forman parte de la instalación de Linux con GPU NVIDIA; la app para Mac (beta) no tiene paralelismo de tensores ni de datos.
Fig. 6Cuatro turnos de una conversación en un modelo con cuatro réplicas. Con el balanceador de vLLM, cada turno pasa por el prefill (el motor lee el prompt y lo carga en la caché) casi desde cero en la réplica que lo recibe. Con LM Warden, la conversación se queda en la réplica 2 y solo el turno nuevo pasa por el prefill. Es un esquema del mecanismo, no una medición.
Medido en la máquina de cuatro tarjetas: con cada conversación fijada a su réplica, la proporción de tokens de prompt servidos desde la caché subió del 56 al 86 % con 4 sesiones simultáneas, y la mediana del tiempo hasta el primer byte bajó de 2,05 a 0,38 s. Los tokens de salida por minuto fueron mayores en todos los escalones que probamos, y el p95 del tiempo hasta el primer byte (el 5 % más lento) fue menor en todos ellos. El número de réplicas con trabajo apenas cambió (2,71 frente a 2,83 de cuatro con 4 sesiones): la mejora viene de reutilizar la caché, no de tener más tarjetas trabajando.
Los escalones de 24 y 32 sesiones son una sobrecarga deliberada de cuatro tarjetas pequeñas, donde las esperas llegan a decenas de segundos con o sin afinidad. Ahí se ve la contrapartida: con afinidad, las solicitudes más lentas siguen tardando menos, pero la mediana es más alta. A continuación, las cifras.
GPU
4 × NVIDIA RTX A4000, 16 GiB cada una
Modelo
qwen3-4b-dp4 (Qwen/Qwen3-4B-Instruct-2507), bf16
Distribución
data_parallel_size 4, tensor_parallel_size 1
vLLM
0.26.0
LM Warden
Esta versión
Captura
4 de octubre de 2026, las dos variantes una tras otra
Carga
Sesiones sintéticas al estilo de Claude Code generadas con nuestro propio banco de pruebas, no con Claude Code: un prompt de sistema compartido de unos 3,5 mil tokens, un primer mensaje propio de cada sesión (6 mil nominales; entre 7,2 mil y 7,5 mil medidos) y luego cinco turnos más de unos 400 tokens nuevos cada uno, con un máximo de 256 tokens de salida por turno. Bucle cerrado: una sesión empieza el siguiente turno cuando termina el anterior. 3 minutos por escalón.
Fig. 7Tiempo hasta el primer byte con 4 a 32 sesiones simultáneas, mediana y p95, en escala logarítmica para que los escalones de menos de un segundo se puedan comparar con los de un minuto. Con afinidad, la mediana es mucho más baja hasta 16 sesiones (0,38 frente a 2,05 s con 4) y más alta con 24 y 32; el p95 es menor en todos los escalones, aunque con 16 la diferencia (24,9 frente a 26,2 s) está dentro del ruido de una sola ejecución por variante. Medido en el cliente, a través de internet, hasta el primer token recibido.
Sessions
Sessions/h off → on
Output tokens/min off → on
TTFB p50 off → on (s)
TTFB p95 off → on (s)
Replicas busy off → on
Prefix hits off → on (%)
Stayed on replica (%)
4
180 → 240
5,886 → 6,744
2.05 → 0.38
3.5 → 2.84
2.71 → 2.83
56.2 → 86.4
100
8
300 → 380
8,364 → 10,752
2.33 → 0.48
6.32 → 5.03
3.74 → 3.74
44.3 → 86.1
100
16
300 → 360
9,558 → 12,204
3.25 → 0.85
26.24 → 24.88
3.91 → 3.69
33.2 → 48.6
100
24
300 → 420
9,048 → 11,178
5.06 → 13.14
58.82 → 38.34
3.91 → 4
32.8 → 37.9
89.1
32
520 → 620
14,760 → 16,638
12.32 → 27.66
82.84 → 38.92
4 → 4
31.6 → 31.6
67.3
Medido en nuestra máquina de cuatro tarjetas con un modelo pequeño, primero sin afinidad y después con ella, sin reiniciar vLLM entre medias: la segunda variante empezó con la caché de prefijos ya caliente, y ambas generaron sus prompts con la misma semilla. Cada escalón dura 3 minutos, así que solo completa entre 9 y 31 sesiones, y una sesión de más o de menos cambia las sesiones por hora en 20; los tokens de salida por minuto son la columna más estable. Tu modelo, tus tarjetas y tu carga de trabajo serán distintos; el panel de réplicas en la página de un modelo muestra los mismos contadores para los tuyos.
Hasta 16 sesiones, la afinidad va por delante en todos los escalones en rendimiento, aciertos de la caché de prefijos y las dos columnas de tiempo hasta el primer byte: los aciertos pasan del 56 al 86 % con 4 sesiones, la mediana del tiempo hasta el primer byte de 2,05 a 0,38 s y la salida de 5.886 a 6.744 tokens por minuto (las sesiones por hora, de 180 a 240). Con 24 y 32 sesiones, los escalones de sobrecarga, todas las réplicas están saturadas. La salida sigue siendo mayor (11.178 frente a 9.048 y 16.638 frente a 14.760 tokens por minuto) y las solicitudes más lentas tardan mucho menos (p95 38 frente a 59 s, y 39 frente a 83 s), pero la mediana del tiempo hasta el primer byte es peor con afinidad: 13,1 frente a 5,1 s con 24 sesiones y 27,7 frente a 12,3 s con 32. No hemos aislado la causa, y bajar el umbral de desbordamiento de 8 a 4 no cambió nada. La ventaja es mayor mientras hay margen; si tu máquina funciona al límite, compara ambas configuraciones; la afinidad se puede desactivar por modelo.
Fig. 8Réplicas ocupadas, de cuatro: réplicas con solicitudes en ejecución en cada sondeo, promediadas en cada escalón. No es el uso de la GPU. La afinidad apenas lo cambia; la mejora está en la fig. 9.
Fig. 9Tasa de aciertos de la caché de prefijos en cada escalón: tokens de prompt servidos desde la caché divididos entre los tokens de prompt solicitados, sumando las cuatro réplicas, según la variación de los contadores del propio vLLM durante el escalón. La mejora se mantiene mientras hay margen y desaparece con 32 sesiones, cuando las conversaciones se desbordan a otras réplicas.
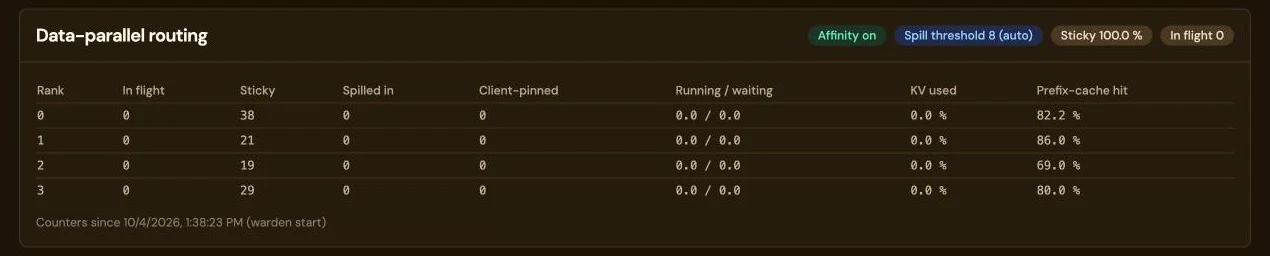
Afinidad activada, umbral de desbordamiento 8 (auto)Tasa de aciertos por réplica, según los contadores del propio vLLM
Fig. 10Los mismos contadores en la página de un modelo: una fila por réplica con las solicitudes que tiene en curso, cuántas conversaciones se quedaron (sticky) o llegaron por desbordamiento, lo que se está ejecutando y lo que espera, la caché KV en uso y la tasa de aciertos de la caché de prefijos. Captura del 4 de octubre de 2026 con la afinidad activada y el umbral de desbordamiento en 8 (auto): sticky 100 %; 38, 21, 19 y 29 solicitudes sticky en las réplicas 0 a 3, y una tasa de aciertos de la caché de prefijos de 82,2; 86,0; 69,0 y 80,0 %. Los contadores acumulan desde el reinicio del warden, y todo el tráfico de ese intervalo se ejecutó con la afinidad activada: sesiones de agente sintéticas y turnos reales de Claude Code. Es una captura del panel, no un resultado de medición. Desplaza la imagen lateralmente para ver todas las columnas.
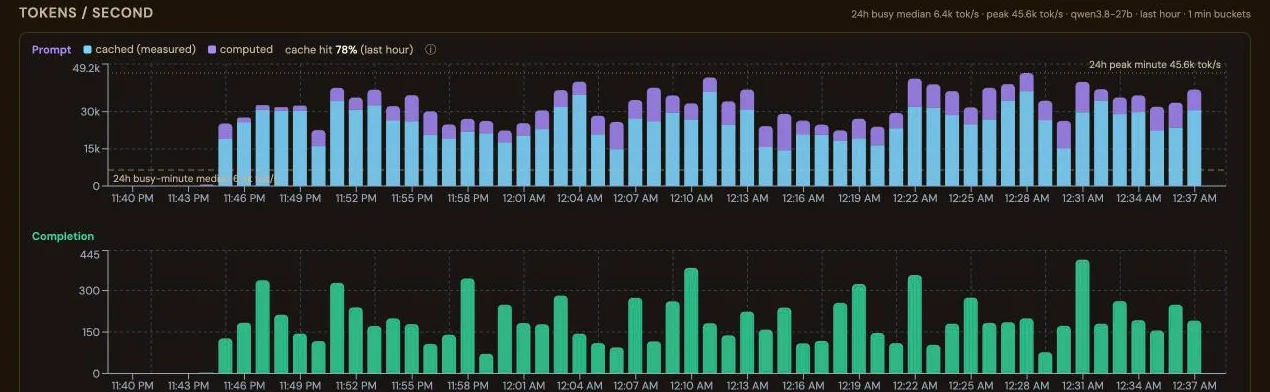
La máquina que nos llevó a crear el enrutamiento por réplicas lo usa desde entonces. Tiene siete RTX 5090 que sirven un modelo 27B como siete réplicas de una tarjeta cada una a una granja de agentes de Claude Code sin interfaz gráfica. Nuestra primera regla de asignación aplicaba un hash al ID de sesión: cada sesión se quedaba siempre en la misma réplica, pero sin tener en cuenta la carga. Con 26 sesiones de agente de unos 58 mil tokens cada una, tres réplicas estaban inactivas mientras otras llenaban su caché hasta el 93 %, y la proporción de tokens de prompt servidos desde la caché cayó del 81 % tras un reinicio al 28 % en unos 35 minutos. Entonces redujimos la granja a 16 sesiones, unas dos por réplica, para que los conjuntos de trabajo cupieran en la caché, y empezamos a asignar las conversaciones nuevas a la réplica menos cargada. Durante la hora siguiente, esa proporción se mantuvo entre el 78 y el 79 %. Es una observación, no una prueba A/B: una sola carga de trabajo y dos cambios hechos a la vez, así que la mejora no se debe solo a la asignación. La regla práctica que se desprende: que el número de sesiones simultáneas multiplicado por su contexto típico no supere la caché total de la máquina.
Medido por el motor, por solicitud
Fig. 11Tokens de prompt por segundo en la máquina de siete GPU, divididos entre lo que cada réplica leyó de su caché de prefijos y lo que tuvo que calcular, con la proporción de la última hora: 78 %. La parte servida desde la caché es el recuento del propio motor para cada solicitud terminada, no una estimación; una solicitud que el motor no midió cuenta como calculada. Captura del 5 de octubre de 2026. Desplaza la imagen lateralmente para ver toda la hora.
 Afinidad activada, umbral de desbordamiento 8 (auto)
Tasa de aciertos por réplica, según los contadores del propio vLLM
 Medido por el motor, por solicitud