Następna tura trafia tam, gdzie poprzednia zostawiła swój cache.
Agent w każdej turze wysyła ponownie całą historię, więc długa rozmowa to głównie prefiks, który silnik już przeczytał. vLLM przechowuje tę pracę w cache prefiksów (stan uwagi promptów, które już widział) i pomija ją, gdy ten sam prefiks przyjdzie następnym razem, ale tylko na replice, która tę pracę wykonała: każda pełna kopia modelu ma własny cache. Własny mechanizm równoważenia obciążenia vLLM wysyła każdą turę do repliki z najkrótszą kolejką, która zwykle nigdy nie widziała tej rozmowy, więc czyta całą historię od nowa. LM Warden umieszcza każdą nową rozmowę na najmniej obciążonej replice (żądania w toku, zapełnienie cache i liczba aktywnych rozmów) i trzyma ją tam, używając identyfikatora sesji, który Claude Code już wysyła. Przenosi żądanie tylko wtedy, gdy replika przekroczy próg przepełnienia: domyślnie gdy żądań w toku jest więcej niż ćwierć limitu równoczesnych sekwencji modelu, 8 na naszym serwerze z czterema kartami.
Repliki, a więc i ten routing, są częścią instalacji dla systemu Linux z kartami NVIDIA; aplikacja na Maca (beta) nie ma równoległości tensorowej ani równoległości danych.
Rys. 6Cztery tury jednej rozmowy na modelu z czterema replikami. Z mechanizmem równoważenia obciążenia vLLM każda tura przechodzi prefill (wczytanie promptu do cache) niemal od zera na tej replice, która ją dostała. Z LM Warden rozmowa zostaje na replice 2 i prefill przechodzi tylko nowa tura. Rysunek mechanizmu, a nie pomiar.
Zmierzone na serwerze z czterema kartami: przy przypiętych rozmowach udział tokenów promptu obsłużonych z cache wzrósł z 56 do 86% przy 4 równoczesnych sesjach, a mediana czasu do pierwszego bajtu spadła z 2,05 do 0,38 s. Liczba tokenów wyjściowych na minutę była wyższa na każdym przeprowadzonym przez nas etapie, a p95 czasu do pierwszego bajtu (najwolniejsze 5%) niższe na każdym etapie. Liczba pracujących replik prawie się nie zmieniła (2,71 wobec 2,83 z czterech przy 4 sesjach): zysk to ponowne użycie cache, a nie więcej pracujących kart.
Etapy z 24 i 32 sesjami to celowe przeciążenie czterech małych kart, przy którym czekanie sięga dziesiątek sekund z koligacją lub bez. Tam widać kompromis: ogon jest nadal krótszy z koligacją, ale mediana jest dłuższa. Liczby poniżej.
Karty GPU
4 × NVIDIA RTX A4000, każda 16 GiB
Model
qwen3-4b-dp4 (Qwen/Qwen3-4B-Instruct-2507), bf16
Układ
data_parallel_size 4, tensor_parallel_size 1
vLLM
0.26.0
LM Warden
To wydanie
Zarejestrowano
4 października 2026 r., oba warianty jeden po drugim
Obciążenie
Syntetyczne sesje w stylu Claude Code z naszego własnego narzędzia testowego, a nie sam Claude Code: wspólny prompt systemowy o długości około 3,5 tys. tokenów, pierwsza wiadomość unikalna dla sesji (nominalnie 6 tys., zmierzone około 7,2–7,5 tys.), potem jeszcze pięć tur po około 400 nowych tokenów każda, maksymalnie 256 tokenów wyjściowych na turę. Pętla zamknięta: sesja zaczyna następną turę, gdy poprzednia się kończy. 3 minuty na etap.
Rys. 7Czas do pierwszego bajtu przy 4–32 równoczesnych sesjach, mediana i p95, w skali logarytmicznej, aby etapy poniżej sekundy dało się odczytać obok tych trwających minutę. Z koligacją mediana jest znacznie niższa do 16 sesji (0,38 wobec 2,05 s przy 4) i wyższa przy 24 i 32; p95 jest niższy na każdym etapie, choć przy 16 różnica (24,9 wobec 26,2 s) mieści się w szumie jednego przebiegu na wariant. Zmierzone po stronie klienta, przez internet, do pierwszego strumieniowanego tokenu.
Sessions
Sessions/h off → on
Output tokens/min off → on
TTFB p50 off → on (s)
TTFB p95 off → on (s)
Replicas busy off → on
Prefix hits off → on (%)
Stayed on replica (%)
4
180 → 240
5,886 → 6,744
2.05 → 0.38
3.5 → 2.84
2.71 → 2.83
56.2 → 86.4
100
8
300 → 380
8,364 → 10,752
2.33 → 0.48
6.32 → 5.03
3.74 → 3.74
44.3 → 86.1
100
16
300 → 360
9,558 → 12,204
3.25 → 0.85
26.24 → 24.88
3.91 → 3.69
33.2 → 48.6
100
24
300 → 420
9,048 → 11,178
5.06 → 13.14
58.82 → 38.34
3.91 → 4
32.8 → 37.9
89.1
32
520 → 620
14,760 → 16,638
12.32 → 27.66
82.84 → 38.92
4 → 4
31.6 → 31.6
67.3
Zmierzone na naszym serwerze z czterema kartami na małym modelu, najpierw z wyłączoną koligacją, potem z włączoną, bez ponownego uruchamiania vLLM pomiędzy: drugi wariant zaczynał z rozgrzanym cache prefiksów, a w obu wariantach prompty losowano z tym samym ziarnem generatora. Każdy etap trwa 3 minuty, więc kończy się w nim tylko od 9 do 31 sesji, a jedna sesja więcej lub mniej zmienia liczbę sesji na godzinę o 20; stabilniejszą kolumną są tokeny wyjściowe na minutę. Twój model, karty i obciążenie będą inne; karta replik na stronie modelu pokazuje te same liczniki dla twojego systemu.
Do 16 sesji koligacja prowadzi na każdym etapie pod względem przepustowości, trafień w cache prefiksów i obu kolumn czasu do pierwszego bajtu: trafienia rosną z 56 do 86% przy 4 sesjach, mediana czasu do pierwszego bajtu spada z 2,05 do 0,38 s, a liczba tokenów wyjściowych rośnie z 5 886 do 6 744 na minutę (sesji na godzinę ze 180 do 240). Przy 24 i 32 sesjach, czyli na etapach przeciążenia, każda replika jest nasycona. Liczba tokenów wyjściowych jest nadal wyższa (11 178 wobec 9 048 i 16 638 wobec 14 760 na minutę), a wolny ogon znacznie krótszy (p95 38 wobec 59 s oraz 39 wobec 83 s), ale mediana czasu do pierwszego bajtu jest z koligacją gorsza: 13,1 wobec 5,1 s przy 24 sesjach, 27,7 wobec 12,3 s przy 32. Nie ustaliliśmy przyczyny, a obniżenie progu przepełnienia z 8 do 4 tego nie zmieniło. Przewaga jest największa, dopóki jest zapas; serwer pracujący na granicy możliwości powinien zmierzyć oba ustawienia, a koligację można wyłączyć dla każdego modelu osobno.
Rys. 8Zajęte repliki z czterech: repliki z wykonywanymi żądaniami przy każdym odpytaniu, uśrednione w ramach etapu. To nie jest wykorzystanie GPU. Koligacja prawie tego nie zmienia; zysk widać na rys. 9.
Rys. 9Współczynnik trafień w cache prefiksów na każdym etapie: stosunek tokenów promptu obsłużonych z cache do wszystkich żądanych tokenów promptu, łącznie dla czterech replik, na podstawie zmiany własnych liczników vLLM w ramach etapu. Zysk utrzymuje się, dopóki jest zapas, i znika przy 32 sesjach, gdy rozmowy przechodzą na inne repliki.
Koligacja włączona, próg przepełnienia 8 (auto)Współczynnik trafień dla każdej repliki, z własnych liczników vLLM
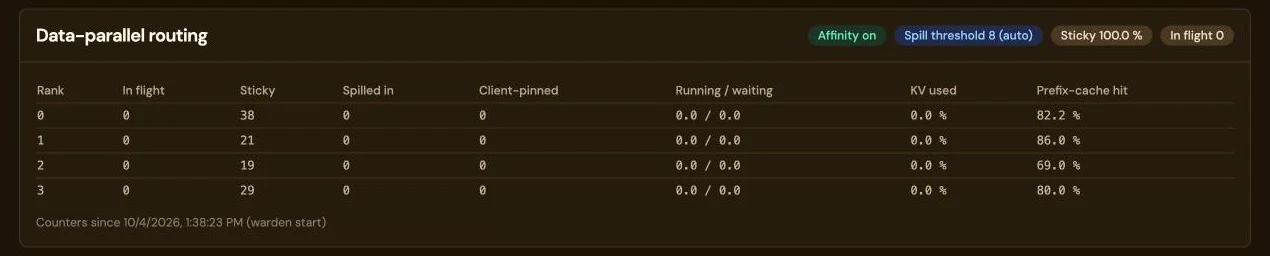
Rys. 10Te same liczniki na stronie modelu: jeden wiersz na replikę z żądaniami, które obsługuje, liczbą rozmów, które zostały (sticky) lub trafiły tu po przepełnieniu innej repliki, tym, co jest wykonywane i oczekuje, użyciem cache KV i współczynnikiem trafień w cache prefiksów. Zarejestrowano 4 października 2026 r. z włączoną koligacją i progiem przepełnienia 8 (auto): sticky 100%, 38, 21, 19 i 29 żądań sticky na replikach od 0 do 3 oraz współczynnik trafień w cache prefiksów 82,2; 86,0; 69,0 i 80,0%. Liczniki działają od restartu LM Warden, a cały ruch w tym oknie odbywał się z włączoną koligacją: syntetyczne sesje agentów plus prawdziwe tury Claude Code. To zrzut panelu, a nie wynik testu. Przewiń obraz w bok, aby zobaczyć wszystkie kolumny.
Serwer, przez który w ogóle zajęliśmy się routingiem replik, działa z nim od tamtej pory. Ma siedem kart RTX 5090 obsługujących model 27B jako siedem jednokartowych replik dla dużej grupy agentów Claude Code działających w trybie headless. Nasza pierwsza reguła rozmieszczania haszowała identyfikator sesji, co dawało stabilność, ale nie uwzględniało obciążenia. Przy 26 sesjach agentów po około 58 tys. tokenów każda trzy repliki stały bezczynnie, podczas gdy inne zapełniały cache do 93%, a udział tokenów promptu obsłużonych z cache spadł z 81% po restarcie do 28% w ciągu około 35 minut. Wtedy zmniejszyliśmy liczbę sesji do 16, około dwóch na replikę, tak aby zbiory robocze mieściły się w cache, i zaczęliśmy umieszczać nowe rozmowy na najmniej obciążonej replice. Przez następną godzinę udział wynosił 78–79%. To obserwacja, a nie test A/B: jedno obciążenie i dwie zmiany wprowadzone razem, więc zysk nie jest wyłącznie zasługą rozmieszczania. Praktyczna reguła, jaka z tego wynika: liczba równoczesnych sesji pomnożona przez ich typowy kontekst powinna być mniejsza niż łączny cache serwera.
Zmierzone przez silnik dla każdego żądania
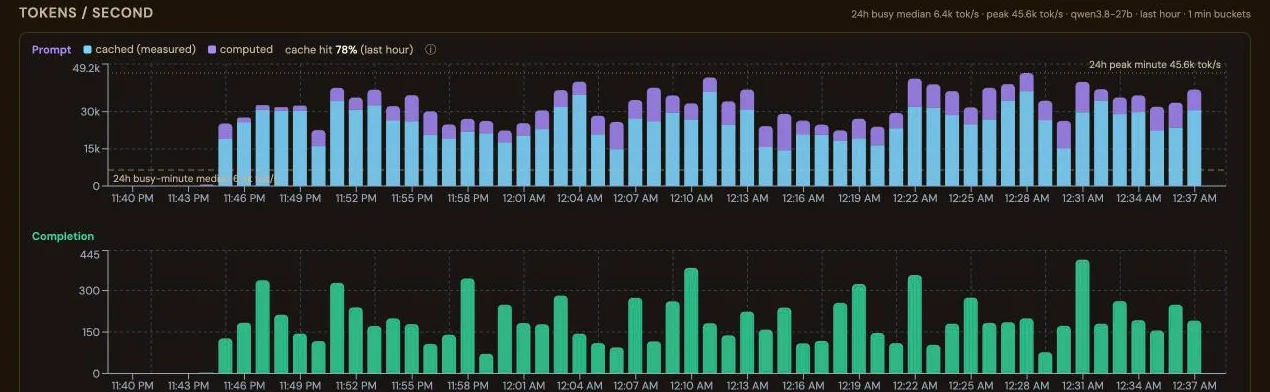
Rys. 11Tokeny promptu na sekundę na serwerze z siedmioma kartami GPU, podzielone na to, co każda replika odczytała z cache prefiksów, i to, co musiała obliczyć, z udziałem z ostatniej godziny: 78%. Część z cache to własny licznik silnika dla każdego zakończonego żądania, a nie szacunek; żądanie, którego silnik nie zmierzył, liczy się jako obliczone. Zarejestrowano 5 października 2026 r. Przewiń obraz w bok, aby zobaczyć całą godzinę.
 Koligacja włączona, próg przepełnienia 8 (auto)
Współczynnik trafień dla każdej repliki, z własnych liczników vLLM
 Zmierzone przez silnik dla każdego żądania