LM Warden

Drobniejsze rzeczy, które odkryjesz, gdy już go uruchomisz.

God mode
Obserwuj prompty i odpowiedzi jednego klucza na bieżąco w panelu na jego stronie. Przechowywane tylko w pamięci, strumieniowane tylko, gdy panel jest otwarty, i wyłączone, dopóki nie ustawisz VW_GODMODE_ENABLED.
Tokeny administratora
Tokeny vwa_ pozwalają skryptom, CI i agentom korzystać z API sterowania bez hasła administratora, plików cookie sesji ani nagłówka CSRF. Pokazywane raz, przechowywane jako skrót SHA-256.
Menedżer cache HuggingFace
Co jest na dysku i do którego modelu należy. Usuwaj osierocone pliki oraz eksportuj lub importuj cały cache jako archiwum tar.
Jeden port
Interfejs, API sterowania i /v1 dzielą :8080. Twój własny terminator TLS, ingress lub SSO działa przed nim bez zmian.
Nie wymaga dostępu do internetu
Trzy archiwa tar z obrazami i opcjonalne archiwum tar z cache modeli to wszystko, co trzeba przenieść na host w sieci odizolowanej (air-gapped). HF_HUB_OFFLINE=1 blokuje nawet pobieranie wag.
Statystyki Router
Każda decyzja w /router/stats: lokalnie, przekazane, przekierowane awaryjnie, odrzucone, z powodem, dla każdej reguły i każdego celu, oraz stan bezpiecznika. Liczniki działają w obrębie procesu; nagłówki ani treść żądań nigdy nie są zapisywane.
Strona konfiguracji dla każdego klienta
Connect zapisuje konfigurację dla Claude Code, Codex CLI, OpenCode, Aider, Grok CLI, zestawów SDK Anthropic i OpenAI oraz trzech edytorów, z adresem tej instancji LM Warden, kluczem i załadowanym modelem, i wysyła żądanie testowe.
Codex CLI
Uruchomione na instancji LM Warden 5 października 2026 r. z Codex 0.160: wywołania narzędzia powłoki, edycja pliku, sesja utrzymana na jednej replice. Rozumowanie jest domyślnie włączone; model_reasoning_effort = "none" je wyłącza. Tylko modele lokalne: reguły routera nie mają zastosowania.
Czat testowy (playground)
Porozmawiaj z załadowanym modelem w przeglądarce, także z obrazami, zanim komukolwiek dasz klucz.

Trzy rzeczy, których nauczyliśmy się na własnej skórze.

Silnik przestał działać cztery razy w ciągu jednego dnia, a proxy nadal przekazywało do niego żądania.

Rdzeń silnika vLLM ulegał awarii, podczas gdy otaczający go wrapper vllm serve nadal działał, więc proces wyglądał na żywy, a żądania wciąż do niego trafiały. Teraz watchdog odpytuje endpoint /health samego silnika zamiast tablicy procesów. Gdy silnik przestaje odpowiadać, watchdog zachowuje dane diagnostyczne, w tym ograniczony koniec logu, i ponownie ładuje model.

Panel logu modelu na żywo pod obciążeniem: wiersze serwera API vLLM odpowiadające na GET /metrics, POST /v1/chat/completions od klienta, wiersze silnika zgłaszające 10 wykonywanych żądań i 0 oczekujących oraz jeden wiersz GET /health, wszystkie zwracające 200 OK Sonda watchdoga, na którą odpowiada silnik
Rys. 15Log na żywo na stronie modelu podczas tego samego obciążenia: odczyty /metrics, napływające chat completions, licznik samego silnika – 10 wykonywanych żądań i żadne oczekujące – oraz jedna sonda /health pomiędzy nimi. Przewiń obraz w bok, aby przeczytać całe wiersze.

12-minutowe ładowanie kończyło się kiedyś błędem.

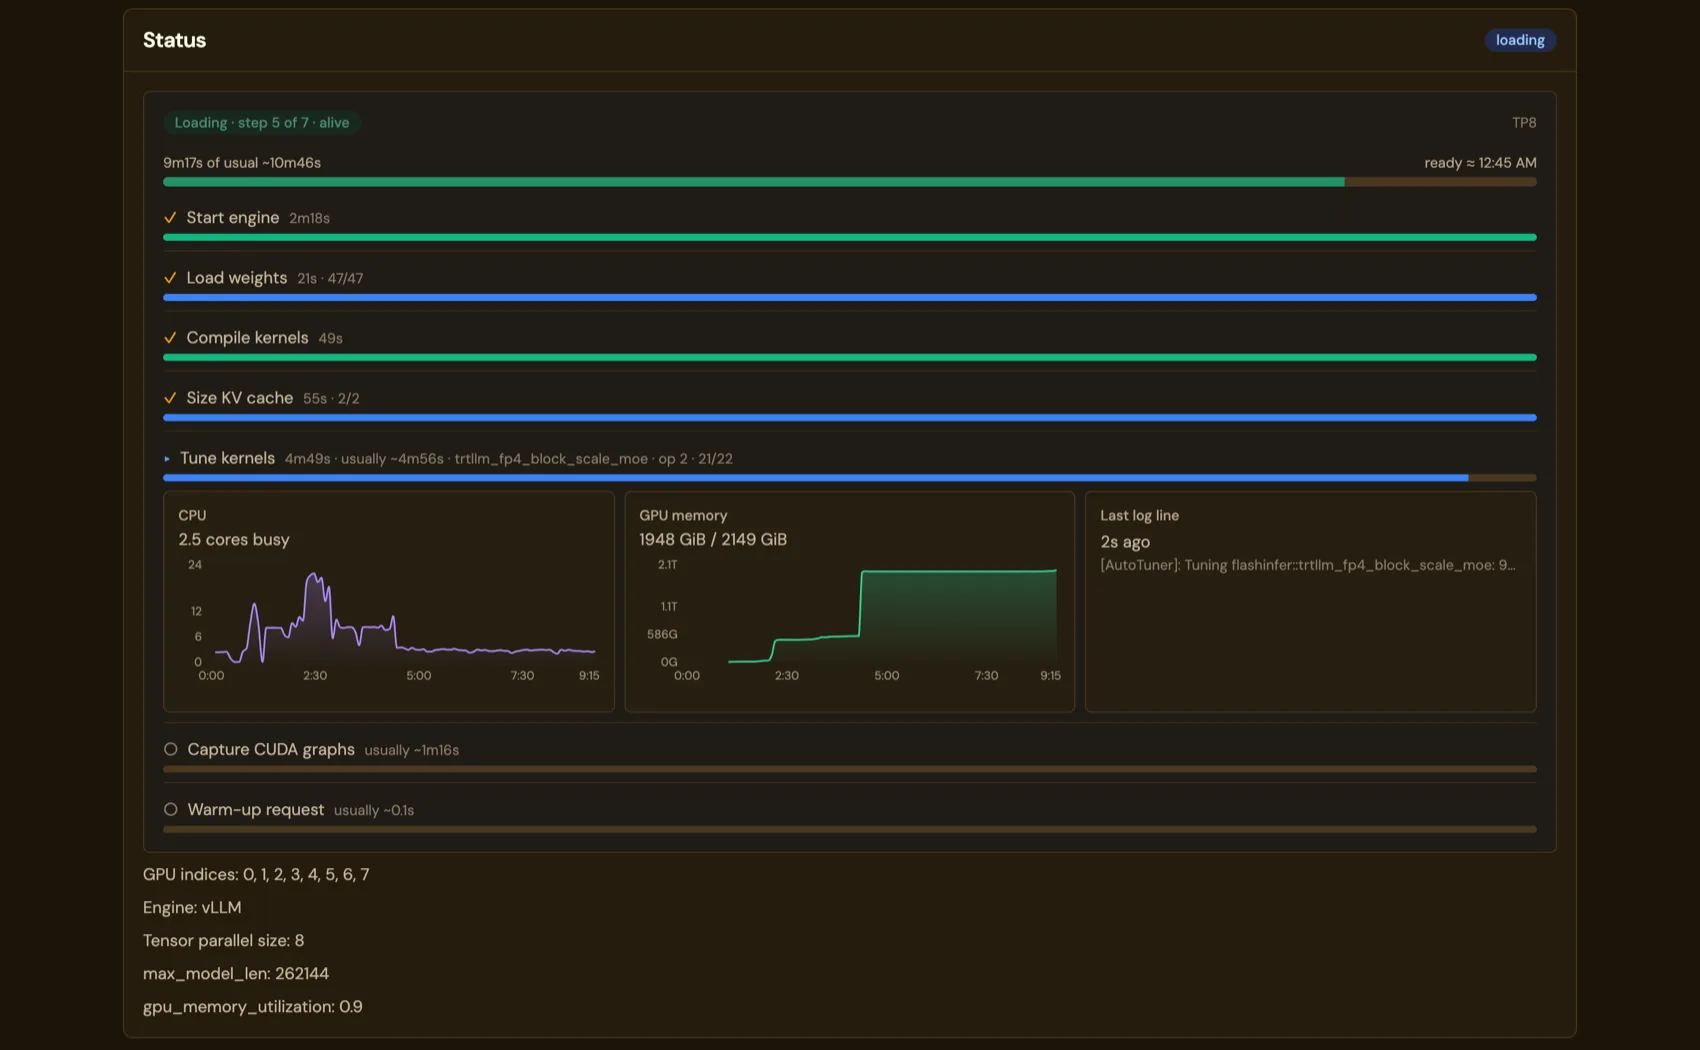
Duży model może się ładować dwanaście minut lub dłużej. Dotąd LM Warden stosował stały limit czasu: po jego upływie wpisywał do modelu czerwony błąd „still loading”, choć silnik dalej się ładował. Strona modelu pokazuje teraz każdy krok ładowania z paskiem postępu, zwykły czas każdego kroku z wcześniejszych ładowań oraz parametry życiowe CPU i pamięci GPU. Zawieszone ładowanie jest zatrzymywane, a jego karty GPU zwalniane; nic nie robi się czerwone, dopóki ładowanie postępuje. GLM-5.2 NVFP4 z równoległością tensorową 8 na ośmiu kartach NVIDIA B300 ładuje się w około 11–12 minut; tak długie ładowanie kiedyś trafiało na limit czasu 600 s.

Strona modelu podczas ładowania GLM-5.2 NVFP4 na ośmiu kartach NVIDIA B300: 9 min 17 s ze zwykłych 10 min 46 s; Start engine, Load weights 47 z 47, Compile kernels i Size KV cache ukończone; Tune kernels na op 2, 21 z 22; wykresy CPU i pamięci GPU z 1948 z 2149 GiB w użyciu; Capture CUDA graphs i Warm-up request jeszcze przed nami, każdy ze swoim zwykłym czasem
Rys. 16GLM-5.2 NVFP4 ładowany z równoległością tensorową 8 na ośmiu kartach B300, po dziewięciu minutach. Strojenie jąder to długi krok; wykresy pokazują, że silnik żyje, choć log tylko powtarza postęp strojenia.

Karta 16 GiB mieści mniej, niż wynika z arytmetyki.

Same wagi modelu bf16 8B to około 15 GiB, a podczas ładowania brakuje mu pamięci. Każdy wiersz poniżej sprawdziliśmy na kartach RTX A4000 i Quadro RTX 5000 z 16 GiB i ocenialiśmy, czytając odpowiedzi modelu w czacie testowym, a nie ufając kontroli stanu.

ModelCo działaCo nie działa
openai/gpt-oss-20bDwie karty, równoległość tensorowa 2, max_model_len 32000, gpu_memory_utilization od 0,7 do 0,9Jedna karta: MoE 20B się nie mieści
Llama 3.1 8B, klasa Mistral 7BJedna karta, z punktem kontrolnym AWQ-INT4, --enforce-eager i gpu_memory_utilization 0,9Repozytorium bf16: około 15 GiB wag, brak pamięci podczas ładowania
Dwa modele narazJeden model na kartę, każdy mieszczący się na własnej karcieDwa modele dzielące jedną kartę

Sprawdzone na vLLM 0.20.0. Powyższe pomiary replik wykonano na 0.26.0. To wydanie zawiera 0.32.0; pierwsze zmierzone na nim ładowanie to GLM-5.2 NVFP4 z równoległością tensorową 8 na ośmiu kartach B300, około 11–12 minut. Reguł dopasowania nie zmierzono ponownie na 0.32. Pełna tabela i jej uzasadnienie są w HAZARDS.md. Nie masz NVIDIA? Dla procesorów Apple jest wersja beta na Maca, następny jest Windows, a inne karty GPU są w planach.