LM Warden

Мелочи, которые вы обнаружите, когда все заработает.

God mode
Промпты и ответы одного ключа в реальном времени — на панели на странице ключа. Данные хранятся только в памяти и передаются, только пока панель открыта; функция выключена, пока вы не зададите VW_GODMODE_ENABLED.
Административные токены
Токены vwa_ позволяют скриптам, CI и агентам работать с API управления без пароля администратора, файлов cookie и заголовка CSRF. Токен показывается один раз и хранится в виде хеша SHA-256.
Менеджер кэша Hugging Face
Что лежит на диске и какой модели это принадлежит. Удаляйте файлы, не привязанные ни к одной модели, экспортируйте или импортируйте весь кэш одним архивом tar.
Один порт
Консоль, API управления и /v1 работают на одном порту :8080. Перед ним можно без изменений поставить ваш собственный TLS-терминатор, ingress или SSO.
Доступ в интернет не нужен
Чтобы перенести все на сервер в изолированной сети, достаточно трех архивов с образами и, при желании, архива кэша моделей. HF_HUB_OFFLINE=1 отключает даже скачивание весов.
Статистика Router
Каждое решение — на /router/stats: локальная обработка, передача в Anthropic, резервное переключение, отказ с причиной — по каждому правилу и каждой целевой модели, а также состояние автоматического выключателя. Счетчики ведутся в пределах процесса; заголовки и тела запросов не сохраняются никогда.
Страница настройки для каждого клиента
Connect создает настройки для Claude Code, Codex CLI, OpenCode, Aider, Grok CLI, Anthropic SDK, OpenAI SDK и трех редакторов — с адресом этого сервера LM Warden, ключом и загруженной моделью — и отправляет тестовый запрос.
Codex CLI
Проверено на сервере LM Warden 5 октября 2026 г. с Codex 0.160: вызовы инструмента оболочки, правка файла, сессия закреплена за одной репликой. Рассуждения по умолчанию включены; model_reasoning_effort = "none" их выключает. Только локальные модели: правила маршрутизатора не применяются.
Чат для экспериментов
Пообщайтесь с загруженной моделью прямо в браузере, в том числе с отправкой изображений, прежде чем выдавать кому-то ключ.

Три урока, которые дались нам нелегко.

Движок падал четыре раза за день, а прокси продолжал отправлять ему запросы.

Ядро движка vLLM аварийно завершалось, а обертка vllm serve вокруг него продолжала работать, так что процесс выглядел живым, и запросы продолжали к нему уходить. Теперь сторожевой таймер опрашивает собственный эндпоинт /health движка, а не таблицу процессов. Когда движок перестает отвечать, таймер сохраняет диагностические данные, включая последние строки журнала, и перезагружает модель.

Панель журнала модели в реальном времени под нагрузкой: строки API-сервера vLLM, отвечающего на GET /metrics и POST /v1/chat/completions от клиента, строки движка с 10 выполняющимися и 0 ожидающими запросами и одна строка GET /health, все с ответом 200 OK Проверка сторожевого таймера и ответ движка
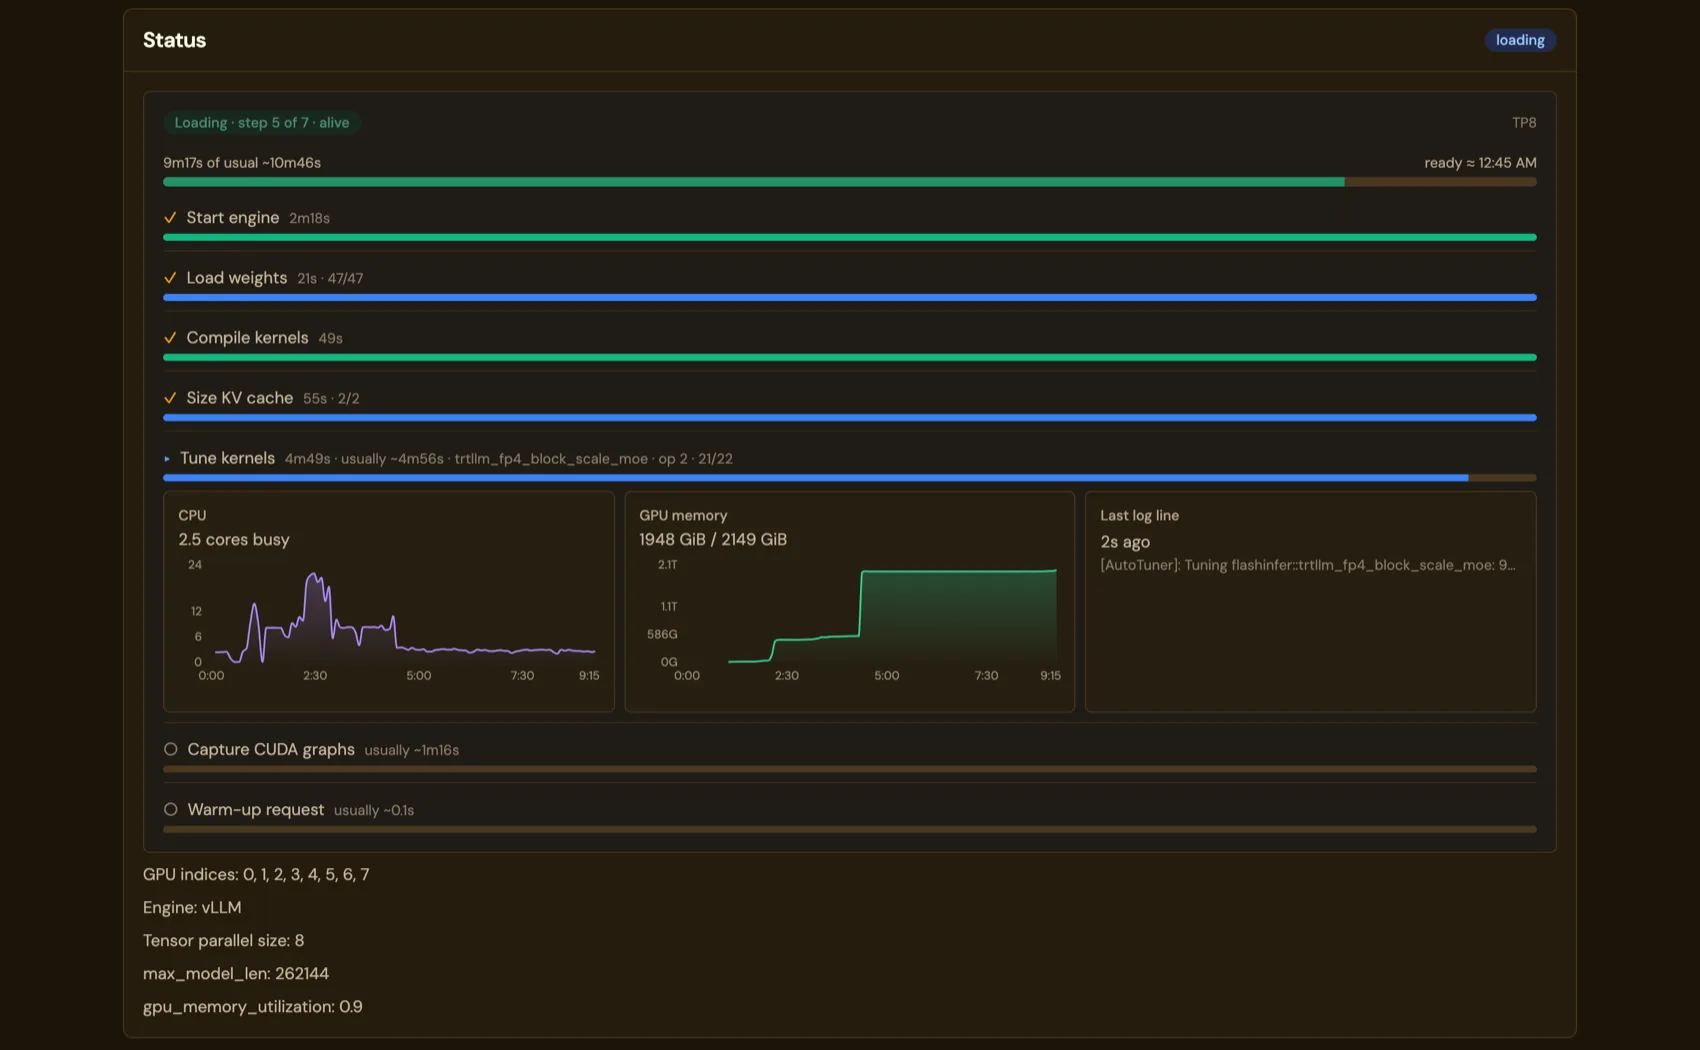
Рис. 15Журнал на странице модели в реальном времени под той же нагрузкой: опросы /metrics, входящие запросы chat completions, собственный подсчет движка — 10 запросов выполняются, ожидающих нет — и между ними одна проверка /health. Прокрутите изображение вбок, чтобы прочитать строки целиком.

12-минутная загрузка раньше заканчивалась ошибкой.

Большая модель может загружаться двенадцать минут и дольше. Раньше LM Warden ориентировался на фиксированный тайм-аут: по его истечении модель помечалась красной ошибкой «still loading», хотя движок продолжал загрузку. Теперь страница модели показывает каждый этап загрузки с индикатором выполнения, типичное время каждого этапа по предыдущим загрузкам и основные показатели CPU и памяти GPU. Зависшая загрузка прерывается, а ее GPU освобождаются; пока загрузка продвигается, ничего не подсвечивается красным. GLM-5.2 NVFP4 с тензорным параллелизмом 8 на восьми NVIDIA B300 загружается примерно за 11–12 минут; раньше такая долгая загрузка упиралась в тайм-аут 600 с.

Страница модели во время загрузки GLM-5.2 NVFP4 на восемь NVIDIA B300: прошло 9 мин 17 с из обычных 10 мин 46 с; Start engine, Load weights 47 из 47, Compile kernels и Size KV cache выполнены; Tune kernels: операция 2, 21 из 22; графики CPU и памяти GPU, занято 1 948 из 2 149 ГиБ; Capture CUDA graphs и Warm-up request еще впереди, для каждого указано обычное время
Рис. 16Загрузка GLM-5.2 NVFP4 с тензорным параллелизмом 8 на восемь B300, девятая минута. Настройка ядер — самый долгий этап; графики показывают, что движок работает, хотя журнал лишь повторяет ход настройки.

Карта на 16 ГиБ вмещает меньше, чем получается по расчету.

Веса модели 8B в bf16 сами по себе занимают около 15 ГиБ, и при загрузке ей не хватает памяти. Каждую строку ниже мы проверили на картах RTX A4000 и Quadro RTX 5000 по 16 ГиБ и оценивали результат по ответам модели в чате, а не по проверке работоспособности.

МодельЧто работаетЧто не работает
openai/gpt-oss-20bДве карты, тензорный параллелизм 2, max_model_len 32000, gpu_memory_utilization от 0,7 до 0,9Одна карта: MoE-модель на 20B не помещается
Llama 3.1 8B и модели уровня Mistral 7BОдна карта с чекпойнтом AWQ-INT4, --enforce-eager и gpu_memory_utilization 0,9Репозиторий bf16: около 15 ГиБ весов, при загрузке не хватает памяти
Две модели сразуПо одной модели на карту, каждая помещается в память своей картыДве модели на одной карте

Проверено на vLLM 0.20.0. Замеры реплик выше сделаны на 0.26.0. Этот выпуск поставляется с 0.32.0; на этой версии пока замерена только одна загрузка — GLM-5.2 NVFP4 с тензорным параллелизмом 8 на восьми B300, около 11–12 минут. Правила совместимости на 0.32 повторно не проверялись. Полная таблица и обоснования — в HAZARDS.md. У вас не NVIDIA? Для Apple silicon есть бета-версия для Mac, следующей будет Windows, а поддержка других GPU в планах.