LM Warden

छोटी-छोटी चीज़ें, जो इसे चलाने के बाद आपको दिखेंगी।

God mode
किसी कुंजी के पेज पर डॉक खोलकर उस कुंजी के प्रॉम्प्ट और जवाब लाइव देखें। सब कुछ सिर्फ़ मेमोरी में रहता है, स्ट्रीम सिर्फ़ तब होता है जब डॉक खुला हो, और यह तब तक बंद रहता है जब तक आप VW_GODMODE_ENABLED सेट न करें।
एडमिन टोकन
vwa_ टोकन से स्क्रिप्ट, CI और एजेंट एडमिन पासवर्ड, कुकी सँभालने या CSRF हेडर के बिना कंट्रोल API इस्तेमाल कर सकते हैं। टोकन सिर्फ़ एक बार दिखाया जाता है और SHA-256 हैश के रूप में सेव होता है।
एक HuggingFace कैश मैनेजर
डिस्क पर क्या है और कौन-सी फ़ाइल किस मॉडल की है। किसी मॉडल से न जुड़ी फ़ाइलें साफ़ करें, और पूरे कैश को tarball के रूप में एक्सपोर्ट या इंपोर्ट करें।
एक पोर्ट
UI, कंट्रोल API और /v1 तीनों एक ही :8080 पोर्ट पर हैं। आपका अपना TLS टर्मिनेटर, ingress या SSO बिना किसी बदलाव के इसके आगे लगाया जा सकता है।
बाहरी इंटरनेट कनेक्शन ज़रूरी नहीं
एयर-गैप्ड होस्ट तक सब कुछ पहुँचाने के लिए बस तीन इमेज tarball और एक वैकल्पिक मॉडल-कैश tarball चाहिए। HF_HUB_OFFLINE=1 मॉडल वेट के डाउनलोड भी रोक देता है।
Router के आँकड़े
हर फ़ैसला /router/stats पर: लोकल, पास-थ्रू, फ़ॉलबैक, अस्वीकार, कारण के साथ, हर नियम और हर लक्ष्य के हिसाब से, और ब्रेकर की स्थिति। हर प्रोसेस के लिए, कभी कोई हेडर या बॉडी नहीं।
हर क्लाइंट के लिए एक सेटअप पेज
Connect Claude Code, Codex CLI, OpenCode, Aider, Grok CLI, Anthropic और OpenAI SDK और तीन एडिटर के लिए सेटअप लिखता है, इस warden के पते, एक कुंजी और एक लोड किए गए मॉडल के साथ, और एक टेस्ट अनुरोध भेजता है।
Codex CLI
5 अक्टूबर 2026 को Codex 0.160 के साथ एक warden पर परखा गया: शेल टूल कॉल, एक फ़ाइल एडिट, और सेशन एक ही रेप्लिका पर रहा। थिंकिंग डिफ़ॉल्ट रूप से चालू है; model_reasoning_effort = "none" उसे बंद करता है। सिर्फ़ लोकल मॉडल: राउटर के नियम लागू नहीं होते।
एक चैट प्लेग्राउंड
किसी को कुंजी देने से पहले ब्राउज़र में लोड किए गए मॉडल से बात करें, इमेज समेत।

तीन बातें जो हमने मुश्किल से सीखीं।

इंजन एक दिन में चार बार बंद हुआ, और प्रॉक्सी उसे अनुरोध भेजती रही।

vLLM का इंजन कोर क्रैश हो गया, जबकि उसके ऊपर चलने वाला vllm serve रैपर चालू रहा, इसलिए प्रोसेस ज़िंदा दिखता रहा और अनुरोध उसे भेजे जाते रहे। अब एक वॉचडॉग प्रोसेस टेबल देखने के बजाय इंजन के अपने /health एंडपॉइंट से पूछता है। जब इंजन जवाब देना बंद कर देता है, तो वॉचडॉग सबूत सहेज लेता है, जिसमें लॉग का एक सीमित आख़िरी हिस्सा भी होता है, और मॉडल को दोबारा लोड करता है।

लोड के दौरान एक मॉडल का लाइव लॉग पैनल: vLLM API सर्वर की पंक्तियाँ जो GET /metrics और एक क्लाइंट के POST /v1/chat/completions का जवाब दे रही हैं, इंजन की पंक्तियाँ जो 10 अनुरोध चलते हुए और 0 प्रतीक्षा में बताती हैं, और एक GET /health पंक्ति, सभी 200 OK लौटा रही हैं वॉचडॉग की जाँच, जिसका जवाब इंजन देता है
चित्र 15उसी लोड के दौरान मॉडल के पेज पर लाइव लॉग: /metrics की स्क्रैपिंग, आते हुए चैट कंप्लीशन, इंजन की अपनी गिनती कि 10 अनुरोध चल रहे हैं और कोई प्रतीक्षा में नहीं, और उनके बीच एक /health जाँच। पूरी पंक्तियाँ पढ़ने के लिए इमेज को दाएँ-बाएँ स्क्रॉल करें।

12 मिनट का लोड पहले एक त्रुटि पर ख़त्म होता था।

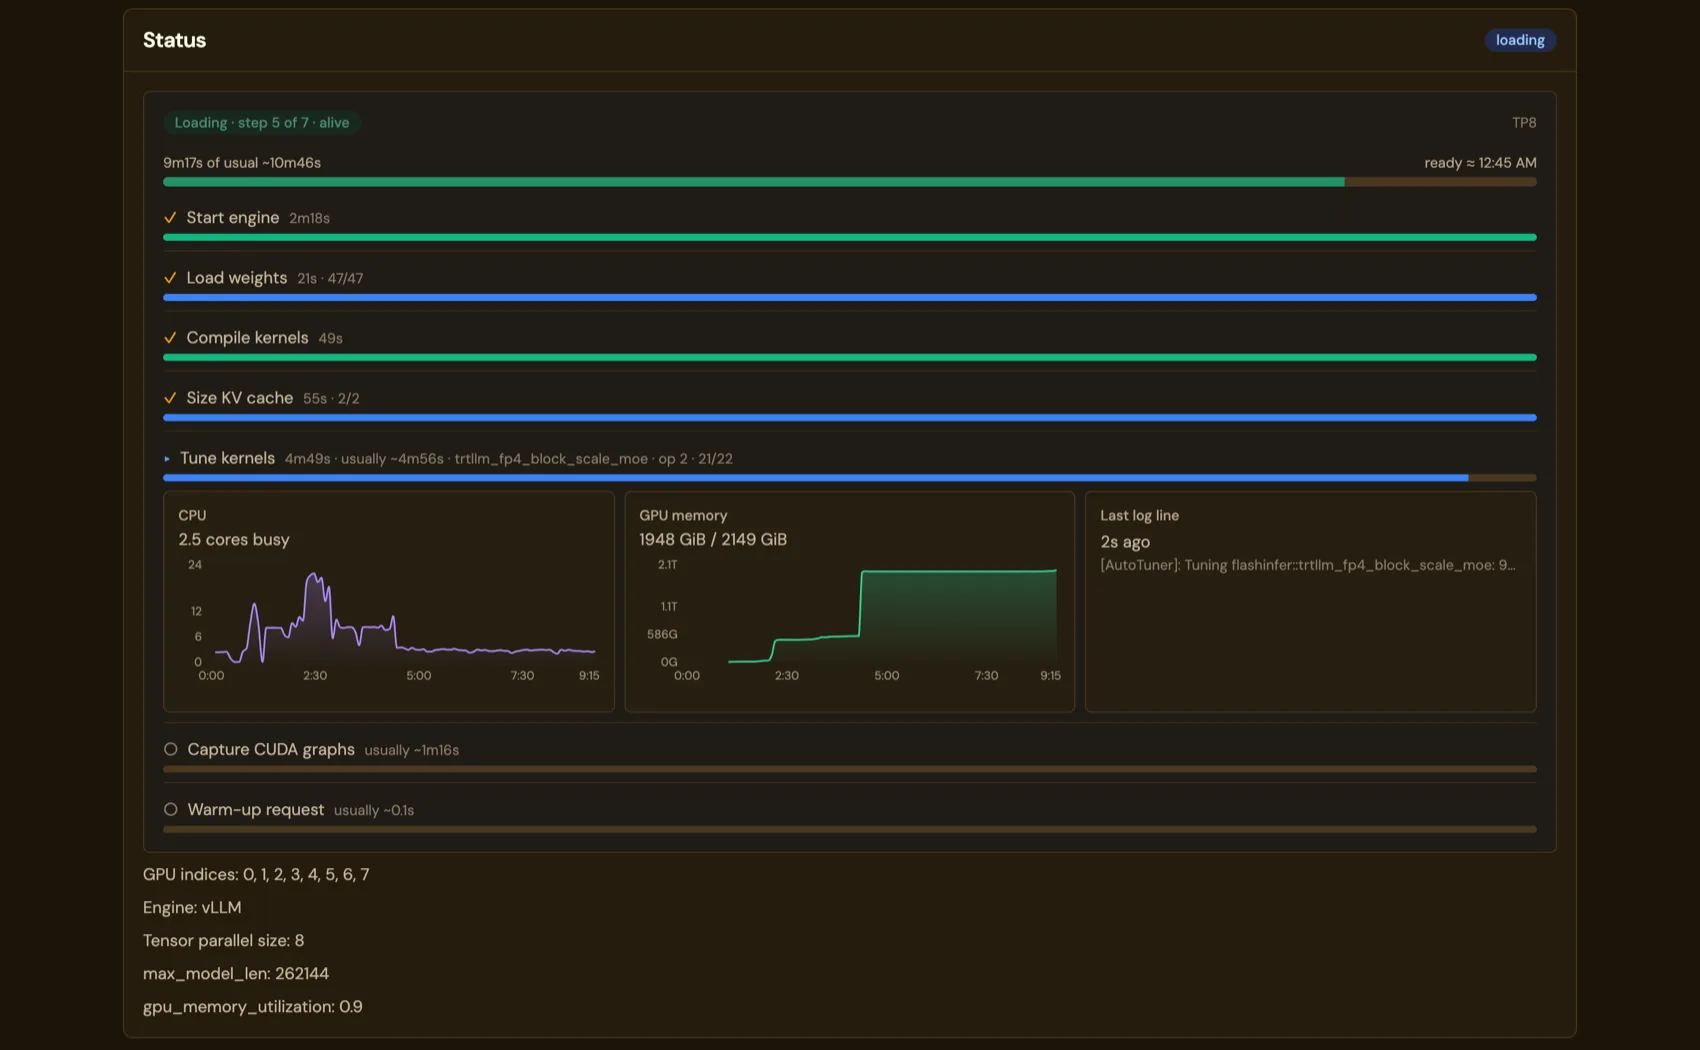
एक बड़े मॉडल को लोड होने में बारह मिनट या उससे ज़्यादा लग सकते हैं। अब तक warden सिर्फ़ तय समय-सीमा देखता था: समय-सीमा पर वह मॉडल में लाल रंग की “still loading” त्रुटि लिख देता था, जबकि इंजन लोड होता रहता था। अब मॉडल पेज हर लोड चरण को उसकी प्रोग्रेस बार, पिछले लोड से निकाले गए हर चरण के सामान्य समय, और CPU व GPU-मेमोरी के लाइव संकेतकों के साथ दिखाता है। अटका हुआ लोड रोक दिया जाता है और उसके GPU ख़ाली कर दिए जाते हैं; जब तक लोड आगे बढ़ रहा है, कुछ भी लाल नहीं होता। आठ NVIDIA B300 पर टेंसर-पैरेलल 8 के साथ GLM-5.2 NVFP4 लगभग 11 से 12 मिनट में लोड होता है; इतना लंबा लोड पहले 600 s के टाइमआउट से टकरा जाता था।

आठ NVIDIA B300 पर GLM-5.2 NVFP4 लोड होते समय मॉडल पेज: सामान्य 10 min 46 s में से 9 min 17 s बीते; Start engine, Load weights 47 of 47, Compile kernels और Size KV cache पूरे; Tune kernels op 2 पर, 22 में से 21; CPU और GPU-मेमोरी चार्ट जिनमें 2149 GiB में से 1948 इस्तेमाल में; Capture CUDA graphs और Warm-up request अभी बाकी, हर एक के साथ उसका सामान्य समय
चित्र 16आठ B300 पर टेंसर-पैरेलल 8 के साथ GLM-5.2 NVFP4 लोड हो रहा है, नौ मिनट बीते। कर्नेल ट्यूनिंग लंबा चरण है; चार्ट दिखाते हैं कि इंजन ज़िंदा है जबकि लॉग सिर्फ़ ट्यूनिंग की प्रगति दोहराता है।

16 GiB कार्ड में उतना नहीं समाता, जितना हिसाब से लगता है।

एक bf16 8B मॉडल के वेट ही लगभग 15 GiB के होते हैं, और लोड होते समय मेमोरी ख़त्म हो जाती है। हमने नीचे की हर पंक्ति 16 GiB वाले RTX A4000 और Quadro RTX 5000 कार्ड पर आज़माई, और नतीजा हेल्थ चेक के भरोसे नहीं, बल्कि चैट प्लेग्राउंड में मॉडल के जवाब पढ़कर तय किया।

मॉडलक्या काम करता हैक्या नहीं करता
openai/gpt-oss-20bदो कार्ड, टेंसर पैरेलल 2, max_model_len 32000, gpu_memory_utilization 0.7 से 0.9एक कार्ड: 20B MoE फ़िट नहीं होता
Llama 3.1 8B, Mistral 7B श्रेणीएक कार्ड, AWQ-INT4 चेकपॉइंट, --enforce-eager और gpu_memory_utilization 0.9 के साथbf16 रिपॉज़िटरी: लगभग 15 GiB वेट, लोड के दौरान मेमोरी ख़त्म
एक साथ दो मॉडलहर कार्ड पर एक मॉडल, हर एक अपने कार्ड में फ़िटएक कार्ड साझा करते दो मॉडल

vLLM 0.20.0 पर जाँचा गया। ऊपर के रेप्लिका माप में 0.26.0 इस्तेमाल हुआ था। यह रिलीज़ 0.32.0 के साथ आती है; उस पर पहला मापा गया लोड आठ B300 पर टेंसर-पैरेलल 8 के साथ GLM-5.2 NVFP4 है, लगभग 11 से 12 मिनट। फ़िट के नियम 0.32 पर दोबारा नहीं मापे गए हैं। पूरी तालिका और उसके पीछे के कारण HAZARDS.md में हैं। NVIDIA नहीं है? Apple silicon के लिए Mac बीटा है, अब Windows की बारी है, और दूसरे GPU रोडमैप पर हैं।