LM Warden

अपने GPU को होस्टेड API की तरह इस्तेमाल करें।

LM Warden आपके अपने हार्डवेयर पर vLLM, llama.cpp या MLX चलाता है और उन सबके लिए एक ही OpenAI-संगत पोर्ट देता है: हर ऐप के लिए अलग कुंजी, हर कुंजी का उपयोग, और हर GPU का लाइव पैनल। NVIDIA कार्ड वाली Linux मशीन पर, या Apple silicon वाले Mac पर।

ओपन सोर्स, Apache-2.0न अकाउंट, न टेलीमेट्रीLinux + NVIDIA · macOS (बीटा) · Windows तैयारी में

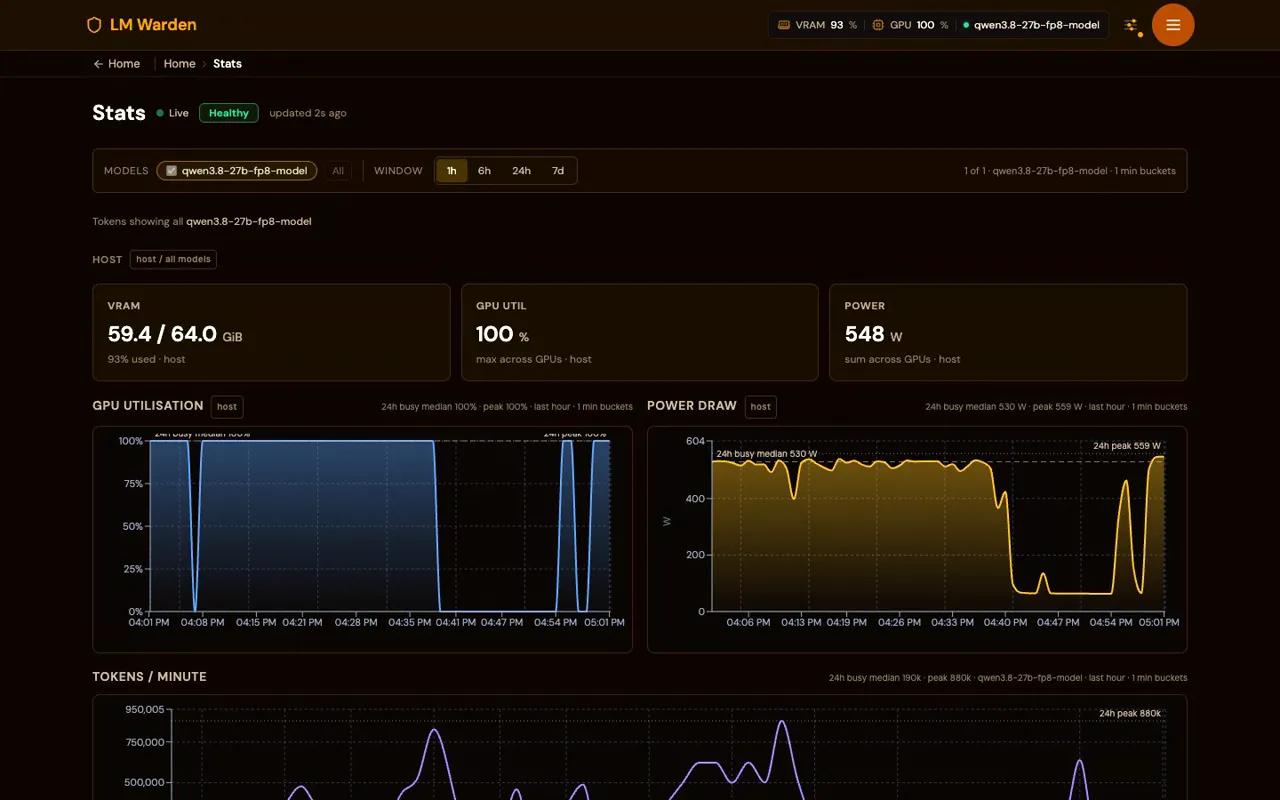
एक व्यस्त LM Warden इंस्टेंस का Stats पेज: VRAM 64 GiB में से 59.4, GPU उपयोग 100%, पावर 548 W, और पिछले एक घंटे के GPU उपयोग, पावर खपत और प्रति मिनट टोकन के चार्ट
  • Linux · NVIDIA vLLM v0.32.0 और llama.cpp b11719 CUDA पर
  • macOS · Apple silicon वाले Mac MLX और llama.cpp Metal पर
  • API OpenAI, Anthropic Messages और Responses एक ही पोर्ट पर
  • कोडिंग एजेंट Claude Code, Codex CLI, OpenCode और 7 अन्य आपके लिए कॉन्फ़िगर

लोग इसका उपयोग किसलिए करते हैं

आप इसे कहाँ चलाएँगे?

इसके चरण देखने के लिए ऊपर एक प्लेटफ़ॉर्म चुनें, या चारों दिखाएँ।

GPU होस्ट पर एक कमांड।

curl -fsSL https://raw.githubusercontent.com/Podwarden/lm-warden/main/install.sh | sh -s -- --dir /opt/vllm-warden
  • x86_64 होस्ट, Docker Compose v2.24+, NVIDIA Container Toolkit, और Turing या उससे नया कार्ड।
  • फिर http://HOST:8080/ui/ खोलें, पहली बार का सेटअप विज़र्ड पूरा करें, एक मॉडल जोड़ें, एक कुंजी बनाएँ। आपका एंडपॉइंट http://HOST:8080/v1 है।
  • एक मशीन में कई GPU: टेंसर पैरेलल, या हर कार्ड पर एक रेप्लिका के साथ कैश-अवेयर रूटिंग।
  • अभी सिर्फ़ NVIDIA। AMD ROCm और Intel GPU सपोर्ट जल्द आ रहा है; अभी कोई तारीख़ तय नहीं। हमें बताएँ कि आप इसे किस हार्डवेयर पर चलाना चाहेंगे: Radeon · Intel।
  • इंस्टॉल गाइड · ऑफ़लाइन / एयर-गैप्ड · सोर्स से · अपग्रेड करना
Models पेज पर एक मॉडल लोड हो रहा है, हर चरण के साथ उसका बीता हुआ और सामान्य समय
इंस्टॉल के बाद लोड होता एक मॉडल: हर चरण के साथ पिछले लोड से निकला सामान्य समय।

एक मेनू-बार ऐप, बीटा में।

Mac के लिए डाउनलोड करें (बीटा)

  • लगभग 110 MB। Apple silicon (M1 या नया), macOS 14 या नया। SHA-256 · रिलीज़ नोट्स।
  • इंजन: MLX और Metal के साथ बना llama.cpp। वही डैशबोर्ड और वही OpenAI API; vLLM नहीं, पावर रीडिंग नहीं।
  • बीटा के बारे में सीधी बात: यह ऐड-हॉक साइन किया गया है और नोटराइज़ नहीं है, इसलिए पहली बार खोलने पर macOS आपसे Privacy & Security में इसे अनुमति देने को कहेगा; अपडेट के लिए नया वर्शन डाउनलोड करना होता है। पहली बार खोलने के चरण।
  • जब तक आप Share on Local Network नहीं चुनते, यह सिर्फ़ 127.0.0.1 पर उपलब्ध रहता है।
  • जल्द आ रहा है: mlx-rust-lm, एक तीसरा इंजन। LM Warden टीम Apple के mlx-lm को Apple की आधिकारिक mlx-c बाइंडिंग पर Python से Rust में पोर्ट कर रही है; यह MLX और llama.cpp के साथ चलेगा और समय के साथ Python वाले mlx-lm इंजन की जगह लेगा, जो Python और उसकी लाइब्रेरी के साथ आज के डाउनलोड का ज़्यादातर हिस्सा है। अनौपचारिक, Apple से संबद्ध नहीं।
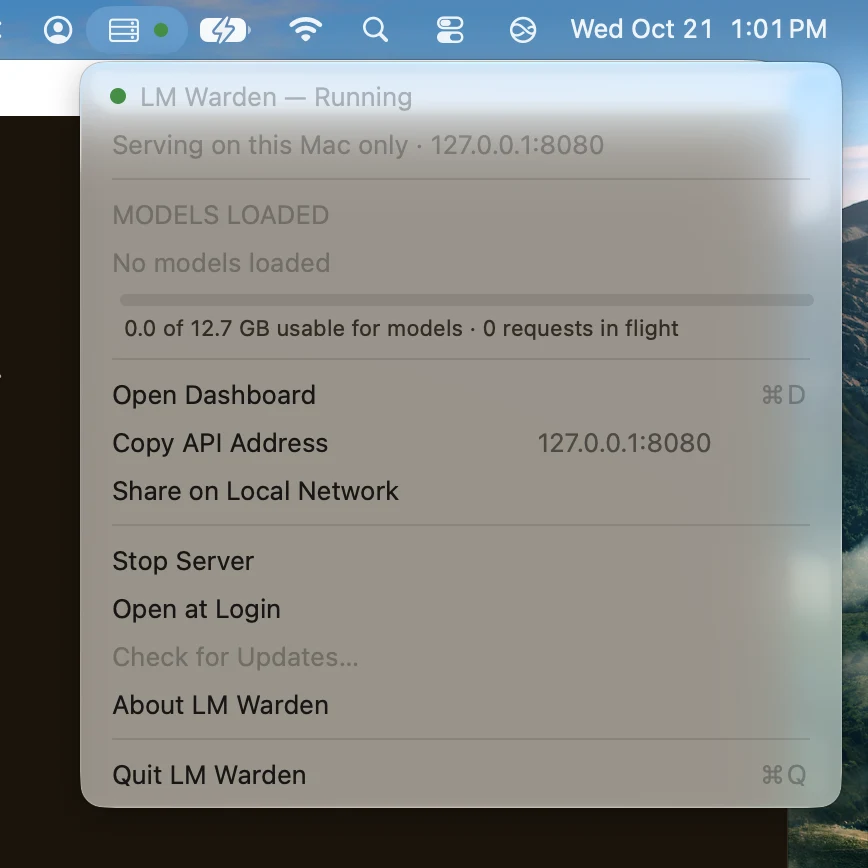
Mac पर LM Warden का मेनू-बार मेनू: Running, सिर्फ़ इसी Mac पर 127.0.0.1:8080 पर उपलब्ध, कोई मॉडल लोड नहीं, मेमोरी बार, Open Dashboard, Copy API Address, Share on Local Network
16 GB M1 पर बीटा का मेनू-बार मेनू।

अब Windows की बारी है। अभी कोई तारीख़ नहीं।

हम इस पर अभी काम कर रहे हैं, और जिस दिन बिल्ड तैयार होगा उसी दिन उसे यहाँ रख देंगे; उससे पहले कोई साइन-अप फ़ॉर्म नहीं होगा। तब तक आपके पास दो व्यावहारिक रास्ते हैं:

  • LM Warden को Linux GPU मशीन पर चलाएँ और Windows से उसका उपयोग करें: हर OpenAI क्लाइंट, Claude Code और Codex नेटवर्क पर कनेक्ट होते हैं।
  • पहले Windows बिल्ड की ख़बर पाने के लिए GitHub पर रिलीज़ फ़ॉलो करें।
  • AMD Radeon और Intel GPU इसके बाद आएँगे; हमें बताएँ कि आप इसे किस हार्डवेयर पर चलाना चाहेंगे: Radeon · Intel।

अप्लायंस: जल्द आ रहा है, कोई तारीख़ नहीं।

LM Warden चलाने का चौथा तरीका, ऐसी मशीन के लिए जिसका कोई और काम न हो।

  • आप GPU वाले चेसिस में एक USB ड्राइव लगाते हैं। उससे एक हल्का, न्यूनतम Linux इंस्टॉल होता है, जो सिर्फ़ एक काम करता है: LM Warden चलाना।
  • यह आपके लिए नेटवर्क और मॉडल के स्टोरेज को कॉन्फ़िगर करता है।
  • अपडेट ओवर-द-एयर आते हैं, या मशीन पूरी तरह एयर-गैप्ड काम करती है।
  • एक सुरक्षित, समर्पित LLM सर्वर के लिए बना: ऐसी टीम के लिए जिसे पूरी तरह लॉक-डाउन मशीन चाहिए, या ऐसी जगह के लिए जहाँ बाहरी इंटरनेट कनेक्शन ही नहीं है।

इसके आने तक, ऊपर दिया गया Linux इंस्टॉल आपके अपने सेट किए हुए होस्ट पर यही काम करता है, ऑफ़लाइन / एयर-गैप्ड इंस्टॉल समेत। GitHub पर रिलीज़ फ़ॉलो करें।

अभी कोई तस्वीर नहीं: दिखाने के लिए न कोई प्रोडक्ट नाम है न हार्डवेयर, और हम कोई काल्पनिक चित्र नहीं बनाएँगे।

पहले से चला रहे हैं? Linux पर अपग्रेड मौजूदा इंस्टॉल में ही हो जाता है: नई इमेज पुल करें, रीस्टार्ट करें, डेटाबेस अपने-आप नए वर्शन पर माइग्रेट हो जाता है। चरण · चेंजलॉग।

सेल्फ़-होस्टिंग की आठ समस्याएँ हैं। यहाँ देखें कि हर एक का हल कैसा दिखता है।

अकेला इंजन एक पोर्ट पर एक मॉडल चलाता है। बाकी जो कुछ चाहिए, वह नीचे है, और जहाँ हमारे पास अपने आँकड़े हैं, वे भी दिए हैं।

  1. क्या यह मॉडल मेरे GPU में आएगा?

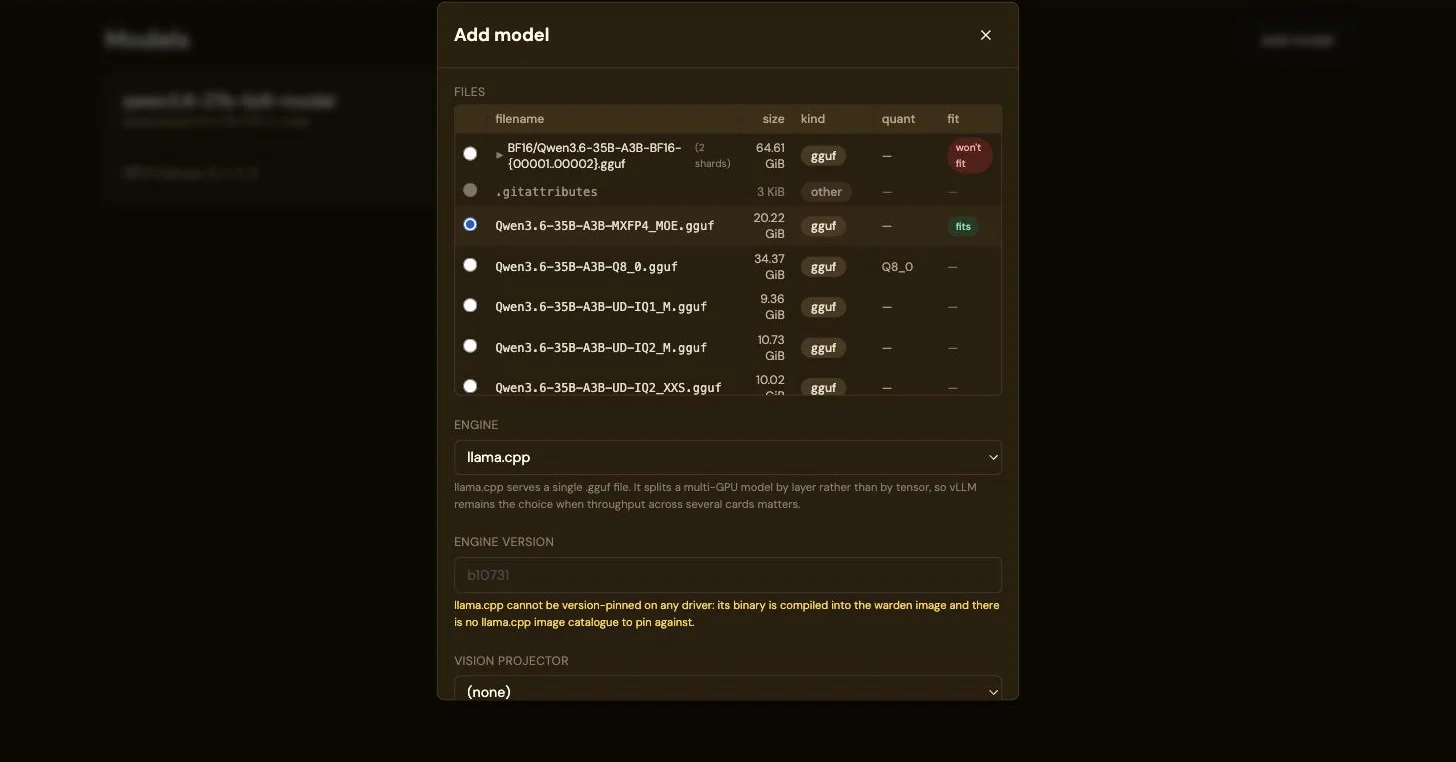
    Hugging Face रिपॉज़िटरी को Add model में पेस्ट करें। हर फ़ाइल के साथ आपके चुने हुए कार्ड के हिसाब से नतीजा दिखता है: फ़िट होती है, गुंजाइश कम है, या फ़िट नहीं होगी। ज़्यादा कार्ड चुनें तो उपलब्ध मेमोरी जुड़ती जाती है। जब तक कुछ फ़िट न हो, कुछ भी डाउनलोड नहीं होता।

    वही 20.22 GiB फ़ाइल, चार GPU चुनने पर फ़िट के रूप में चिह्नित
  2. आपने GPU ख़रीदे हैं। वे काम कर रहे हैं या खाली बैठे हैं?

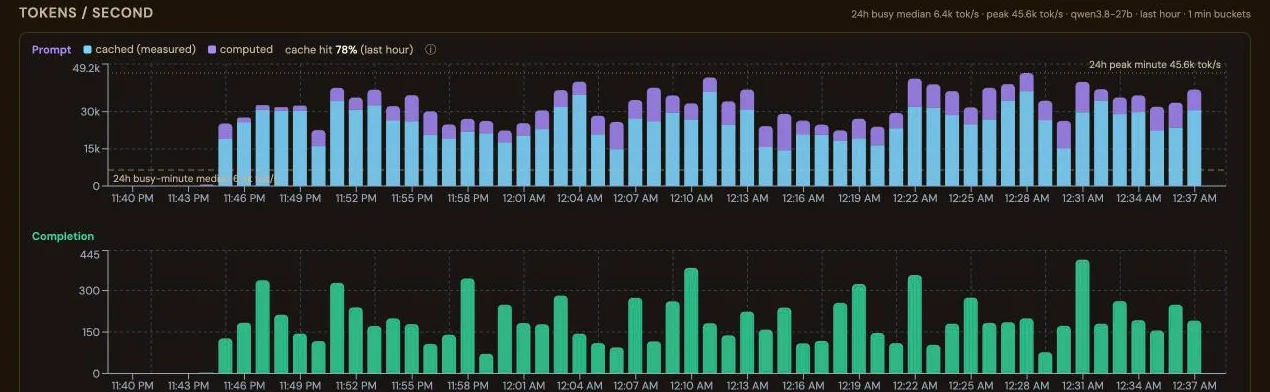
    थ्रूपुट = कॉन्करेंसी × प्रॉम्प्ट की लंबाई × कैश का दोबारा उपयोग, और अकेला इंजन इनमें से कुछ भी एक साथ नहीं दिखाता। Stats पेज 1 h से 7 d तक यह सब दिखाता है: VRAM, GPU उपयोग, पावर (Linux), प्रति सेकंड टोकन (प्रॉम्प्ट टोकन कैश से मिले और गणना किए गए हिस्सों में बँटे हुए), p50/p95 लेटेंसी, प्रॉम्प्ट-कैश हिट दर, प्रीएम्प्शन, और प्रति कुंजी व प्रति क्लाइंट IP अनुरोध। अगर क़तार लगी है पर GPU उपयोग बढ़ नहीं रहा, तो संकेत है “कॉन्करेंसी बढ़ाएँ”; अगर कैश से मिलने वाला हिस्सा कम है, तो “सेशन पिन करें”।
    प्रति सेकंड टोकन: प्रॉम्प्ट टोकन कैश से मिले और गणना किए गए हिस्सों में बँटे हुए, नीचे कंप्लीशन टोकन
  3. कुछ भी जोड़ने से पहले मॉडल से बात करें।

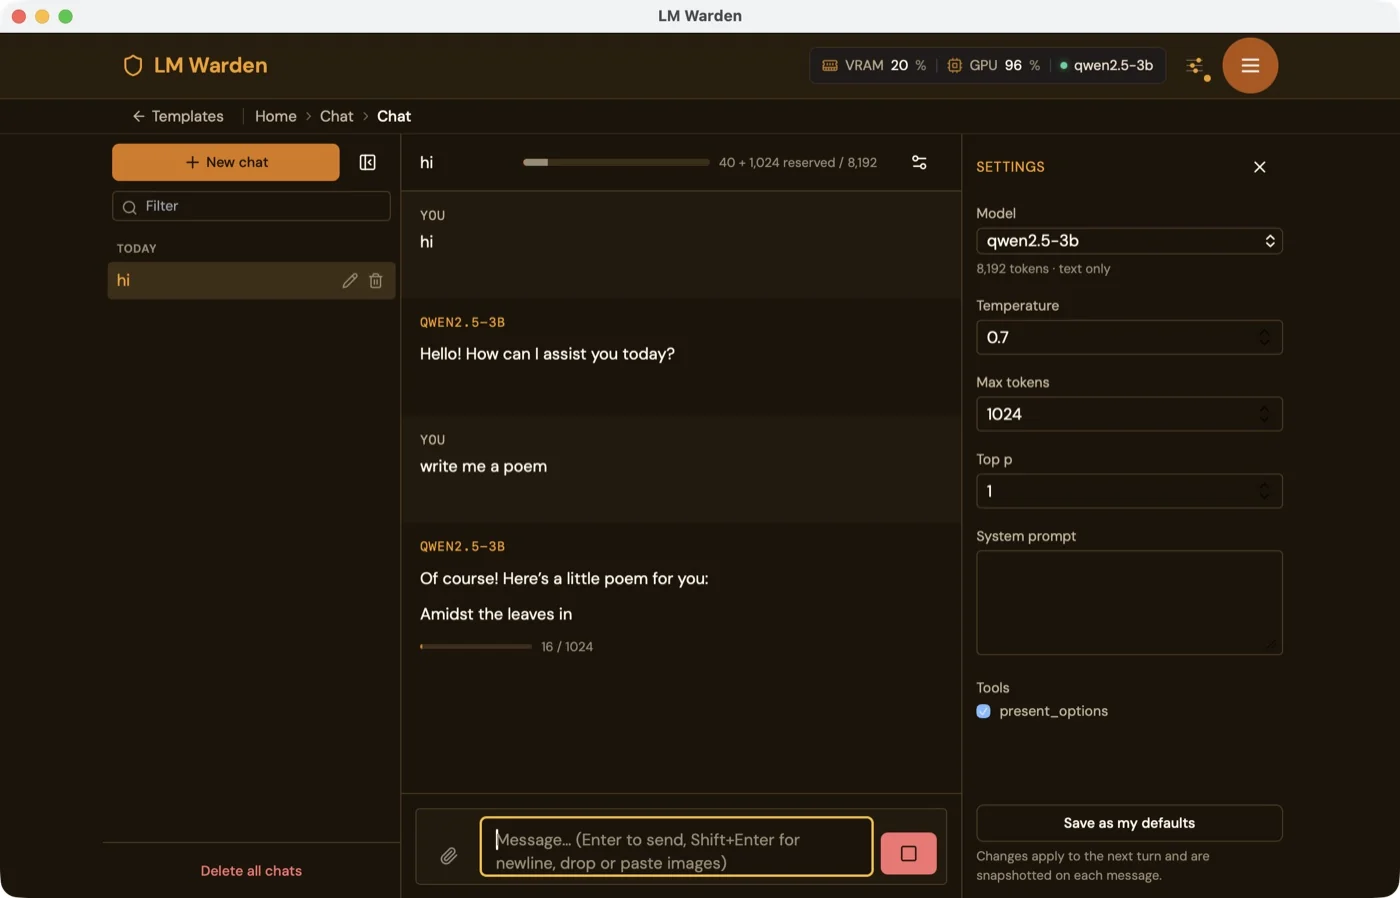
    चैट उसी विंडो में है जिसमें बाकी सब कुछ। हाइलाइट किए गए कोड और गणित के साथ स्ट्रीमिंग Markdown; विज़न मॉडल के लिए हर संदेश में आठ तक PNG, JPEG या WebP इमेज; हर चैट के लिए temperature, top-p, max tokens और सिस्टम प्रॉम्प्ट, जो डिफ़ॉल्ट के रूप में सहेजे जाते हैं; चैट सहेजी जाती हैं, उन्हें अपने-आप शीर्षक मिलता है और उन्हें फ़ोर्क किया जा सकता है। मॉडल जो टूल कॉल करता है, वे भी दिखाई जाती हैं, ताकि किसी एजेंट को उस पर निर्भर बनाने से पहले आप टूल कॉलिंग जाँच सकें।

    Mac ऐप की डैशबोर्ड विंडो में चैट, qwen2.5-3b से स्ट्रीम हो रही है, हेडर में GPU 96%
  4. मॉडल ने असल में क्या देखा, और क्या कहा?

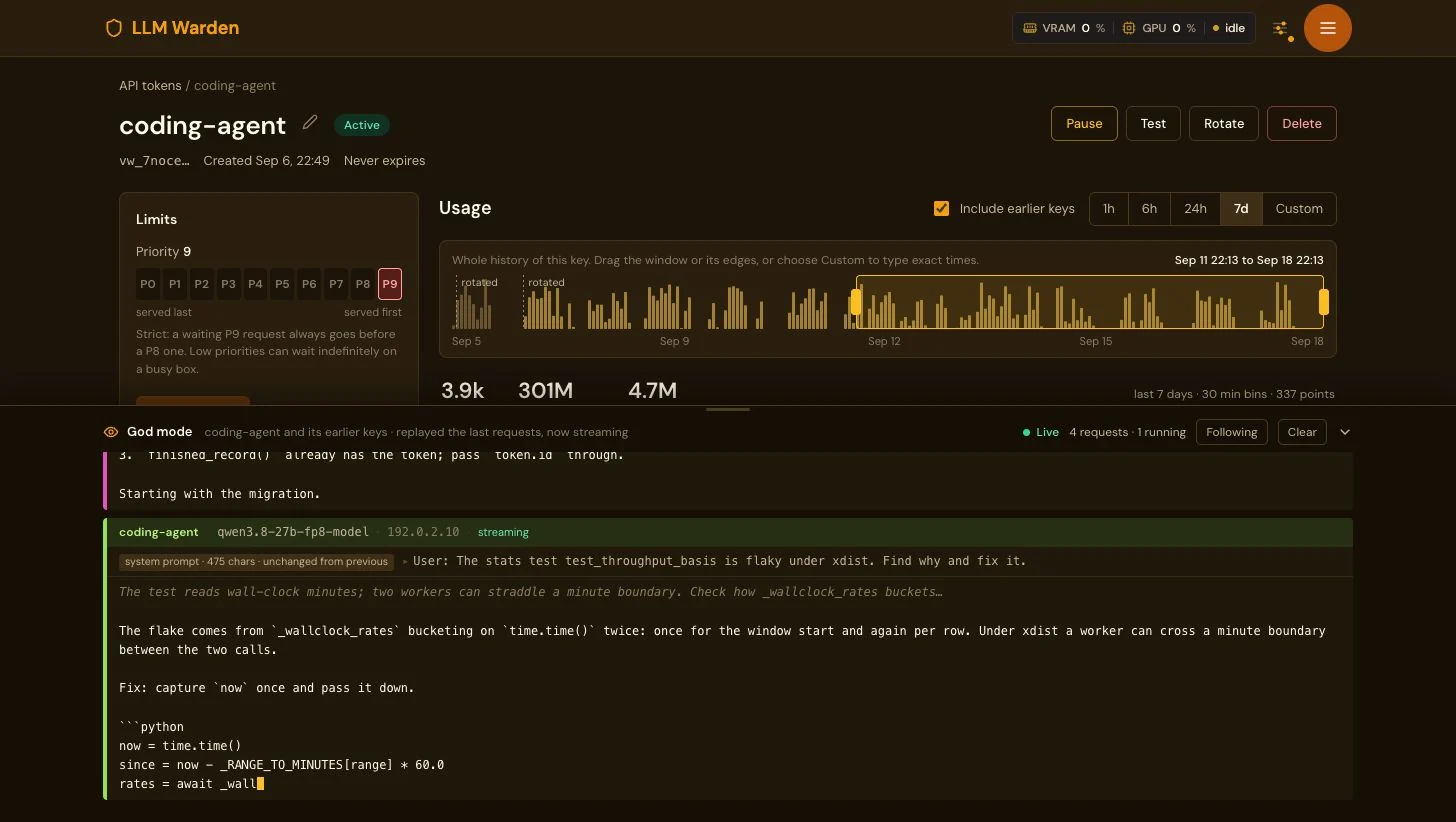
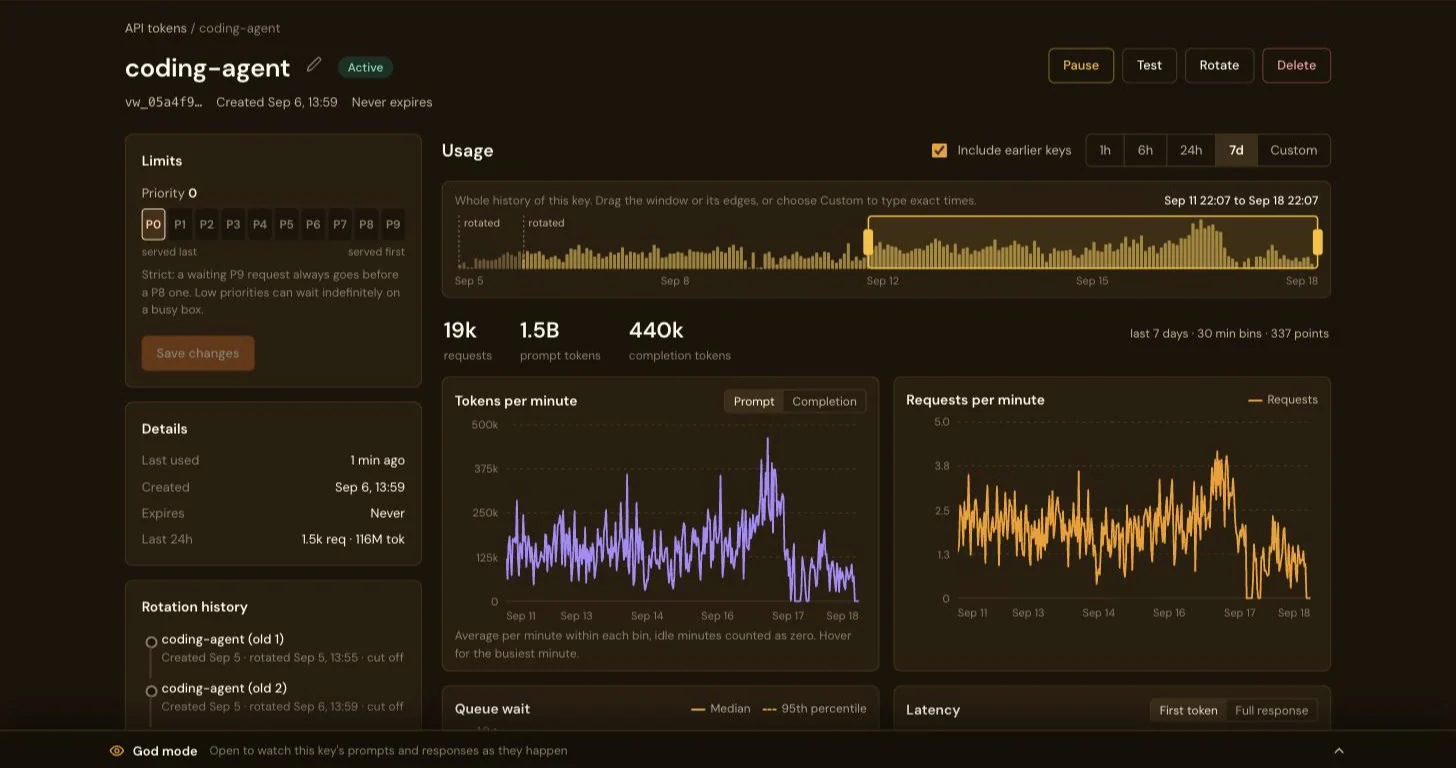
    God mode, प्रॉम्प्ट डीबग करने के लिए: डिप्लॉयमेंट पर VW_GODMODE_ENABLED चालू होने पर हर कुंजी के पेज पर एक डॉक दिखता है, जो उस कुंजी के प्रॉम्प्ट और कंप्लीशन लाइव स्ट्रीम करता है। डिफ़ॉल्ट रूप से बंद, और बंद होने पर यह डॉक दिखता ही नहीं। डेटा सिर्फ़ मेमोरी के एक सीमित रिंग बफ़र में रहता है: डेटाबेस या डिस्क पर कुछ नहीं जाता, रीस्टार्ट पर सब मिट जाता है। एडमिन सेशन वाला कोई भी इसे खोल सकता है; warden में सिर्फ़ एक एडमिन भूमिका है, कोई और नहीं।

    API कुंजी coding-agent का पेज, नीचे God mode डॉक खुला है: Live, 4 अनुरोध, 1 चल रहा है; 192.0.2.10 से एक qwen3.8-27b-fp8 अनुरोध स्ट्रीम हो रहा है, जिसमें एक अस्थिर stats टेस्ट के बारे में यूज़र का प्रॉम्प्ट और लिखे जाते समय Python फ़िक्स वाला मॉडल का जवाब दिख रहा है

एजेंट का हर टर्न पूरी बातचीत दोबारा पढ़ता है।

एजेंट हर टर्न में अपनी पूरी हिस्ट्री दोबारा भेजता है, इसलिए लंबी बातचीत का ज़्यादातर हिस्सा ऐसा प्रीफ़िक्स होता है जिसे इंजन पहले ही पढ़ चुका है। vLLM यह काम अपने प्रीफ़िक्स कैश में रखता है, लेकिन सिर्फ़ उसी रेप्लिका पर जिसने इसे किया था, और उसका अपना बैलेंसर हर टर्न को उस रेप्लिका पर भेज देता है जिसकी क़तार उस समय सबसे छोटी हो। LM Warden हर नई बातचीत को सबसे कम लोड वाली रेप्लिका पर रखता है और उसे वहीं बनाए रखता है; इसके लिए वह सेशन ID इस्तेमाल करता है जो Claude Code पहले से भेजता है। कोई अनुरोध दूसरी रेप्लिका पर तभी जाता है जब मौजूदा रेप्लिका अपनी स्पिल सीमा पार कर ले।

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
चार रेप्लिका वाले मॉडल पर एक बातचीत के चार टर्न। vLLM का बैलेंसर हर टर्न को किसी भी रेप्लिका पर भेज देता है, और वह रेप्लिका उसे लगभग शुरू से प्रीफ़िल करती है (प्रीफ़िल यानी इंजन पूरा प्रॉम्प्ट पढ़कर उसे कैश में भरता है)। LM Warden के साथ बातचीत रेप्लिका 2 पर ही रहती है और सिर्फ़ नए टर्न का प्रीफ़िल होता है। यह तंत्र का चित्र है, माप नहीं।

हमारी चार-कार्ड मशीन पर मापा गया (4 × RTX A4000, Qwen3-4B चार एक-कार्ड रेप्लिका के रूप में, Claude Code जैसे सिंथेटिक सेशन, एफ़िनिटी पहले बंद फिर चालू, एक के ठीक बाद एक): बातचीत पिन करने पर 4 समवर्ती सेशन पर कैश से मिले प्रॉम्प्ट टोकन का हिस्सा 56 से बढ़कर 86% हो गया, और पहले बाइट तक का मीडियन समय 2.05 से घटकर 0.38 s हो गया। हमने जितने भी चरण चलाए, सबमें प्रति मिनट आउटपुट टोकन ज़्यादा थे और p95 पहले बाइट तक का समय (सबसे धीमे 5%) कम था। काम कर रही रेप्लिका की संख्या लगभग नहीं बदली (4 सेशन पर चार में से 2.71 बनाम 2.83): फ़ायदा कैश के दोबारा उपयोग से है, ज़्यादा कार्ड काम करने से नहीं।

Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
हर चरण में प्रीफ़िक्स-कैश हिट दर: कैश से दिए गए प्रॉम्प्ट टोकन को माँगे गए कुल प्रॉम्प्ट टोकन से भाग देकर, चारों रेप्लिका को मिलाकर, चरण के दौरान vLLM के अपने काउंटर में आए बदलाव से निकाली गई। यह फ़ायदा तब तक रहता है जब तक गुंजाइश है, और 32 सेशन पर ख़त्म हो जाता है, जहाँ बातचीत दूसरी रेप्लिका पर स्पिल होने लगती है।
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
4 से 32 समवर्ती सेशन पर पहले बाइट तक का समय, मीडियन और p95, लॉग स्केल पर, ताकि एक सेकंड से कम वाले चरण और मिनट भर वाले चरण साथ-साथ पढ़े जा सकें। एफ़िनिटी के साथ मीडियन 16 सेशन तक काफ़ी कम है (4 पर 0.38 बनाम 2.05 s) और 24 व 32 पर ज़्यादा; p95 हर चरण में कम है, हालाँकि 16 पर अंतर (24.9 बनाम 26.2 s) इतना छोटा है कि हर स्थिति के सिर्फ़ एक रन में यह संयोग भी हो सकता है। क्लाइंट की ओर से, इंटरनेट पर, पहले स्ट्रीम हुए टोकन तक मापा गया।

लोड के हर स्तर पर, एफ़िनिटी बंद → चालू

SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

हमारी चार-कार्ड मशीन पर एक छोटे मॉडल के साथ मापा गया: पहले एफ़िनिटी बंद, फिर चालू, बीच में vLLM रीस्टार्ट किए बिना। इसलिए दूसरा रन पहले से भरे प्रीफ़िक्स कैश के साथ शुरू हुआ, और दोनों रन के प्रॉम्प्ट एक ही सीड से बने। हर चरण 3 मिनट चलता है, इसलिए उसमें सिर्फ़ 9 से 31 सेशन पूरे होते हैं और एक सेशन कम-ज़्यादा होने से प्रति घंटा सेशन का आँकड़ा 20 तक बदल जाता है; प्रति मिनट आउटपुट टोकन ज़्यादा भरोसेमंद कॉलम है। आपका मॉडल, कार्ड और वर्कलोड अलग होंगे; मॉडल के पेज पर रेप्लिका कार्ड आपकी मशीन के लिए यही काउंटर दिखाता है।

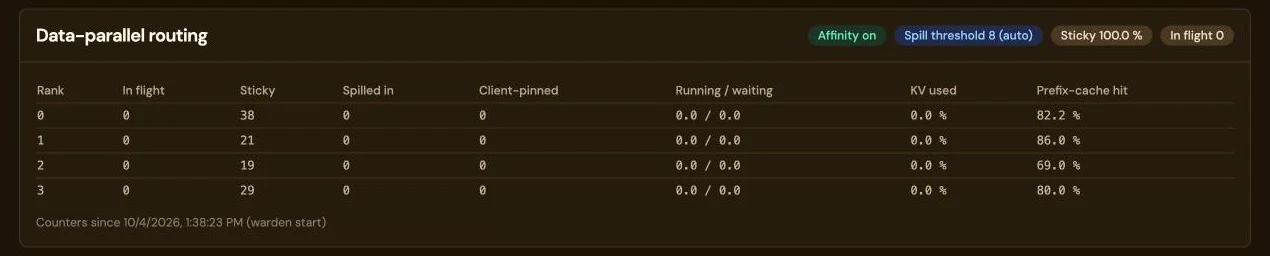
मॉडल के पेज पर Data-parallel routing कार्ड, जिसके ऊपर Affinity on, Spill threshold 8 (auto), Sticky 100.0% और In flight 0 लेबल हैं। एक तालिका में रेप्लिका 0 से 3 के लिए इन-फ़्लाइट, स्टिकी (38, 21, 19 और 29), स्पिल होकर आए, क्लाइंट-पिन किए, चल रहे और प्रतीक्षारत अनुरोध, इस्तेमाल हुआ KV और प्रीफ़िक्स-कैश हिट दर (82.2, 86.0, 69.0 और 80.0 प्रतिशत) हैं, और एक पंक्ति बताती है कि काउंटर warden के शुरू होने से गिन रहे हैं।
मॉडल के पेज पर वही काउंटर: हर रेप्लिका की एक पंक्ति, जिसमें उसके पास मौजूद अनुरोध, कितनी बातचीत वहीं टिकी रहीं (sticky) या स्पिल होकर आईं, क्या चल रहा है और क्या प्रतीक्षा में है, इस्तेमाल में KV कैश और प्रीफ़िक्स-कैश हिट दर। 4 अक्टूबर 2026 को एफ़िनिटी चालू और स्पिल सीमा 8 (auto) के साथ रिकॉर्ड किया गया: sticky 100%, और रेप्लिका 0 से 3 पर प्रीफ़िक्स-कैश हिट दर 82.2, 86.0, 69.0 और 80.0%। यह कंसोल के कार्ड का स्क्रीनशॉट है, बेंचमार्क का नतीजा नहीं। कार्ड बड़ा करने के लिए उस पर टैप करें।

यह कहाँ पीछे रह जाता है। 24 और 32 सेशन वाले चरणों में चार छोटे कार्ड पर जान-बूझकर ज़रूरत से ज़्यादा लोड डाला गया है, और हर रेप्लिका पूरी तरह भरी है। आउटपुट फिर भी ज़्यादा है (प्रति मिनट 11,178 बनाम 9,048 और 16,638 बनाम 14,760 टोकन) और सबसे धीमे अनुरोधों का इंतज़ार काफ़ी कम है (p95 38 बनाम 59 s, और 39 बनाम 83 s), लेकिन एफ़िनिटी के साथ पहले बाइट तक का मीडियन समय ख़राब है: 24 सेशन पर 13.1 बनाम 5.1 s, 32 पर 27.7 बनाम 12.3 s। इसकी वजह हमने अभी अलग से पता नहीं की है, और स्पिल सीमा 8 से घटाकर 4 करने से भी यह नहीं बदला।

व्यस्त मशीन पर दोनों सेटिंग मापें। फ़ायदा तब सबसे ज़्यादा होता है जब गुंजाइश हो; जो मशीन अपनी सीमा पर चलती है, उस पर दोनों सेटिंग माप लेनी चाहिए, और एफ़िनिटी हर मॉडल के लिए अलग से बंद की जा सकती है। रेप्लिका, और इसलिए यह रूटिंग भी, NVIDIA GPU वाले Linux इंस्टॉल में ही है; Mac ऐप (बीटा) में टेंसर पैरेलल या डेटा पैरेलल नहीं है।

पूरा तरीका: वर्कलोड, टेस्ट टूल, स्पिल सीमा, और सात GPU वाली वह मशीन जो तब से इसी के साथ चल रही है →

अपने कोडिंग एजेंट को अपने ही GPU पर चलाएँ।

दस कोडिंग टूल सिर्फ़ एक Base URL और एक कुंजी से जुड़ जाते हैं; इनमें से दो कठिन कामों के लिए आपकी पेड Claude सदस्यता भी साथ रख सकते हैं।

अपनी Claude सदस्यता रखें, रोज़मर्रा की कॉल अपने GPU पर भेजें

Claude Code और Anthropic SDK, राउटर के ज़रिए। एक नियम तय करता है कि किन Claude मॉडल के अनुरोधों का जवाब आपके GPU देंगे; बाकी सब आपके अपने लॉगिन या कुंजी से Anthropic को जाता है।

Claude Code का अनुरोध कहाँ जाता है एजेंट हर अनुरोध LM Warden के राउटर को भेजता है। claude-haiku मॉडल के अनुरोध आपके GPU पर चल रहे मॉडल को जाते हैं, और जवाब उसी claude-haiku नाम से लौटता है। बाकी हर मॉडल, Opus समेत, आपके अपने लॉगिन से Anthropic को भेजा जाता है। Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* your GPUanswers as that model everything else,Opus included Anthropicon your own login Claude Code का अनुरोध कहाँ जाता है एजेंट हर अनुरोध LM Warden के राउटर को भेजता है। claude-haiku मॉडल के अनुरोध आपके GPU पर चल रहे मॉडल को जाते हैं, और जवाब उसी claude-haiku नाम से लौटता है। बाकी हर मॉडल, Opus समेत, आपके अपने लॉगिन से Anthropic को भेजा जाता है। Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* everythingelse, Opusincluded your GPUanswers as that model Anthropicon your own login
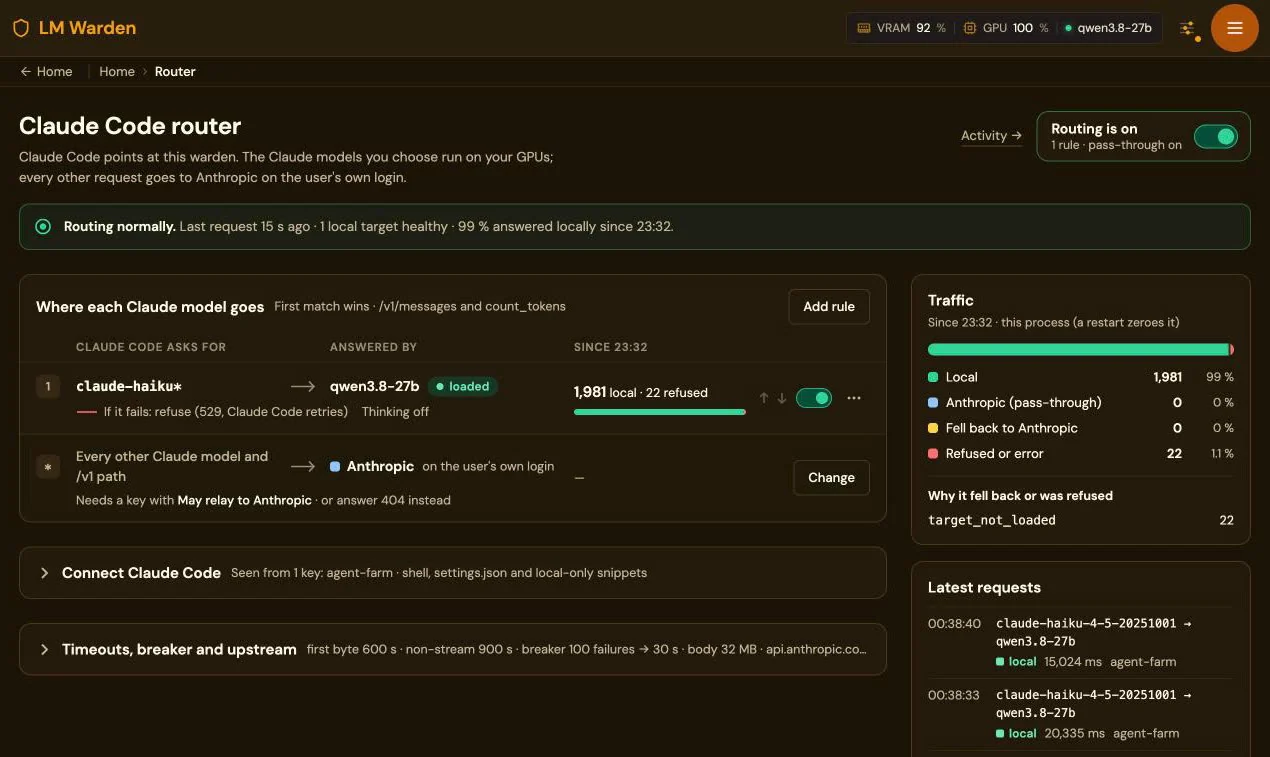
1,981 अनुरोधलोकल रूप से निपटाए गए, यानी रीस्टार्ट के बाद से इस मशीन के Claude Code ट्रैफ़िक का 99%। हमारी अपनी सात-GPU मशीन के Router पेज से, 21 अक्टूबर 2026; 22 अनुरोध इसलिए अस्वीकार हुए कि लक्ष्य मॉडल उस समय लोड नहीं था।
Claude Code राउटर पेज: रूटिंग चालू है, 23:32 से 99% लोकल रूप से जवाब दिए गए; नियम 1 claude-haiku* को qwen3.8-27b पर भेजता है, 1,981 लोकल और 22 अस्वीकार; बाकी हर Claude मॉडल यूज़र के अपने लॉगिन से Anthropic को जाता है
Claude Code 2.1.227 या नया: ANTHROPIC_BASE_URL में warden का पता, ANTHROPIC_CUSTOM_HEADERS में warden की कुंजी, और आपका लॉगिन बिना बदले। हमने जवाबों की गुणवत्ता का बेंचमार्क नहीं किया है: लोकल मॉडल को रोज़मर्रा के, साफ़-साफ़ बताए गए काम दें।

Connect हर क्लाइंट का कॉन्फ़िग लिखता है और एक टेस्ट अनुरोध भेजता है।

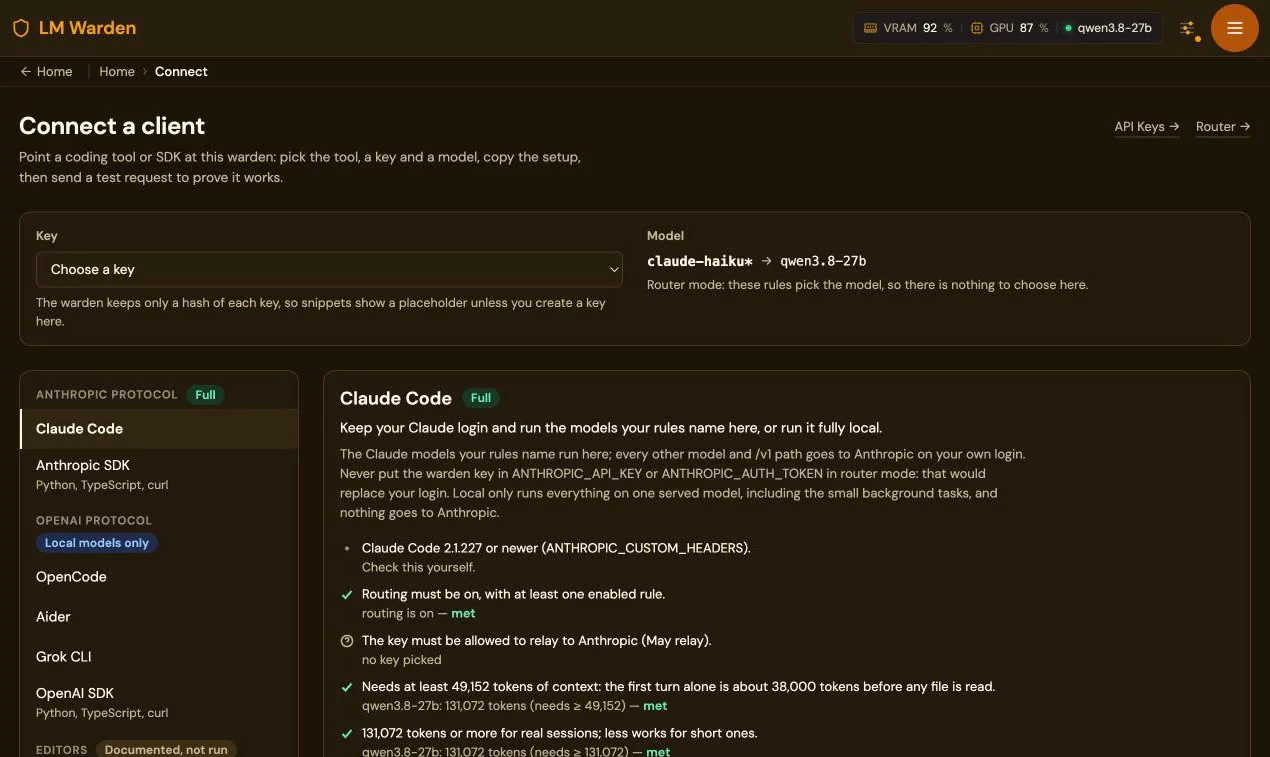
कंसोल में क्लाइंट, एक कुंजी और एक लोड किया हुआ मॉडल चुनें; यह हर ज़रूरत को असल में लोड किए गए मॉडल से मिलाकर जाँचता है (कॉन्टेक्स्ट विंडो, टूल कॉलिंग, राउटर चालू) और पेस्ट करने के लिए फ़ाइलें देता है। सभी कोडिंग एजेंट, हर क्लाइंट का अलग पेज, जिसमें लिखा है कि क्या काम करता है और हमने क्या देखा।

Connect a client पेज: एक कुंजी पिकर, claude-haiku* को qwen3.8-27b पर भेजने वाला राउटर नियम, प्रोटोकॉल के हिसाब से समूहित क्लाइंट, और Claude Code पैनल जिसकी ज़रूरतें जाँची जा चुकी हैं

जिस AI के लिए आप पहले से भुगतान करते हैं, उसी से अपने GPU ट्यून करवाएँ।

अपने कार्ड के लिए मॉडल चुनने का मतलब है कई फ़ैसले: क्वांटाइज़ेशन, इंजन, मॉडल को GPU में कैसे बाँटें, कितना कॉन्टेक्स्ट दें और KV-कैश का प्रकार; हर अंदाज़े की क़ीमत एक डाउनलोड और एक लोड है। कंसोल जो भी करता है वह एक API कॉल है, इसलिए Claude Code, Codex या शेल वाला कोई और एजेंट यह खोज आपके लिए, आपके हार्डवेयर पर, आपके वर्कलोड के हिसाब से कर सकता है।

लूप

ट्यूनिंग लूप GPU की जाँच करें, किसी भी डाउनलोड से पहले फ़िट प्रीव्यू से मॉडल छाँटें, संभावित लेआउट लोड करें, असली अनुरोधों से उनका बेंचमार्क करें, सेटिंग बदलें, और सबसे अच्छे को लोड रखें। बेंचमार्क और बदलाव तब तक दोहराए जाते हैं जब तक एजेंट संतुष्ट न हो। 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner ट्यूनिंग लूप GPU की जाँच करें, किसी भी डाउनलोड से पहले फ़िट प्रीव्यू से मॉडल छाँटें, संभावित लेआउट लोड करें, असली अनुरोधों से उनका बेंचमार्क करें, सेटिंग बदलें, और सबसे अच्छे को लोड रखें। बेंचमार्क और बदलाव तब तक दोहराए जाते हैं जब तक एजेंट संतुष्ट न हो। 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner

एजेंट क्या कॉल करता है: GET /api/system/gpus, किसी भी डाउनलोड से पहले POST /api/models/fit-preview, रजिस्टर और suggest-config, पुल और लोड, एक स्ट्रेस रन जो असली कॉन्टेक्स्ट सीमा ढूँढकर लागू करता है, GET /api/stats/v2/throughput और latency, और टेस्ट ट्रैफ़िक भेजने के लिए ख़ुद जारी की गई एक इन्फ़रेंस कुंजी। यह सबसे पहले /agent-guide.md पढ़ता है, जो इन कॉल का एक छोटा विवरण है और एक लैंग्वेज मॉडल के लिए लिखा गया है।

Models पेज पर एक मॉडल लोड हो रहा है: हर चरण के साथ उसका बीता हुआ और सामान्य समय
लेआउट लोड होते समय एजेंट क्या देखता है: हर चरण के साथ पिछले लोड से निकला सामान्य समय। जो लोड आगे बढ़ना बंद कर दे उसे रोक दिया जाता है और उसके GPU मुक्त कर दिए जाते हैं।

पेस्ट करने के लिए चार प्रॉम्प्ट, और बदले में क्या मिलता है

  1. हार्डवेयर देखें और मॉडल छाँटें। पूछें: मेरे GPU की सूची बनाओ, एजेंटिक कोडिंग के लिए ऐसे तीन ओपन-वेट मॉडल छाँटो जो कम से कम 65,536 टोकन के कॉन्टेक्स्ट के साथ फ़िट हों, हर एक को फ़िट प्रीव्यू से जाँचो, कुछ भी डाउनलोड मत करो। आपको मिलता है: मॉडल, क्वांटाइज़ेशन, इंजन, GPU, कॉन्टेक्स्ट और कारण की एक तालिका।
  2. एक मॉडल के लिए इंजन और लेआउट। पूछें: मेरे कार्ड पर vLLM या llama.cpp, और टेंसर पैरेलल या डेटा पैरेलल रेप्लिका तय करो; सबसे अच्छे दो लेआउट लोड करो, हर एक को वही 20 स्ट्रीमिंग अनुरोध भेजो, कॉन्करेंसी 1 और 8 पर तुलना करो। आपको मिलता है: दोनों के लिए पहले टोकन तक का समय और प्रति सेकंड टोकन, विजेता लोड रहता है, दूसरा अनलोड, टेस्ट कुंजी रद्द।
  3. असली सीमाएँ ढूँढें और लागू करें। पूछें: लोड किए गए मॉडल का स्ट्रेस रन करो, मापा गया कॉन्टेक्स्ट लागू करो, फिर लगभग 2k और 30k टोकन के प्रॉम्प्ट के साथ कॉन्करेंसी 1, 4 और 16 पर बेंचमार्क करो। आपको मिलता है: मॉडल की सेटिंग में लिखी गई कॉन्टेक्स्ट सीमा, और हर कॉन्करेंसी और प्रॉम्प्ट आकार के लिए पहले टोकन तक का समय और प्रति सेकंड टोकन की एक तालिका।
  4. अपने ही काम पर दो उम्मीदवारों की तुलना करें। पूछें: ./workload/*.txt के प्रॉम्प्ट मॉडल A और मॉडल B पर कॉन्करेंसी 4 पर दोबारा चलाओ, हर जवाब को परखो। आपको मिलता है: model-comparison.md, जिसमें लेटेंसी, प्रति सेकंड टोकन, एजेंट के आकलन में जवाब कितने सही हैं, और एक सिफ़ारिश है; सुझाया गया मॉडल लोड रहता है।

शुरू करने से पहले। एडमिन टोकन के पास warden पर पूरे एडमिन अधिकार होते हैं (मॉडल, कुंजियाँ, सेटिंग; सीमित अधिकारों वाले टोकन अभी नहीं हैं): इसकी समय-सीमा छोटी रखें और काम पूरा होने पर Settings → Access Tokens में इसे रद्द करें। स्ट्रेस रन सीमा ढूँढने के लिए जान-बूझकर इंजन को क्रैश करता है: ये प्रॉम्प्ट ऐसे warden पर चलाएँ जिस पर कोई और निर्भर न हो। डाउनलोड बड़े होते हैं; प्रॉम्प्ट पुल करने से पहले फ़िट जाँचते हैं, लेकिन अपनी डिस्क पर नज़र रखें।

इंजन और लेआउट के विकल्प (vLLM, टेंसर पैरेलल या डेटा पैरेलल) Linux इंस्टॉल में हैं; Mac पर विकल्प एक GPU पर MLX या llama.cpp है। ट्यूनिंग करने वाला मॉडल कोई भी हो सकता है जिसके लिए आप पहले से भुगतान करते हैं; ट्यून होने वाला मॉडल वही है जो आपके कार्ड पर चलता है। एजेंट-ट्यूनिंग पेज: चारों प्रॉम्प्ट पूरे।

एक GPU मशीन, जिसे आपकी पूरी टीम, आपका परिवार और आपके एजेंट साझा करें।

जितनी ज़रूरत हो उतनी API कुंजियाँ बनाएँ और बाँटें: सहकर्मी, परिवार का सदस्य, CI जॉब, एजेंट फ़ार्म, हर एक की अपनी कुंजी, अपनी प्राथमिकता और अपना उपयोग पेज। हार्डवेयर सबके लिए काम करता है, और ज़रूरी काम को कभी इंतज़ार नहीं करना पड़ता।

आपका हार्डवेयर, जैसा है वैसा: एक Mac से आठ B300 तक।

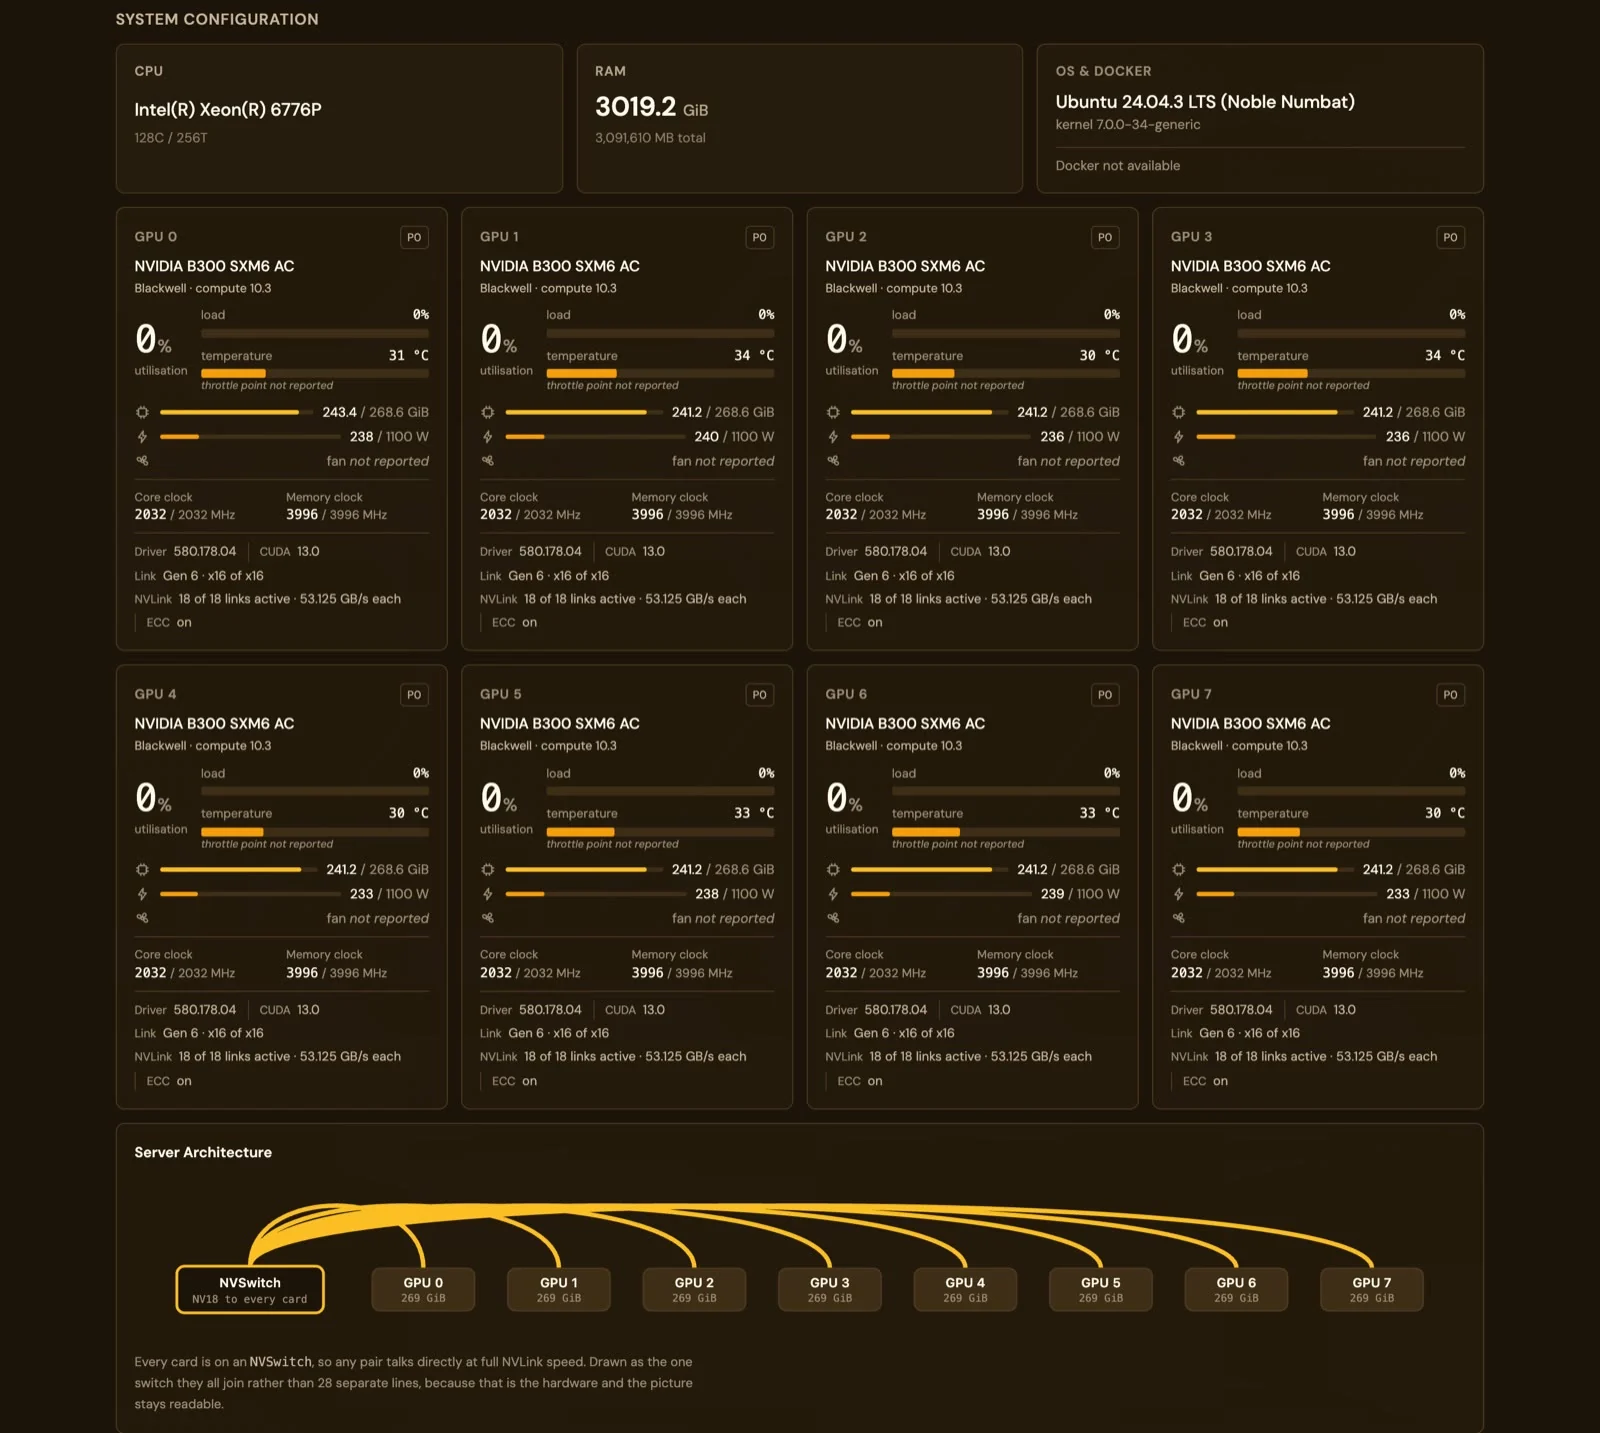
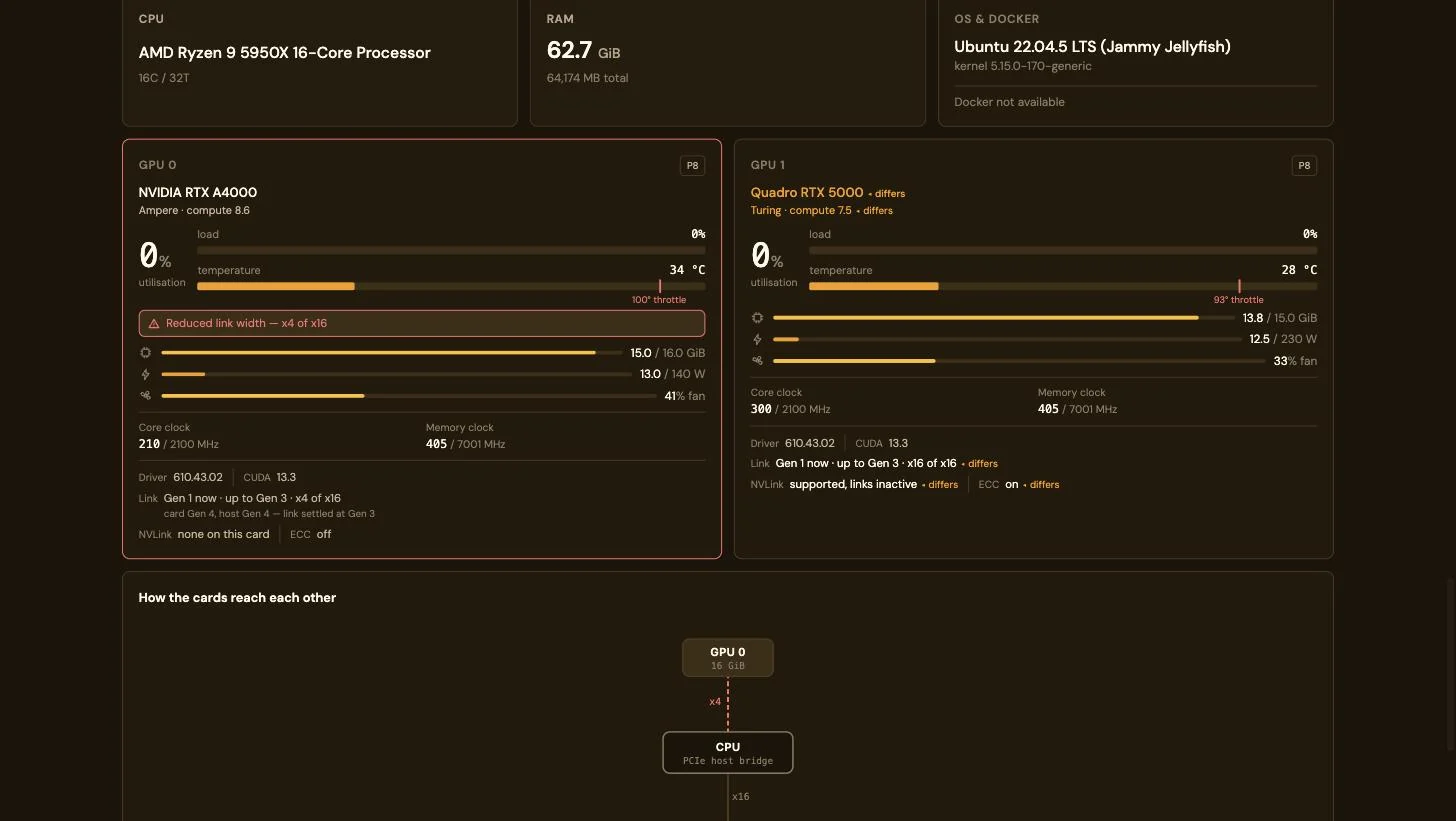
वही कंसोल 16 GB वाले M1, वर्कस्टेशन में लगे दो अलग-अलग मॉडल के कार्ड, और 8 × B300 NVSwitch सर्वर, सबको पढ़ता है, और रुकावट को औसत में छिपाने के बजाय साफ़ बताता है: x16 के बजाय x4 पर चल रहा PCIe लिंक, निष्क्रिय NVLink लिंक, कार्डों के बीच ECC का अंतर।

8 × B300 सर्वर का सिस्टम कॉन्फ़िगरेशन: Intel Xeon 6776P, 3019 GiB RAM, आठ NVIDIA B300 SXM6 पैनल, हर एक में 268.6 GiB में से 241 उपयोग में, Link Gen 6 x16 of x16, NVLink के 18 में से 18 लिंक सक्रिय, हर एक 53.125 GB/s पर, ECC चालू, और एक सर्वर-आर्किटेक्चर चित्र जिसमें एक NVSwitch हर कार्ड से जुड़ा है
एक NVSwitch पर आठ B300 SXM6 कार्ड: हर कार्ड पर 18 में से 18 NVLink लिंक सक्रिय, ECC चालू, PCIe Gen 6 x16, और टेंसर पैरेलल 8 पर GLM-5.2 NVFP4 चलाते समय हर कार्ड पर 268.6 GiB में से 241 उपयोग में।
दो बेमेल GPU: एक NVIDIA RTX A4000 जिस पर लाल Reduced link width x4 of x16 चेतावनी है और अभी Link Gen 1, Gen 3 तक, उसके बगल में एक Quadro RTX 5000 जिसका आर्किटेक्चर, VRAM, पावर कैप, लिंक, NVLink और ECC हर एक differs के रूप में चिह्नित है; नीचे एक चित्र कि कार्ड x4 और x16 लिंक से CPU तक कैसे पहुँचते हैं
सालों के अंतर पर ख़रीदे गए दो कार्ड: A4000 का लिंक x16 के बजाय x4 पर चल रहा है और लाल रंग में चिह्नित है; Quadro का आर्किटेक्चर, पावर कैप, NVLink (सपोर्टेड, पर लिंक निष्क्रिय) और ECC, हर एक पर differs लिखा है। चित्र दिखाता है कि कौन-सा स्लॉट कम चौड़ाई पर चल रहा है।
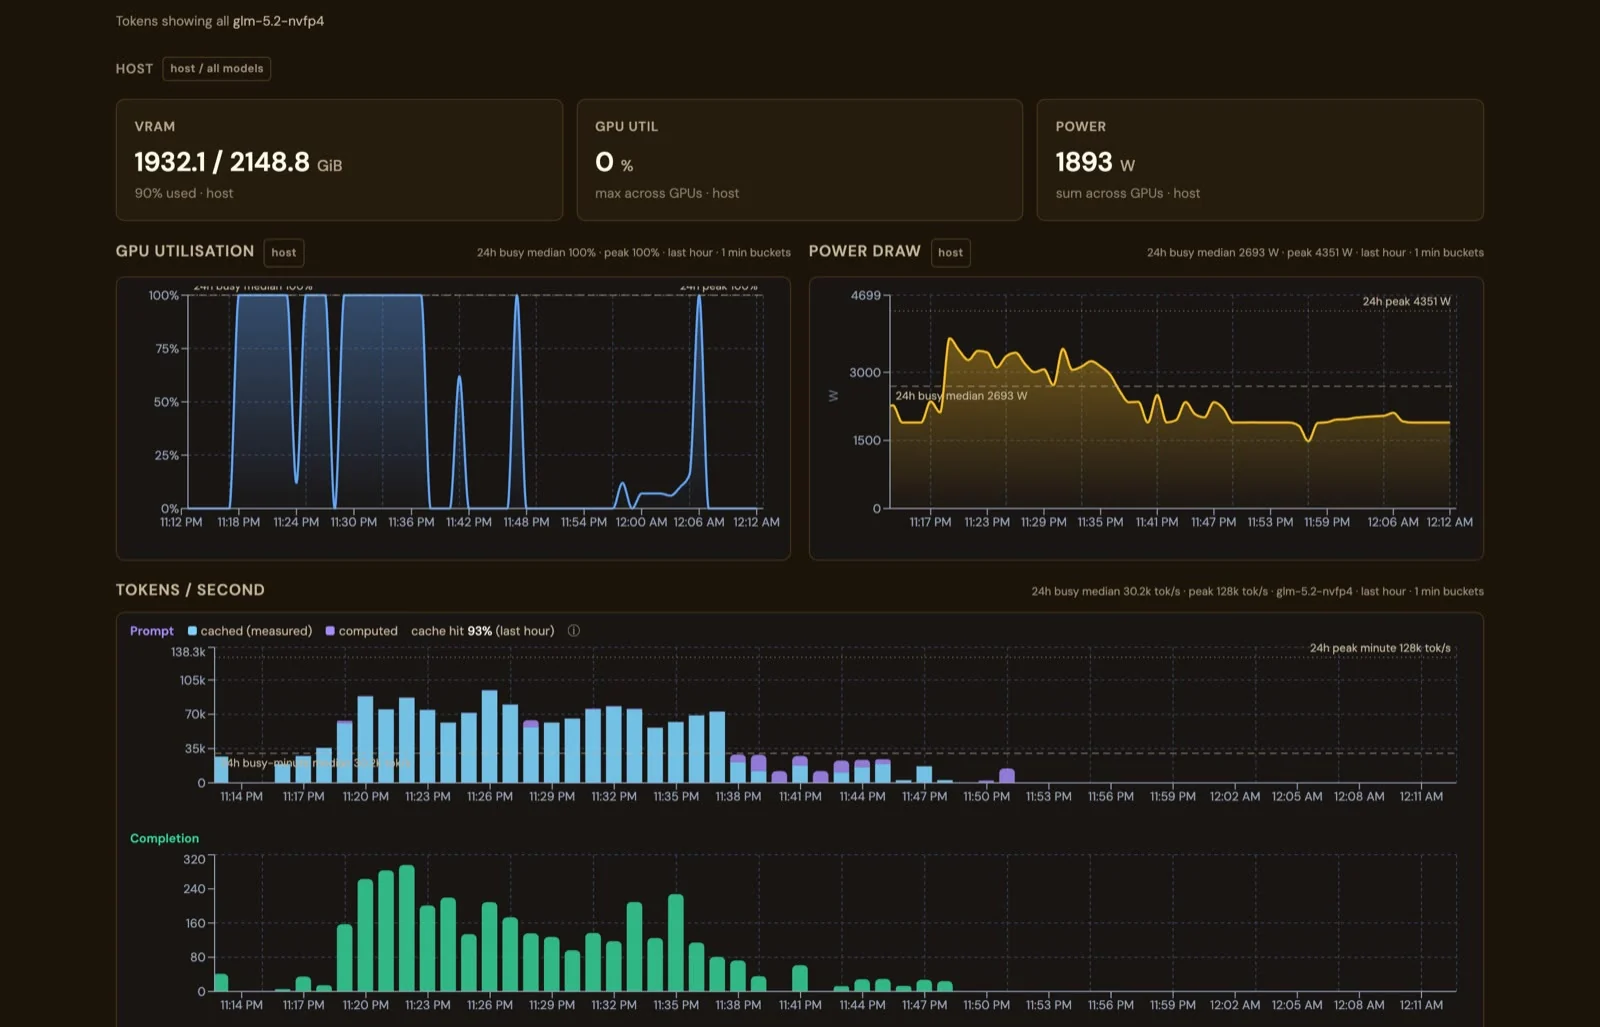
8 × B300 सर्वर पर Stats: VRAM 2148.8 GiB में से 1932.1, सभी कार्ड मिलाकर पावर 1893 W, पिछले एक घंटे का GPU उपयोग और पावर खपत, और प्रति सेकंड प्रॉम्प्ट टोकन, कैश से मिले और गणना किए गए हिस्सों में बँटे, 93% कैश हिट के साथ
वही Stats पेज, सबसे बड़े सेटअप पर: 2,149 GiB में से 1,932 VRAM, सभी कार्ड मिलाकर 1,893 W, उस घंटे में 4,351 W का शिखर, और 93% प्रॉम्प्ट टोकन कैश से।
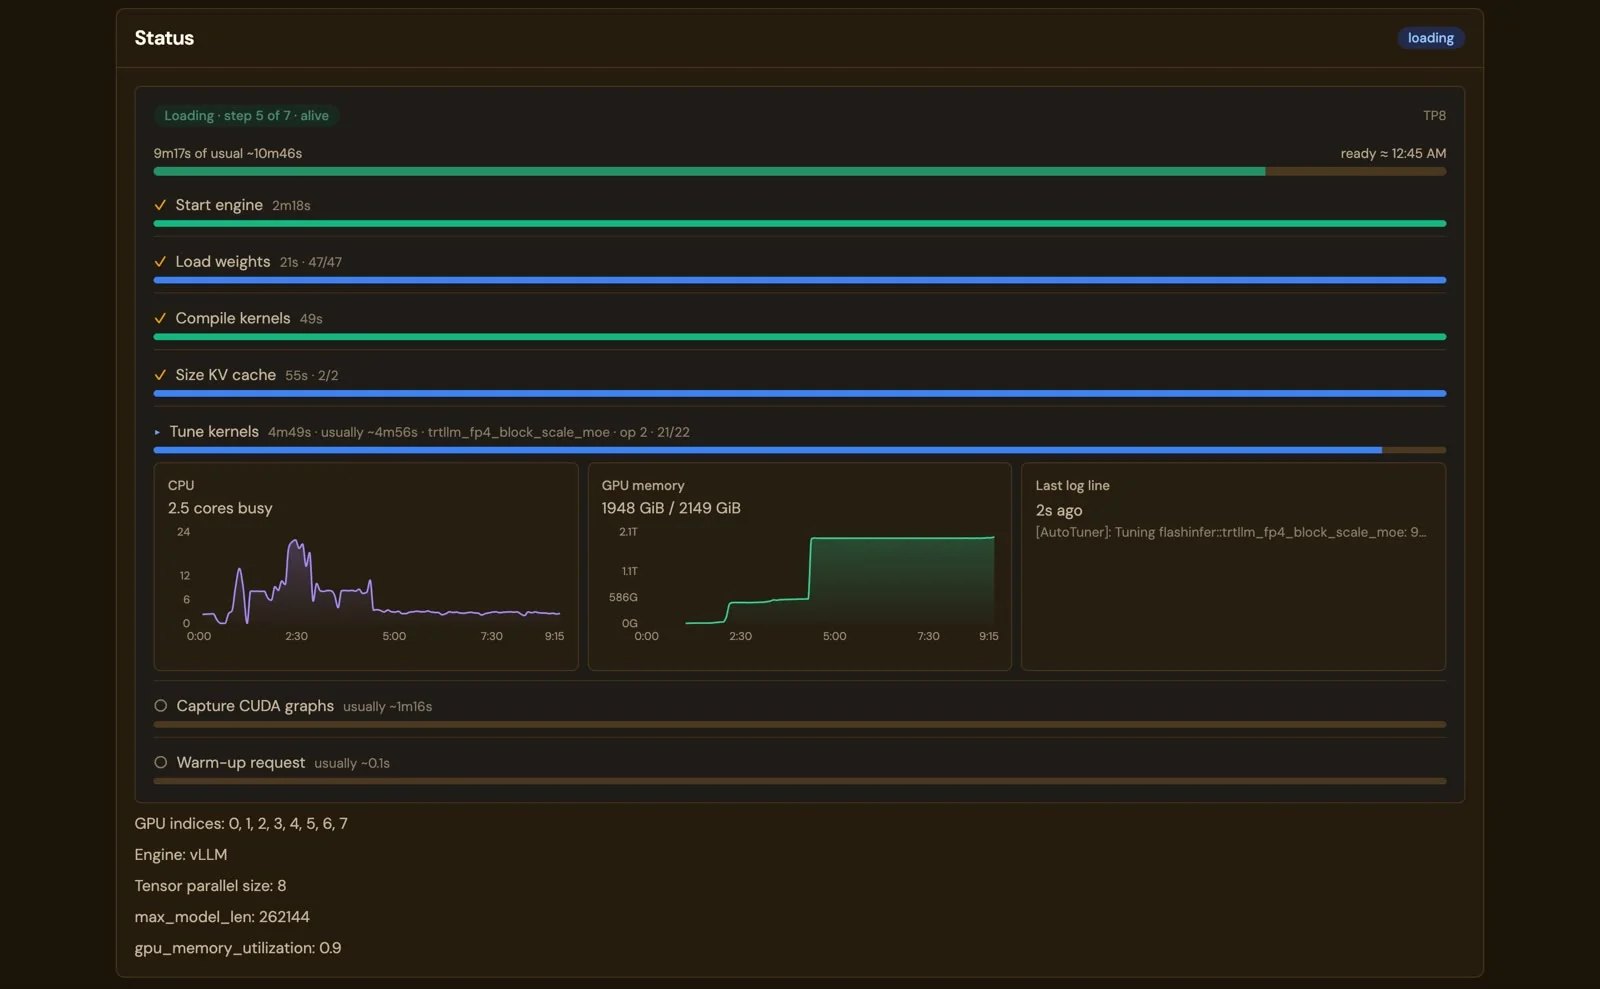
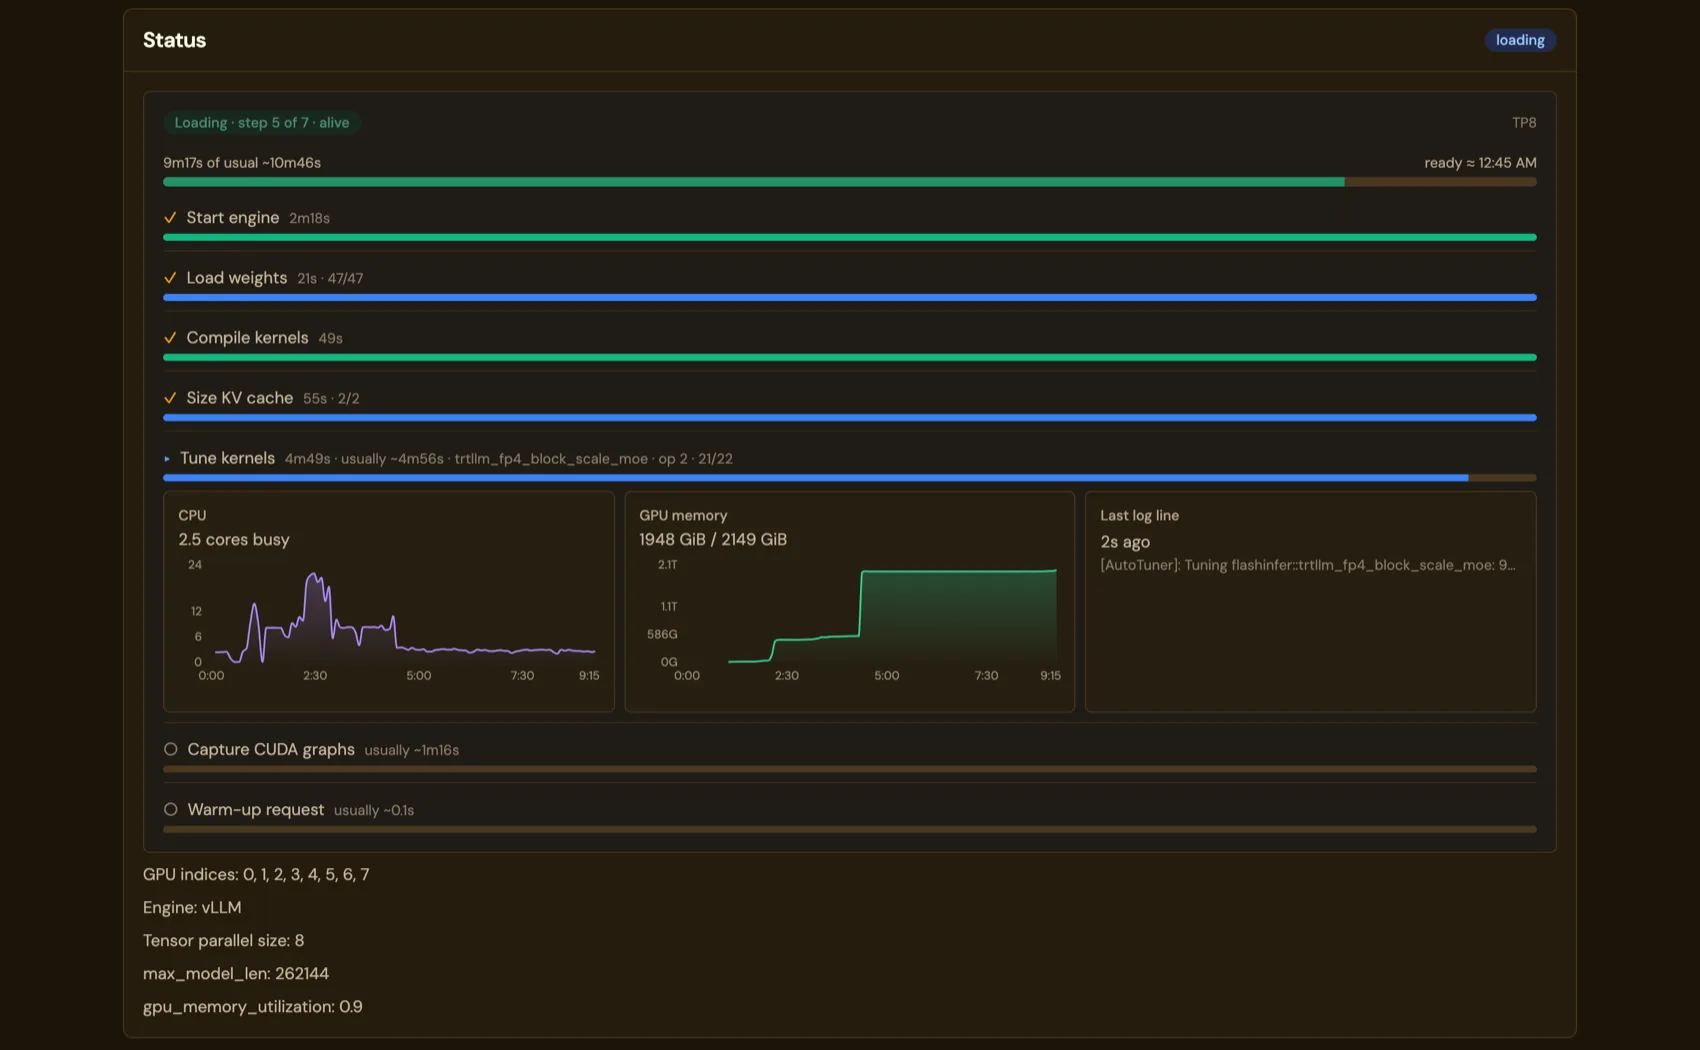
आठ B300 पर GLM-5.2 NVFP4 लोड होते समय मॉडल पेज: सामान्य 10 min 46 s में से 9 min 17 s बीते, चरण Start engine, Load weights 47 of 47, Compile kernels और Size KV cache पूरे, Tune kernels 22 में से ऑप 21 पर, साथ में CPU और GPU-मेमोरी चार्ट और आख़िरी लॉग पंक्ति
10 मिनट का लोड, चरण-दर-चरण: आठ B300 पर GLM-5.2 NVFP4, सामान्य 10 min 46 s में से 9 min 17 s बीत चुके हैं; जब तक लोड आगे बढ़ रहा है, कुछ भी लाल नहीं होता।

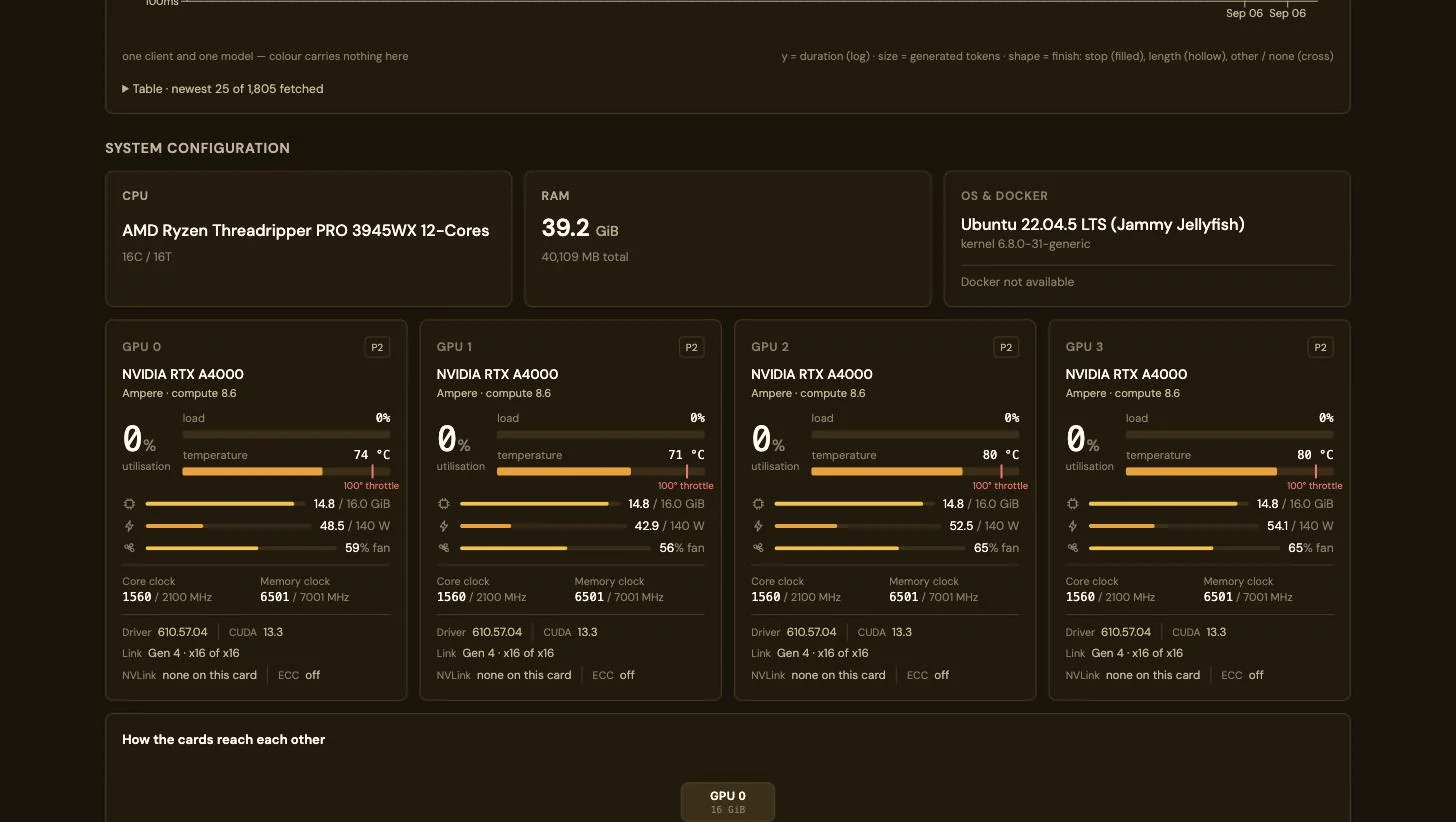
हर पैनल हर कार्ड के लिए क्या दिखाता है: उसके अपने थ्रॉटल पॉइंट के मुक़ाबले तापमान, उसकी पावर सीमा के मुक़ाबले पावर, क्लॉक, फ़ैन, इस समय तय हुई PCIe जनरेशन और चौड़ाई, कार्ड में हों तो ECC और NVLink, और मेमोरी इस्तेमाल कर रहा प्रोसेस। इंटरकनेक्ट चित्र nvidia-smi topo -m से पढ़ा जाता है। Mac पर: GPU उपयोग और Metal का बताया मेमोरी बजट, पावर के बिना। और इन सबके नीचे चल रहे इंजन की निगरानी उसके अपने /health से होती है, प्रोसेस टेबल से नहीं: अगर रैपर चल रहा हो पर अंदर का इंजन बंद पड़ा हो, तो सबूत सहेजकर इंजन दोबारा लोड किया जाता है।

यह क्या दिखाता है

GPU मॉनिटरिंग

हर कार्ड अपनी रिपोर्ट ख़ुद देता है।

उपयोग, उस कार्ड के अपने थ्रॉटल पॉइंट के मुक़ाबले तापमान, उसकी कैप के मुक़ाबले पावर, VRAM, क्लॉक, PCIe लिंक और कौन-सा प्रोसेस मेमोरी पकड़े है। पूरी मशीन का औसत नहीं।

सिस्टम कॉन्फ़िगरेशन और NVIDIA RTX A4000 कार्ड के चार GPU पैनल, हर कार्ड का उपयोग, तापमान, VRAM, पावर, फ़ैन और क्लॉक

चल रहे अनुरोध

देखें कि हर एजेंट अभी क्या कर रहा है।

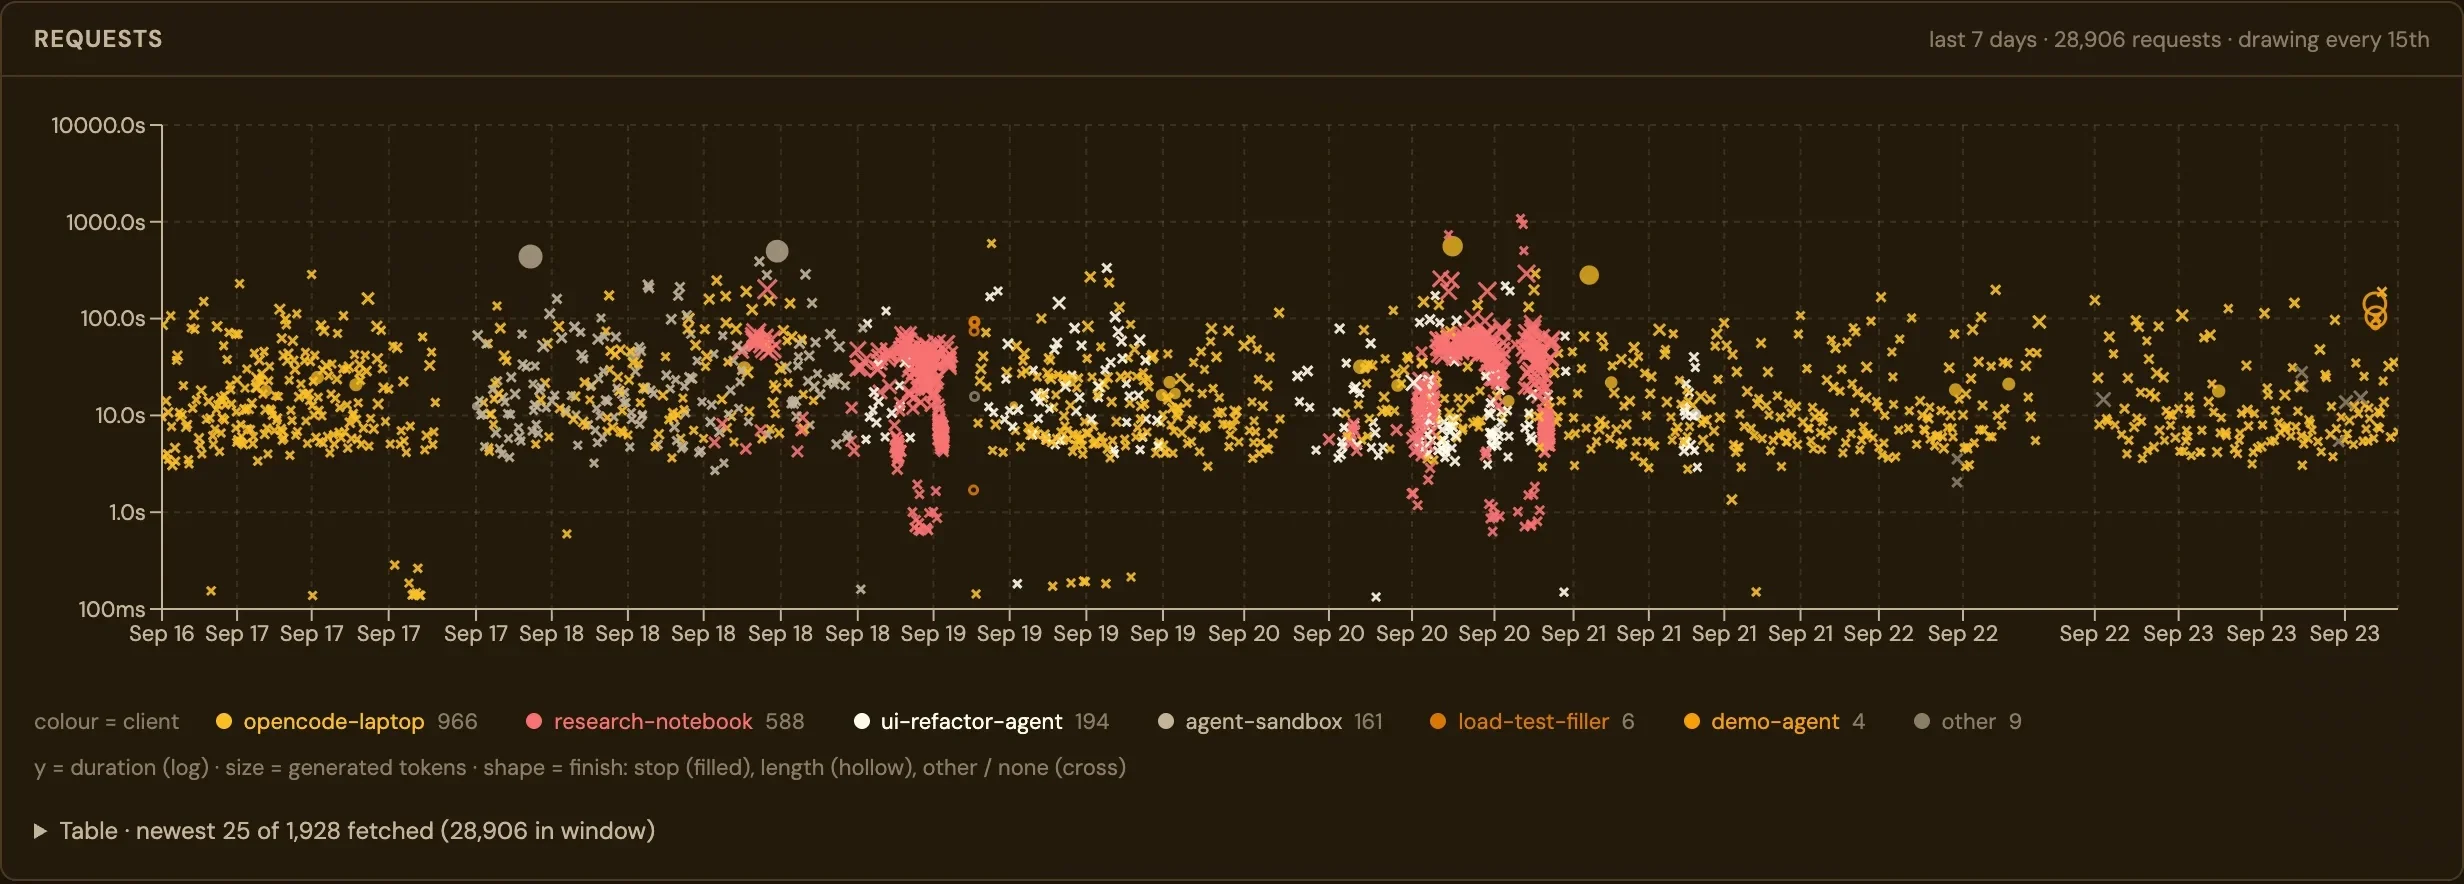
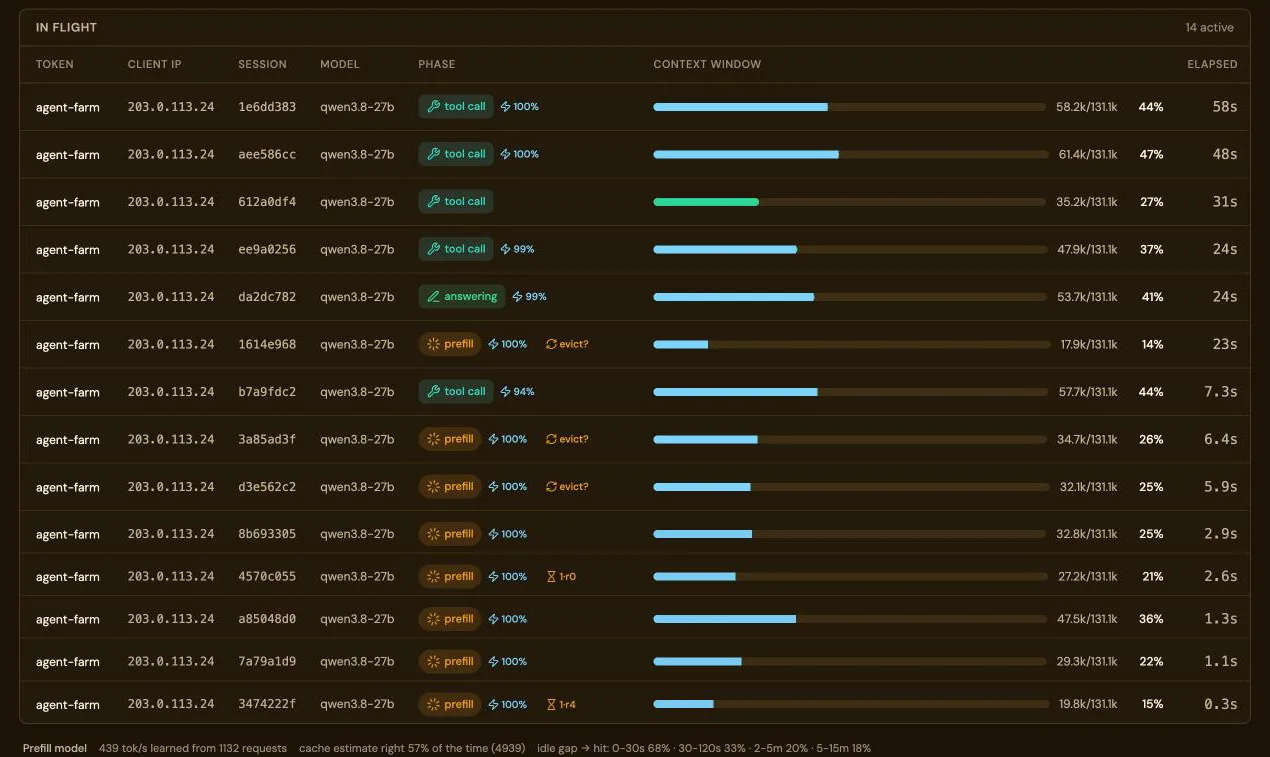
हर अनुरोध उसकी कुंजी, सेशन और चरण के साथ: क़तार में, प्रीफ़िल, सोच रहा है, टूल कॉल, जवाब दे रहा है। हर प्रॉम्प्ट का कितना हिस्सा प्रीफ़िक्स कैश से आया, प्रति अनुरोध मापा गया।

चल रहे अनुरोधों की तालिका: दस सक्रिय अनुरोध, हर एक की कुंजी, सेशन, चरण और टोकन के साथ

कोडिंग एजेंट

Claude Code, Codex और OpenCode, एक ही पेज से कनेक्ट।

Connect इस warden के पते, एक कुंजी और एक लोड किए हुए मॉडल के साथ हर टूल का कॉन्फ़िग लिखता है, ज़रूरतों को असल में लोड किए गए मॉडल से मिलाकर जाँचता है, और एक टेस्ट अनुरोध भेजता है।

Connect a client पेज, जिसमें Claude Code चुना गया है और ज़रूरतें जाँची जा चुकी हैं

मुफ़्त, ओपन सोर्स, और सबके सामने विकसित।

LM Warden GitHub पर Apache-2.0 लाइसेंस के तहत है: इंस्टॉल स्क्रिप्ट और Compose फ़ाइल ही पूरा डिप्लॉयमेंट हैं, और आप दोनों पढ़ सकते हैं। न अकाउंट, न लाइसेंस जाँच, न टेलीमेट्री। vLLM, llama.cpp और MLX अपस्ट्रीम प्रोजेक्ट हैं जिन्हें हम बिना बदलाव के चलाते हैं।

mlx-rust-lm जल्द आ रहा है

Apple के mlx-lm का Python से Rust में पोर्ट, Apple की आधिकारिक mlx-c बाइंडिंग पर, जिसे LM Warden टीम एक अलग ओपन-सोर्स प्रोजेक्ट के रूप में विकसित और मेंटेन करती है। LM Warden इसे Mac के तीसरे इंजन के रूप में उपयोग करेगा, और आख़िरकार यह Python वाले mlx-lm इंजन की जगह लेगा, जो आज के Mac डाउनलोड का ज़्यादातर हिस्सा है। अनौपचारिक, Apple से संबद्ध नहीं।