LM Warden

手元の GPU を、ホスト型 API のように。

LM Warden は、自分のハードウェア上で vLLM、llama.cpp、MLX を実行し、その前段に OpenAI 互換のポートを一つ用意します。アプリごとのキー、キーごとの使用量、すべての GPU のライブ パネルを備え、NVIDIA カードを搭載した Linux マシンでも、Apple シリコン搭載の Mac でも動きます。

オープンソース、Apache-2.0アカウント不要、テレメトリなしLinux + NVIDIA · macOS (ベータ版) · Windows は開発中

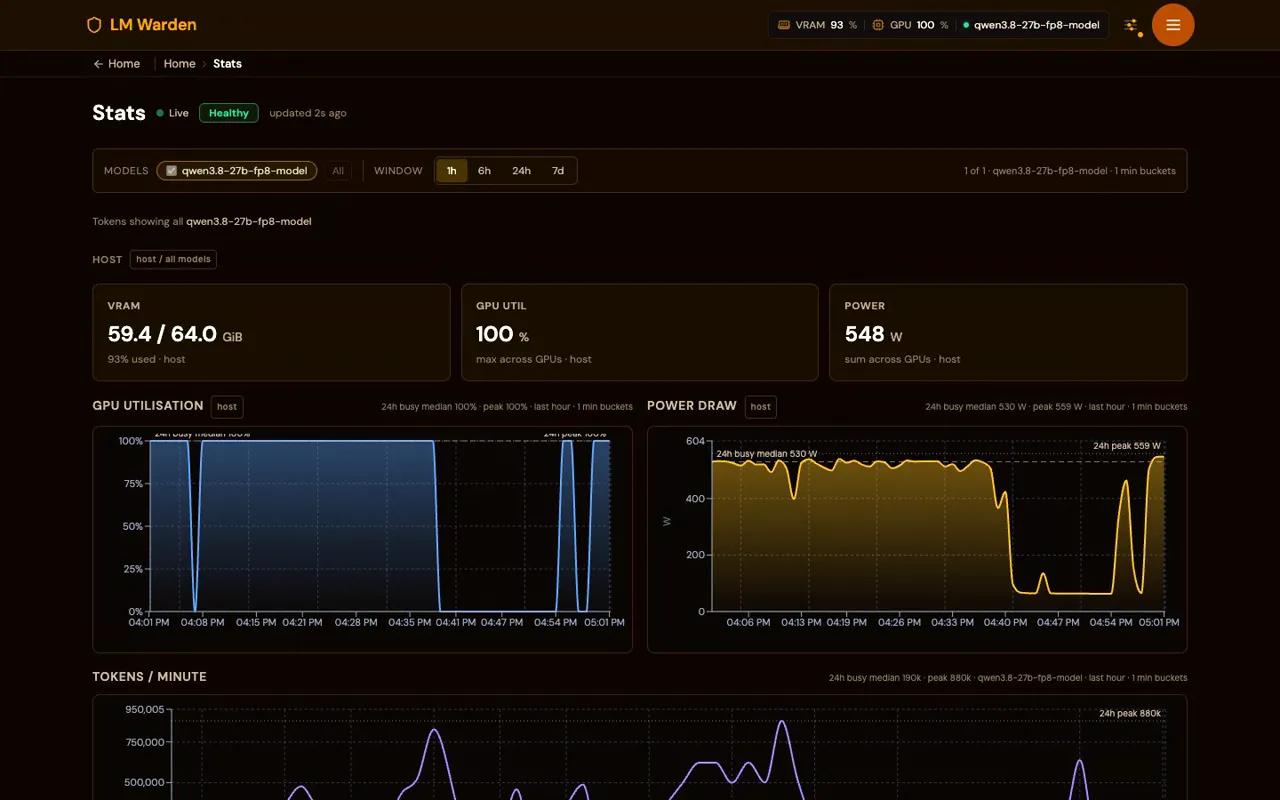
稼働中の LM Warden インスタンスの Stats ページ:VRAM 59.4/64 GiB、GPU 使用率 100%、電力 548 W、過去一時間の GPU 使用率、消費電力、毎分トークン数のグラフ
  • Linux · NVIDIA vLLM v0.32.0 と llama.cpp b11719 CUDA で動作
  • macOS · Apple シリコン MLX と llama.cpp Metal で動作
  • API OpenAI、Anthropic Messages、Responses 一つのポートで提供
  • コーディング エージェント Claude Code、Codex CLI、OpenCode ほか 7 種 設定は自動

こんな使い方をされています

どこで実行しますか?

上でプラットフォームを選ぶと手順が表示されます。四つすべてを表示することもできます。

GPU ホストでコマンドを一つ実行するだけ。

curl -fsSL https://raw.githubusercontent.com/Podwarden/lm-warden/main/install.sh | sh -s -- --dir /opt/vllm-warden
  • x86_64 ホスト、Docker Compose v2.24 以降、NVIDIA Container Toolkit、Turing 以降のカード。
  • 次に http://HOST:8080/ui/ を開き、初回セットアップ ウィザードを完了して、モデルを追加し、キーを発行します。エンドポイントは http://HOST:8080/v1 です。
  • 一台に複数の GPU:テンソル並列、またはカードごとに一つのレプリカとキャッシュを考慮したルーティング。
  • 現在は NVIDIA に対応しています。AMD ROCm と Intel GPU にも近日対応予定です。時期はまだ決まっていません。どれで動かしたいか教えてください:Radeon · Intel。
  • インストール ガイド · オフライン / エアギャップ · ソースから · アップグレード
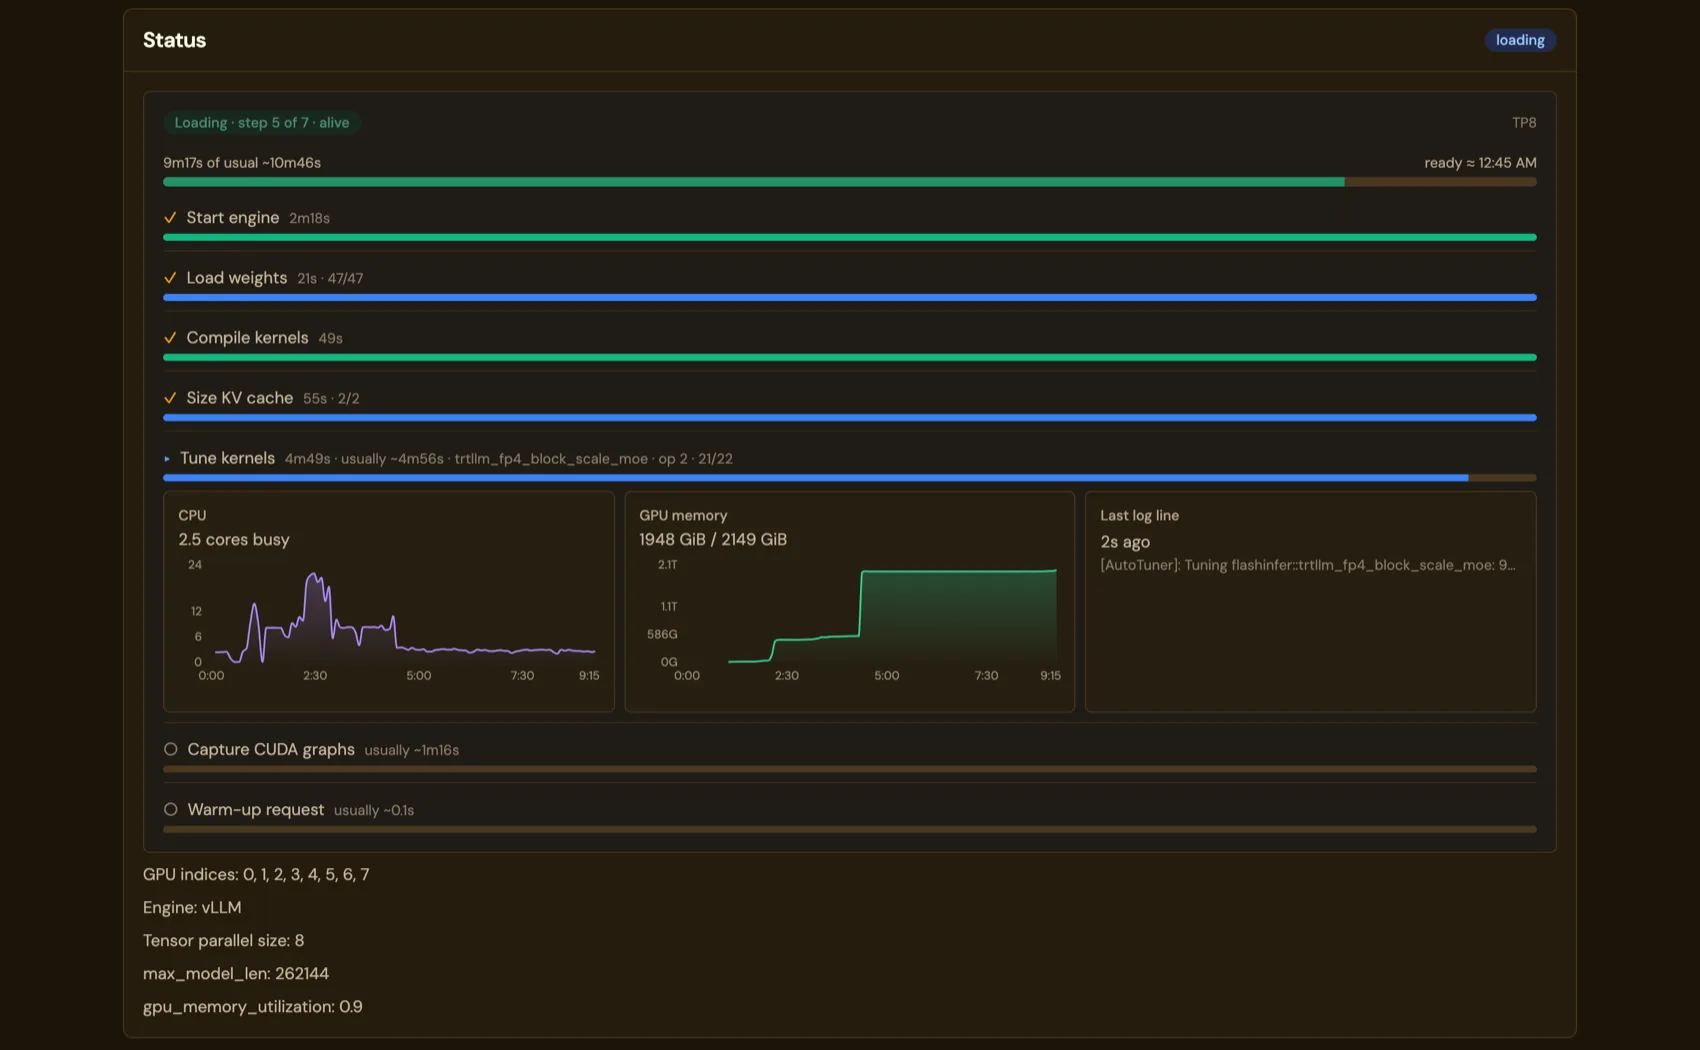
Models ページでモデルを読み込み中。各ステップに経過時間と通常の所要時間が表示されています
インストール後のモデルの読み込み:各ステップに、過去の読み込みでの通常の所要時間が表示されます。

メニュー バー アプリ、ベータ版。

Mac 版をダウンロード (ベータ版)

  • 約 110 MB。Apple シリコン (M1 以降)、macOS 14 以降。SHA-256 · リリース ノート。
  • エンジン:MLX と、Metal 対応でビルドした llama.cpp。同じダッシュボードと同じ OpenAI API です。vLLM と電力表示はありません。
  • 率直に言うとベータ版です:アドホック署名で公証を受けていないため、初回起動時に macOS から「プライバシーとセキュリティ」で許可するよう求められます。更新は新しいダウンロードで行います。初回起動の手順。
  • Share on Local Network を選ぶまでは 127.0.0.1 でのみ提供します。
  • 近日公開:mlx-rust-lm、三つ目のエンジンです。LM Warden チームは、Apple の mlx-lm を Apple 公式の mlx-c バインディング上で Python から Rust に移植しています。MLX や llama.cpp と並んで動作し、いずれは Python 版の mlx-lm エンジンを置き換えます。現在のダウンロードの大半は、このエンジンと Python およびそのライブラリです。非公式であり、Apple とは提携していません。
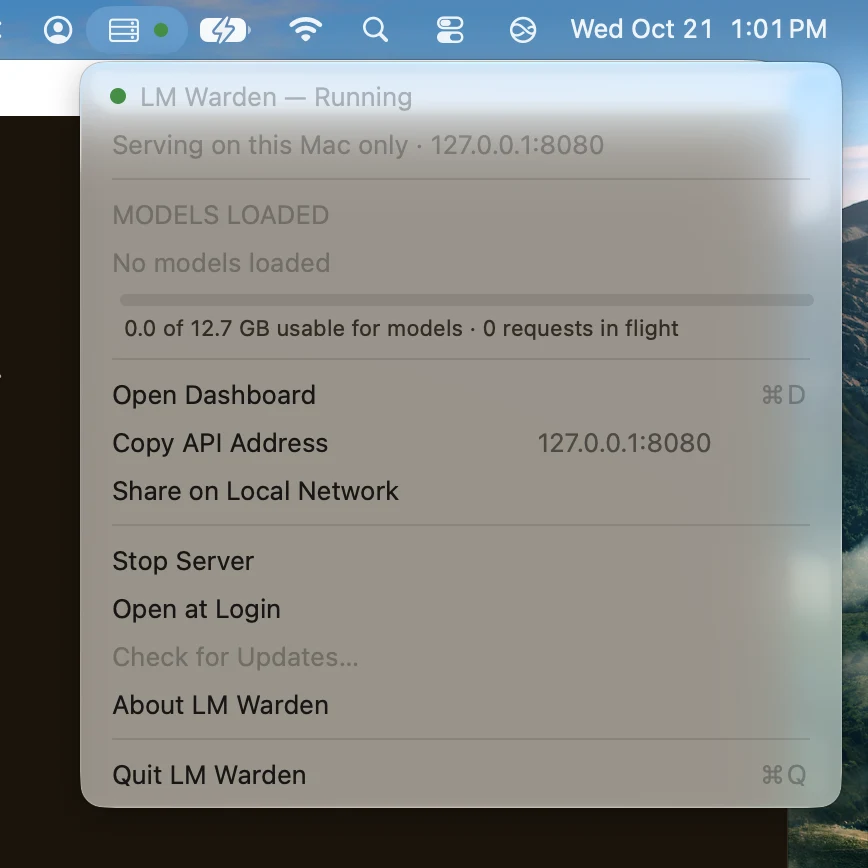
Mac の LM Warden メニュー バー メニュー:Running、この Mac の 127.0.0.1:8080 でのみ提供中、読み込まれたモデルなし、メモリ バー、Open Dashboard、Copy API Address、Share on Local Network
16 GB の M1 で動くベータ版のメニュー バー メニュー。

次は Windows です。時期は未定です。

現在開発中で、ビルドができた日にここに置きます。その前に登録フォームを置くことはしません。それまでの間、現実的な選択肢は二つです:

  • Linux の GPU マシンで LM Warden を実行し、Windows から使います。どの OpenAI クライアントも、Claude Code も Codex も、ネットワーク経由で接続できます。
  • GitHub でリリースをウォッチすると、最初の Windows ビルドの公開を知ることができます。
  • AMD Radeon と Intel GPU はその後です。どれで動かしたいか教えてください:Radeon · Intel。

アプライアンス:近日公開、時期は未定。

LM Warden を動かす四つ目の方法。ほかに何もしないマシンのためのものです。

  • GPU を積んだシャーシに USB ドライブを挿します。LM Warden を実行するというひとつのことだけを行う最小構成の Linux がインストールされます。
  • ネットワークとモデル用ストレージを自動で設定します。
  • 更新は OTA アップデートで届きます。完全なエアギャップ環境で運用することもできます。
  • 安全な専用 LLM サーバー向けです。ロックダウンしたマシンが欲しいチームや、外部への経路がない拠点に。

リリースまでは、上の Linux インストールが、自分で用意したホストで同じ役割を果たします。オフライン / エアギャップ環境へのインストールにも対応しています。GitHub でリリースをウォッチ。

まだ画像はありません。見せられる製品名もハードウェアもなく、想像図を描くこともしません。

すでにお使いですか? Linux はその場でアップグレードできます。新しいイメージを pull して再起動すれば、データベースは自動的に新しいスキーマへ移行されます。手順 · 変更履歴。

セルフホスティングには八つの問題があります。それぞれを解決するとこうなります。

素のエンジンは、一つのポートで一つのモデルを提供するだけです。ここで紹介するのは、その周りに必要な仕組みです。自社で測定した数値がある場合は併記しています。

  1. このモデルは自分の GPU に収まりますか?

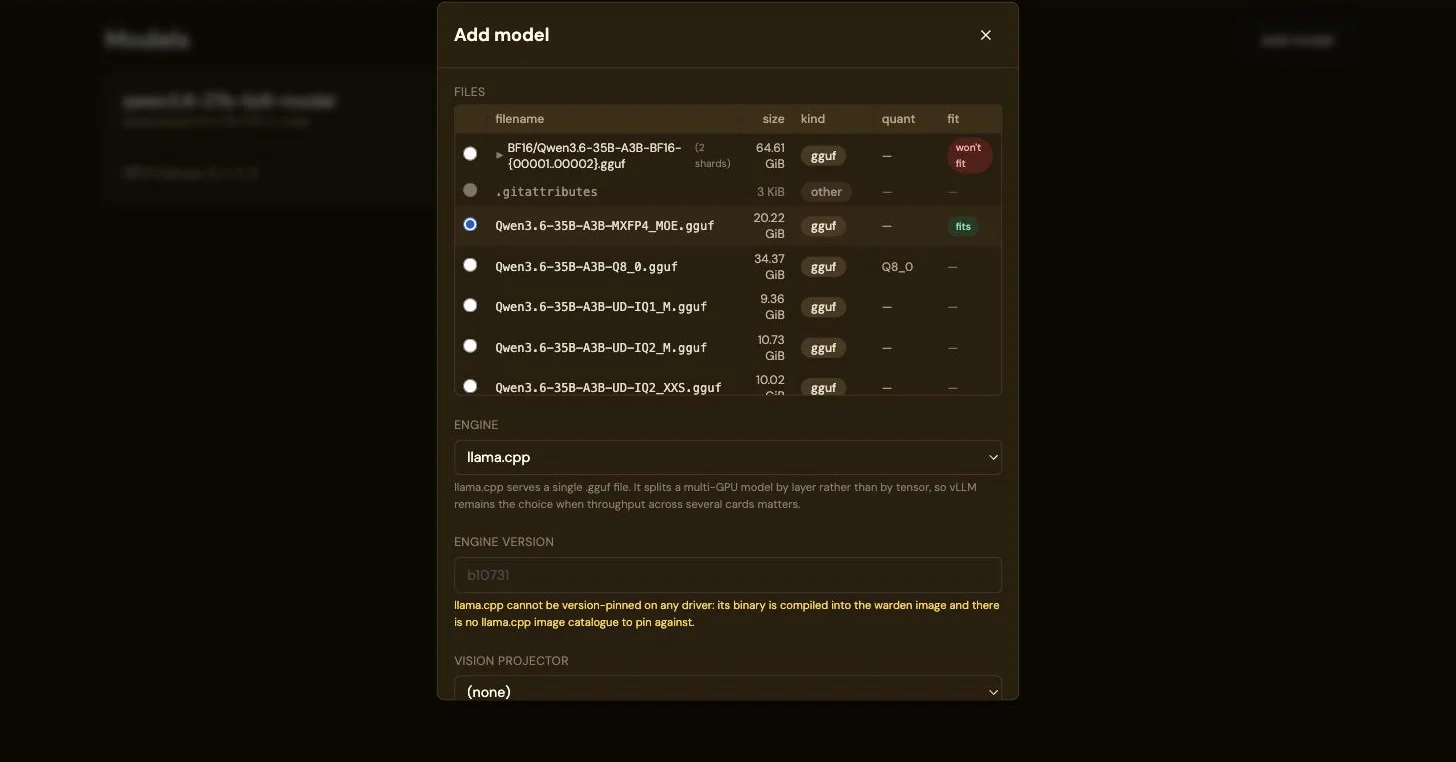
    Hugging Face リポジトリを Add model に貼り付けます。すべてのファイルが、チェックしたカードに対する判定 (収まる、余裕が少ない、収まらない) とともに一覧表示されます。チェックするカードを増やすと、使える VRAM が合算されます。収まるものが見つかるまで、何もダウンロードされません。

    GPU を四枚選択すると、同じ 20.22 GiB のファイルが収まると表示される
  2. GPU を買いました。働いていますか、それとも待っていますか?

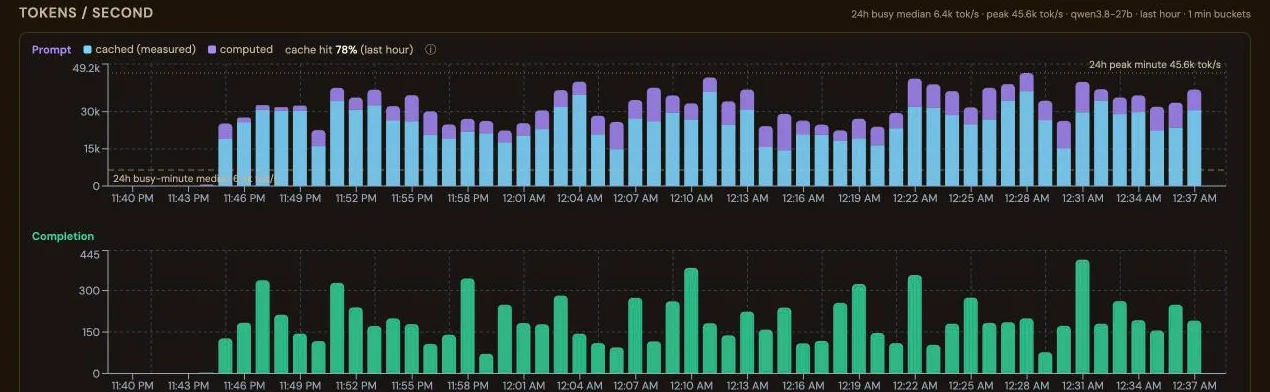
    スループットは「同時実行数 × プロンプト長 × キャッシュ再利用」で決まりますが、素のエンジンはそれらをまとめて見せてくれません。Stats ページなら 1 h から 7 d の範囲で表示できます:VRAM、GPU 使用率、電力 (Linux)、キャッシュ済みと計算分に分けたプロンプト トークンを含む毎秒トークン数、p50/p95 レイテンシ、プロンプト キャッシュのヒット率、プリエンプション、キーごと・クライアント IP ごとのリクエスト数。キューがあるのに使用率が横ばいなら「同時実行数を増やす」、キャッシュ比率が低いなら「セッションを固定する」というサインです。

    毎秒トークン数:プロンプト トークンをキャッシュ済みと計算分に分け、その下に生成トークン
  3. 何かを接続する前に、まずモデルと話してみましょう。

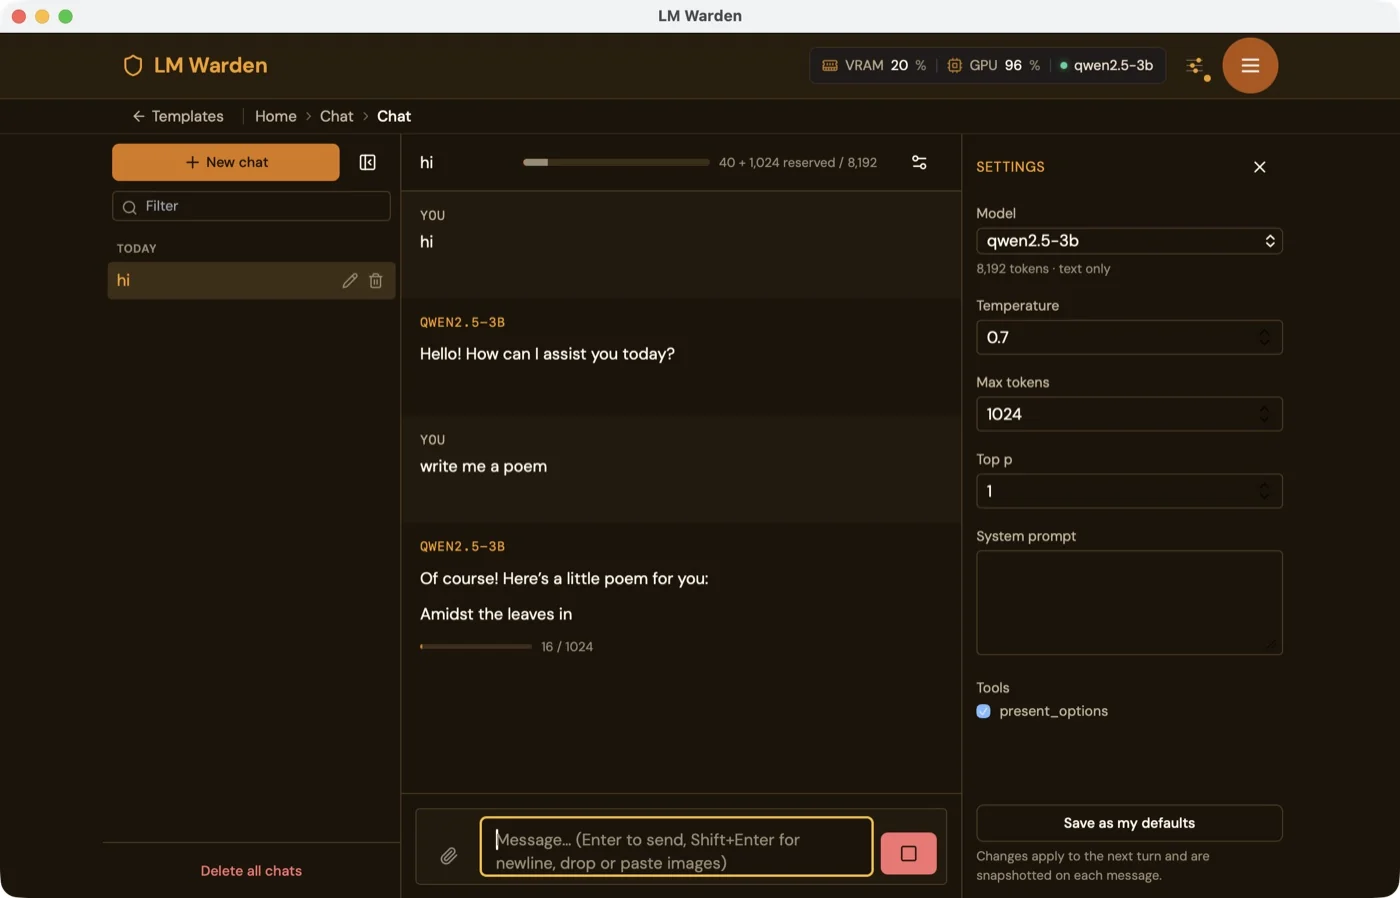
    チャットはほかの機能と同じウィンドウにあります。コードのハイライトと数式に対応したストリーミング Markdown。ビジョン モデルにはメッセージあたり最大八枚の PNG、JPEG、WebP 画像。チャットごとの temperature、top-p、最大トークン数、システム プロンプトを既定値として保存。チャットは保存され、タイトルが付き、分岐もできます。モデルが行うツール呼び出しも表示されるので、エージェントが依存する前にツール呼び出しを確認できます。

    Mac アプリのダッシュボード ウィンドウのチャット。qwen2.5-3b からストリーミング中で、ヘッダーに GPU 96% と表示
  4. モデルは実際に何を見て、何を言ったのでしょうか?

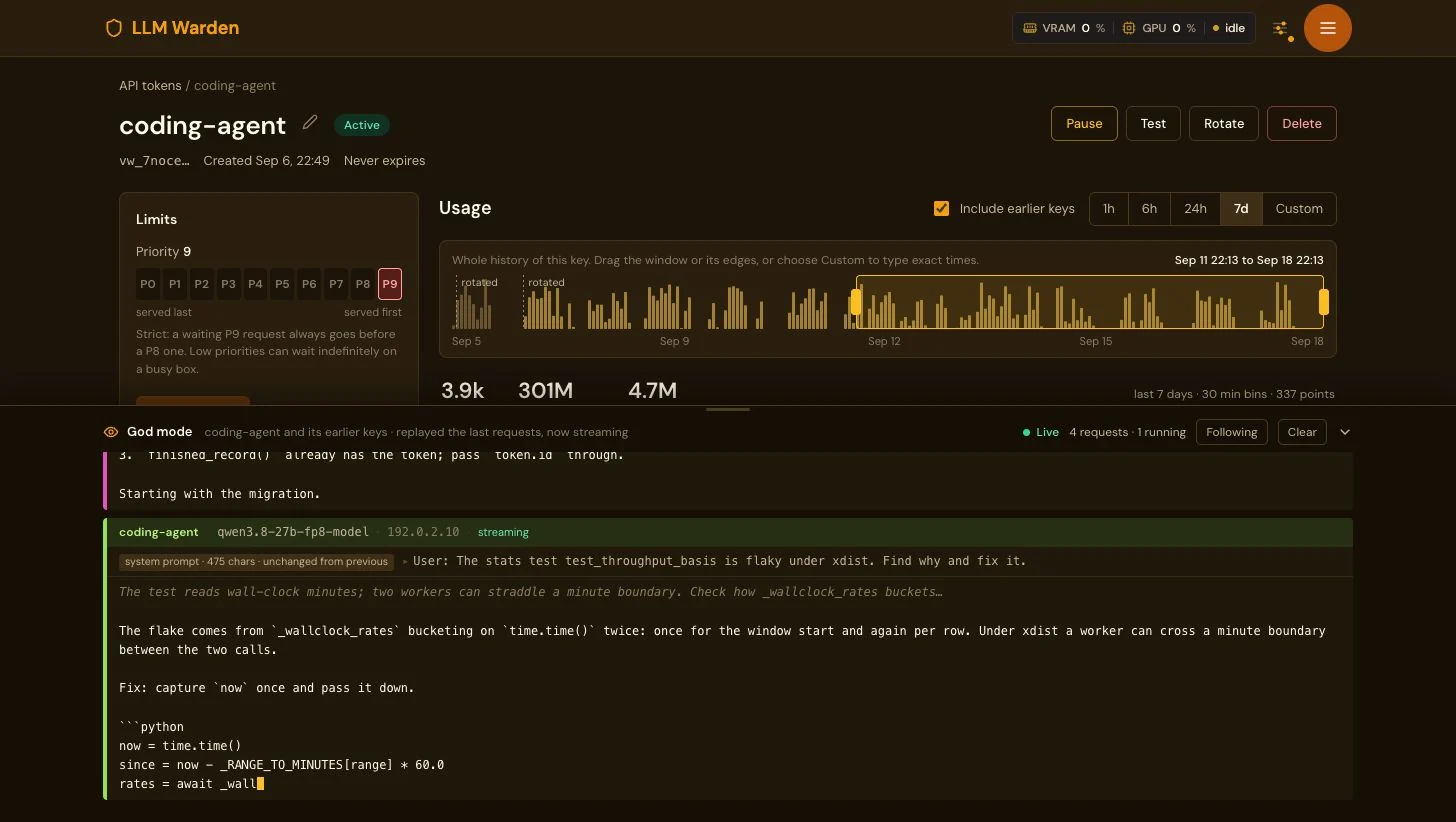
    God mode はプロンプトのデバッグ用です。デプロイで VW_GODMODE_ENABLED を有効にすると、各キーのページに、そのキーのプロンプトと生成結果をライブでストリーミングするドックが表示されます。既定ではオフで、オフのときはドック自体が表示されません。上限付きのメモリ内リング バッファーで、データベースやディスクには何も書き込まず、再起動で消えます。管理者セッションを持つ人なら誰でも開けます。warden には管理者ロールが一つあるだけで、ほかのロールはありません。

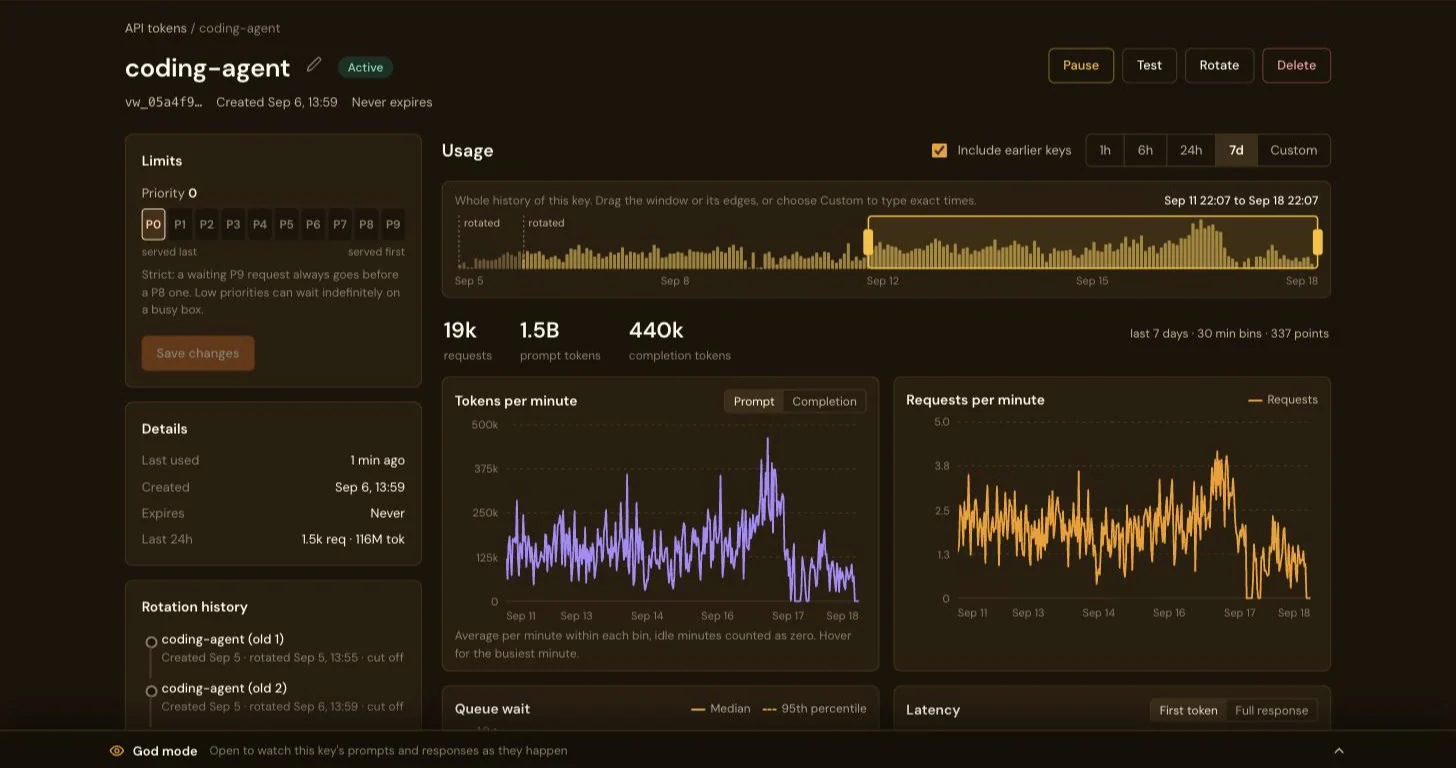
    API キー coding-agent のページで、下部に God mode のドックが開いている:Live、4 リクエスト、1 件実行中。192.0.2.10 からの qwen3.8-27b-fp8 リクエストがストリーミング中で、不安定な stats テストについてのユーザー プロンプトと、書き出されつつある Python の修正を含むモデルの応答が表示されている

エージェントはターンごとに会話全体を読み直します。

エージェントはターンごとに履歴全体を送り直すため、長い会話の大部分はエンジンがすでに読んだプレフィックスです。vLLM はその処理結果をプレフィックス キャッシュに保持しますが、キャッシュが残るのは処理を行ったレプリカだけです。一方、vLLM 自身のバランサーは各ターンをキューが最も短いレプリカに送ります。LM Warden は、新しい会話を最も負荷の低いレプリカに置き、そこに留めます。使うのは Claude Code がすでに送っているセッション ID です。リクエストを移すのは、そのレプリカがスピルしきい値を超えたときだけです。

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
四レプリカのモデルでの一つの会話の四ターン。vLLM のバランサーでは、各ターンが受け取ったレプリカでほぼ最初からプリフィル (プロンプトをキャッシュに読み込むこと) されます。LM Warden では会話がレプリカ 2 に留まり、新しいターンだけがプリフィルされます。仕組みの図であり、測定結果ではありません。

四枚のカードを積んだ自社マシンでの実測 (4 × RTX A4000、Qwen3-4B を一枚ずつ四つのレプリカとして、Claude Code 風の合成セッション、アフィニティをオフ、続けてオンで連続実行):会話を固定すると、同時 4 セッションでキャッシュから提供されたプロンプト トークンの割合は 56 から 86% に上がり、最初のバイトまでの時間の中央値は 2.05 から 0.38 s に下がりました。毎分の出力トークン数は実行したすべての段階で多く、p95 の最初のバイトまでの時間 (最も遅い 5%) もすべての段階で短くなりました。処理を行っているレプリカ数はほとんど変わりませんでした (4 セッションで四つのうち 2.71 対 2.83)。効果はキャッシュの再利用によるもので、働くカードが増えたからではありません。

Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
各段階のプレフィックス キャッシュ ヒット率:キャッシュから提供されたプロンプト トークン数を要求されたプロンプト トークン数で割ったもの。四つのレプリカすべてを合算し、その段階での vLLM 自身のカウンターの変化から算出。効果は余裕があるうちは続き、会話がスピルする 32 セッションでは消えます。
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
同時 4~32 セッションでの最初のバイトまでの時間 (中央値と p95)。一秒未満の段階と一分近い段階を並べて読めるよう対数目盛です。アフィニティありでは 16 セッションまで中央値がはるかに低く (4 セッションで 0.38 対 2.05 s)、24 と 32 では高くなります。p95 はすべての段階で低いものの、16 での差 (24.9 対 26.2 s) は各条件一回ずつの実行のノイズの範囲内です。クライアント側で、インターネット経由、最初にストリーミングされたトークンまでを測定。

負荷を上げていく各段階、アフィニティ オフ → オン

SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

四枚のカードを積んだ自社マシンで小さなモデルを使い、アフィニティをまずオフ、次にオンにして、間で vLLM を再起動せずに測定しました。二回目はプレフィックス キャッシュが温まった状態で始まり、両方とも同じシードからプロンプトを生成しています。各段階は 3 分なので、完了するセッションは 9~31 にとどまり、セッションが一つ増減するだけで一時間あたりのセッション数が 20 動きます。毎分の出力トークン数のほうが安定した列です。モデル、カード、ワークロードによって結果は異なります。モデルのページにあるレプリカ カードで、自分の環境の同じカウンターを確認できます。

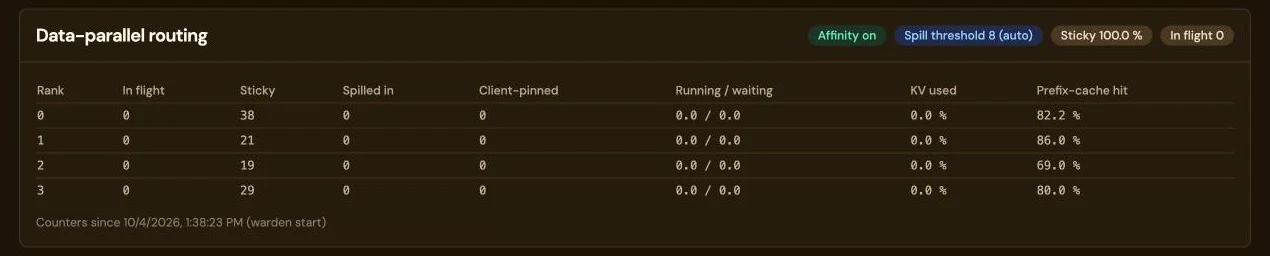
モデルのページにある Data-parallel routing カード。ラベルには Affinity on、Spill threshold 8 (auto)、Sticky 100.0%、In flight 0。表にはレプリカ 0~3 の実行中、スティッキー (38、21、19、29)、スピルによる受け入れ、クライアント固定、実行中と待機中、KV 使用量、プレフィックス キャッシュ ヒット率 (82.2、86.0、69.0、80.0%) が並び、カウンターは warden の起動時から集計されているという一行がある。
モデルのページにある同じカウンター:レプリカごとに一行で、保持しているリクエスト、留まった会話 (sticky) とスピルで来た会話の数、実行中と待機中の数、使用中の KV キャッシュ、プレフィックス キャッシュ ヒット率を表示します。2026 年 10 月 4 日、アフィニティ オン、スピルしきい値 8 (自動) で記録:sticky 100%、レプリカ 0~3 のプレフィックス キャッシュ ヒット率は 82.2、86.0、69.0、80.0%。画像はコンソールのカードそのもので、ベンチマーク結果ではありません。カードをタップすると拡大します。

不利になる場合。24 と 32 セッションの段階は、小さなカード四枚を意図的に過負荷にしたもので、すべてのレプリカが飽和しています。それでも出力は多く (毎分 11,178 対 9,048 トークン、16,638 対 14,760 トークン)、テール レイテンシもずっと短い (p95 38 対 59 s、39 対 83 s) のですが、最初のバイトまでの時間の中央値はアフィニティありのほうが悪化します:24 セッションで 13.1 対 5.1 s、32 セッションで 27.7 対 12.3 s。原因はまだ特定できておらず、スピルしきい値を 8 から 4 に下げても変わりませんでした。

忙しいマシンでは両方を測定してください。効果が最も大きいのは余裕があるときです。上限近くで動いているマシンでは両方の設定を測定してください。アフィニティはモデルごとにオフにできます。レプリカと、それを前提とするこのルーティングは、NVIDIA GPU を使う Linux インストールの機能です。Mac アプリ (ベータ版) にはテンソル並列もデータ並列もありません。

詳しい方法:ワークロード、テスト ハーネス、スピルしきい値、そしてそれ以来この設定で動いている GPU 七枚のマシン →

コーディング エージェントを自分の GPU で動かしましょう。

十種類のコーディング ツールが、ベース URL とキーだけで接続できます。そのうち二つは、難しい作業には有料の Claude サブスクリプションを引き続き使うこともできます。

Claude のサブスクリプションはそのまま、定型的な呼び出しを肩代わり

Claude Code と Anthropic SDK は、ルーター経由で。どの Claude モデルに GPU が応答するかをルールで指定し、それ以外はすべて自分のログインまたはキーで Anthropic に送られます。

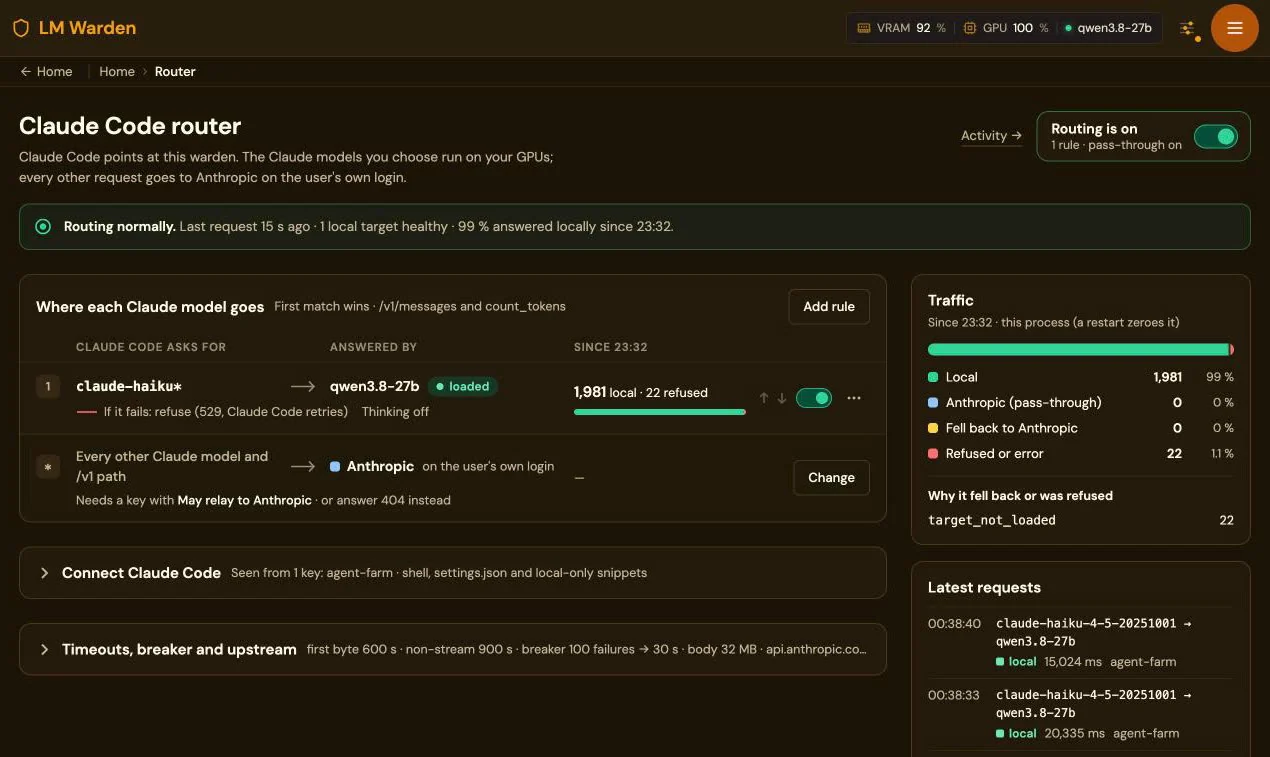
Claude Code のリクエストの行き先 エージェントはすべてのリクエストを LM Warden のルーターに送ります。claude-haiku モデル宛てのリクエストは GPU 上のモデルに送られ、そのモデルとして応答されます。Opus を含むそれ以外のモデルはすべて、自分のログインで Anthropic に渡されます。 Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* your GPUanswers as that model everything else,Opus included Anthropicon your own login Claude Code のリクエストの行き先 エージェントはすべてのリクエストを LM Warden のルーターに送ります。claude-haiku モデル宛てのリクエストは GPU 上のモデルに送られ、そのモデルとして応答されます。Opus を含むそれ以外のモデルはすべて、自分のログインで Anthropic に渡されます。 Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* everythingelse, Opusincluded your GPUanswers as that model Anthropicon your own login
1,981 件ローカルで応答したリクエスト。再起動以降、このマシンの Claude Code トラフィックの 99% にあたります。自社の GPU 七枚のマシンの Router ページより (2026 年 10 月 21 日)。ターゲットのモデルが読み込まれていない間に 22 件を拒否しました。
Claude Code ルーターのページ:ルーティングはオン、23:32 以降 99% をローカルで応答。ルール 1 は claude-haiku* を qwen3.8-27b に送り、ローカル 1,981 件、拒否 22 件。それ以外の Claude モデルはすべてユーザー自身のログインで Anthropic へ
Claude Code 2.1.227 以降:ANTHROPIC_BASE_URL を warden に向け、warden のキーを ANTHROPIC_CUSTOM_HEADERS に入れます。ログインはそのままです。回答の品質はベンチマークしていません。ローカル モデルには、定型的で仕様の明確な作業を任せてください。

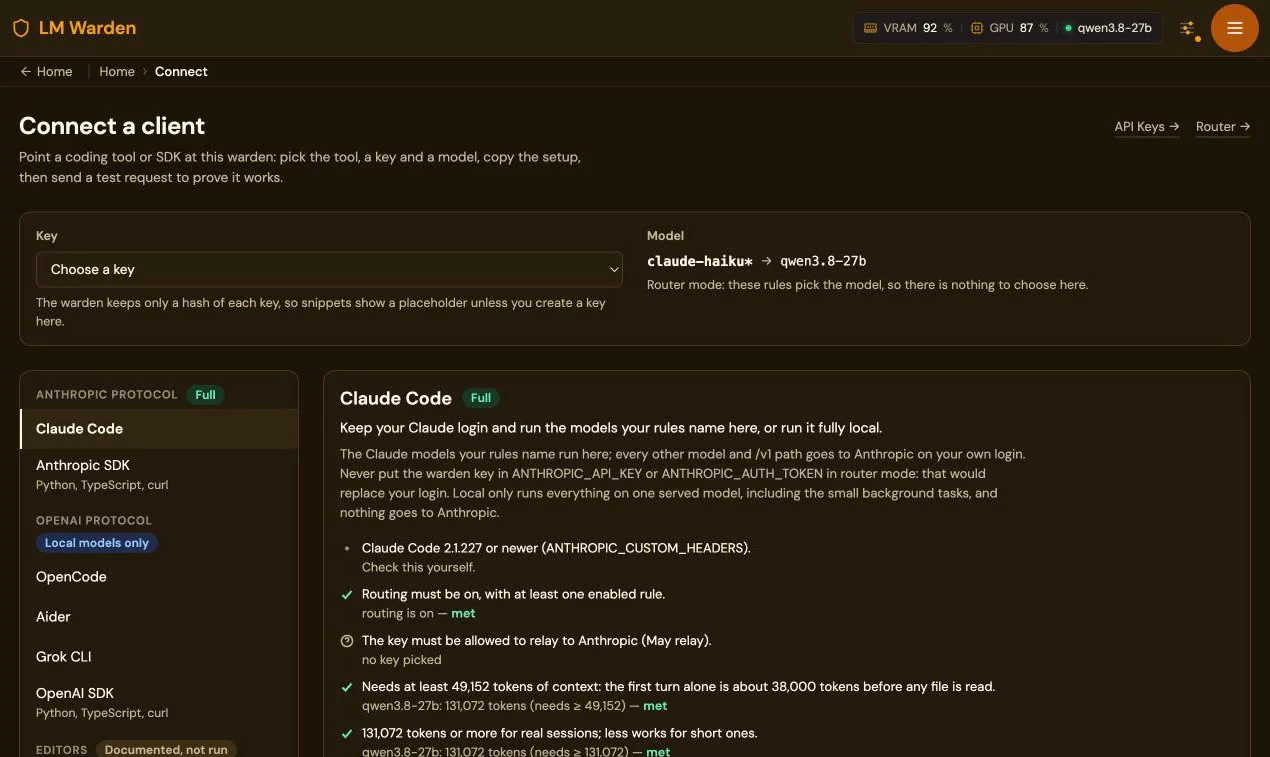
Connect が各クライアントの設定を書き出し、テスト リクエストを送ります。

コンソールでクライアント、キー、読み込み済みのモデルを選びます。実際に読み込まれているものに対して各要件 (コンテキスト ウィンドウ、ツール呼び出し、ルーターのオン) を確認し、貼り付けるだけの設定ファイルを用意します。すべてのコーディング エージェント:クライアントごとに専用ページで、何が動くか、何を確認したかを掲載しています。

Connect a client ページ:キーの選択、claude-haiku* を qwen3.8-27b に送るルーター ルール、プロトコル別にまとめたクライアント、要件を確認済みの Claude Code パネル

すでに料金を払っている AI に、自分の GPU をチューニングさせましょう。

カードに合うモデルを選ぶには、量子化、エンジン、GPU への分割方法、コンテキストの大きさ、KV キャッシュの型を選ぶ必要があり、推測するたびにダウンロードと読み込みが一回ずつかかります。コンソールの操作はすべて API 呼び出しなので、シェルを使える Claude Code、Codex などのエージェントが、自分のハードウェア上で自分のワークロードに対して、この探索を代わりに実行できます。

ループ

チューニング ループ GPU を調べ、ダウンロード前にフィット プレビューでモデルを絞り込み、候補のレイアウトを読み込み、実際のリクエストでベンチマークし、設定を調整し、最も良いものを読み込んだままにします。ベンチマークと調整は、エージェントが納得するまで繰り返されます。 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner チューニング ループ GPU を調べ、ダウンロード前にフィット プレビューでモデルを絞り込み、候補のレイアウトを読み込み、実際のリクエストでベンチマークし、設定を調整し、最も良いものを読み込んだままにします。ベンチマークと調整は、エージェントが納得するまで繰り返されます。 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner

エージェントが呼び出すもの:GET /api/system/gpus、ダウンロード前の POST /api/models/fit-preview、登録と suggest-config、pull と読み込み、実際のコンテキスト上限を見つけて適用するストレス テスト、GET /api/stats/v2/throughput と latency、そしてテスト トラフィックを送るために自ら発行する推論キー。最初に読むのは /agent-guide.md で、これらの呼び出しを言語モデル向けに簡潔に説明したものです。

Models ページでモデルを読み込み中:各ステップに経過時間と通常の所要時間
レイアウトの読み込み中にエージェントが見ているもの:各ステップに、過去の読み込みでの通常の所要時間。進まなくなった読み込みは停止され、GPU が解放されます。

貼り付けるプロンプト四つと、返ってくるもの

  1. 調査と絞り込み。依頼:GPU を一覧表示し、65,536 トークン以上のコンテキストで収まるエージェント型コーディング向けのオープン ウェイト モデルを三つに絞り込み、それぞれをフィット プレビューで確認する。何もダウンロードしない。得られるもの:モデル、量子化、エンジン、GPU、コンテキスト、選定理由の表。
  2. 一つのモデルのエンジンとレイアウト。依頼:自分のカードで vLLM と llama.cpp のどちらにするか、テンソル並列とデータ並列レプリカのどちらにするかを決める。上位二つのレイアウトを読み込み、それぞれに同じ 20 件のストリーミング リクエストを送り、同時実行数 1 と 8 で比較する。得られるもの:両方の最初のトークンまでの時間と毎秒トークン数。優れたほうは読み込んだまま、もう一方はアンロード、テスト キーは失効。
  3. 実際の限界を見つけて適用する。依頼:読み込んだモデルをストレス テストして測定したコンテキストを適用し、同時実行数 1、4、16 で、約 2k と 30k トークンのプロンプトを使ってベンチマークする。得られるもの:モデルの設定に書き込まれたコンテキスト上限と、同時実行数とプロンプト サイズごとの最初のトークンまでの時間と毎秒トークン数の表。
  4. 自分の作業で二つの候補を比較する。依頼:./workload/*.txt のプロンプトを同時実行数 4 でモデル A とモデル B に再送し、各回答を評価する。得られるもの:レイテンシ、毎秒トークン数、エージェントの判断による正確さ、推奨をまとめた model-comparison.md。推奨モデルは読み込まれたままになります。

始める前に。管理者トークンには warden に対する完全な管理者権限があります (モデル、キー、設定。より狭いスコープはまだありません)。有効期限を短くし、作業が終わったら Settings → Access Tokens で失効させてください。ストレス テストは限界を見つけるために意図的にエンジンをクラッシュさせます。これらのプロンプトは、ほかの誰も依存していない warden で実行してください。ダウンロード サイズは大きくなります。プロンプトは pull の前にフィットを確認しますが、ディスク容量には注意してください。

エンジンとレイアウトの選択 (vLLM、テンソル並列またはデータ並列) は Linux インストールの機能です。Mac では、一つの GPU 上の MLX か llama.cpp かを選びます。チューニングを行うモデルはすでに料金を払っているものなら何でもよく、チューニングされるのはカード上のモデルです。エージェント チューニングのページ:四つのプロンプトの全文。

一台の GPU マシンを、チーム全員、家族、エージェントで共有。

API キーを必要なだけ作成して配りましょう。同僚、家族、CI ジョブ、エージェント群、それぞれに専用のキー、優先度、使用量ページがあります。ハードウェアは全員のために働き、重要な作業が待たされることはありません。

ハードウェアの実態をそのまま表示:Mac から B300 八基まで。

同じコンソールで、16 GB の M1 も、手元にある型番の違う二枚のカードも、8 × B300 の NVSwitch サーバーも読み取り、ボトルネックを平均値に埋もれさせずに具体的に示します。たとえば、x16 のうち x4 でしかリンクしていない PCIe、非アクティブな NVLink リンク、カード間で異なる ECC です。

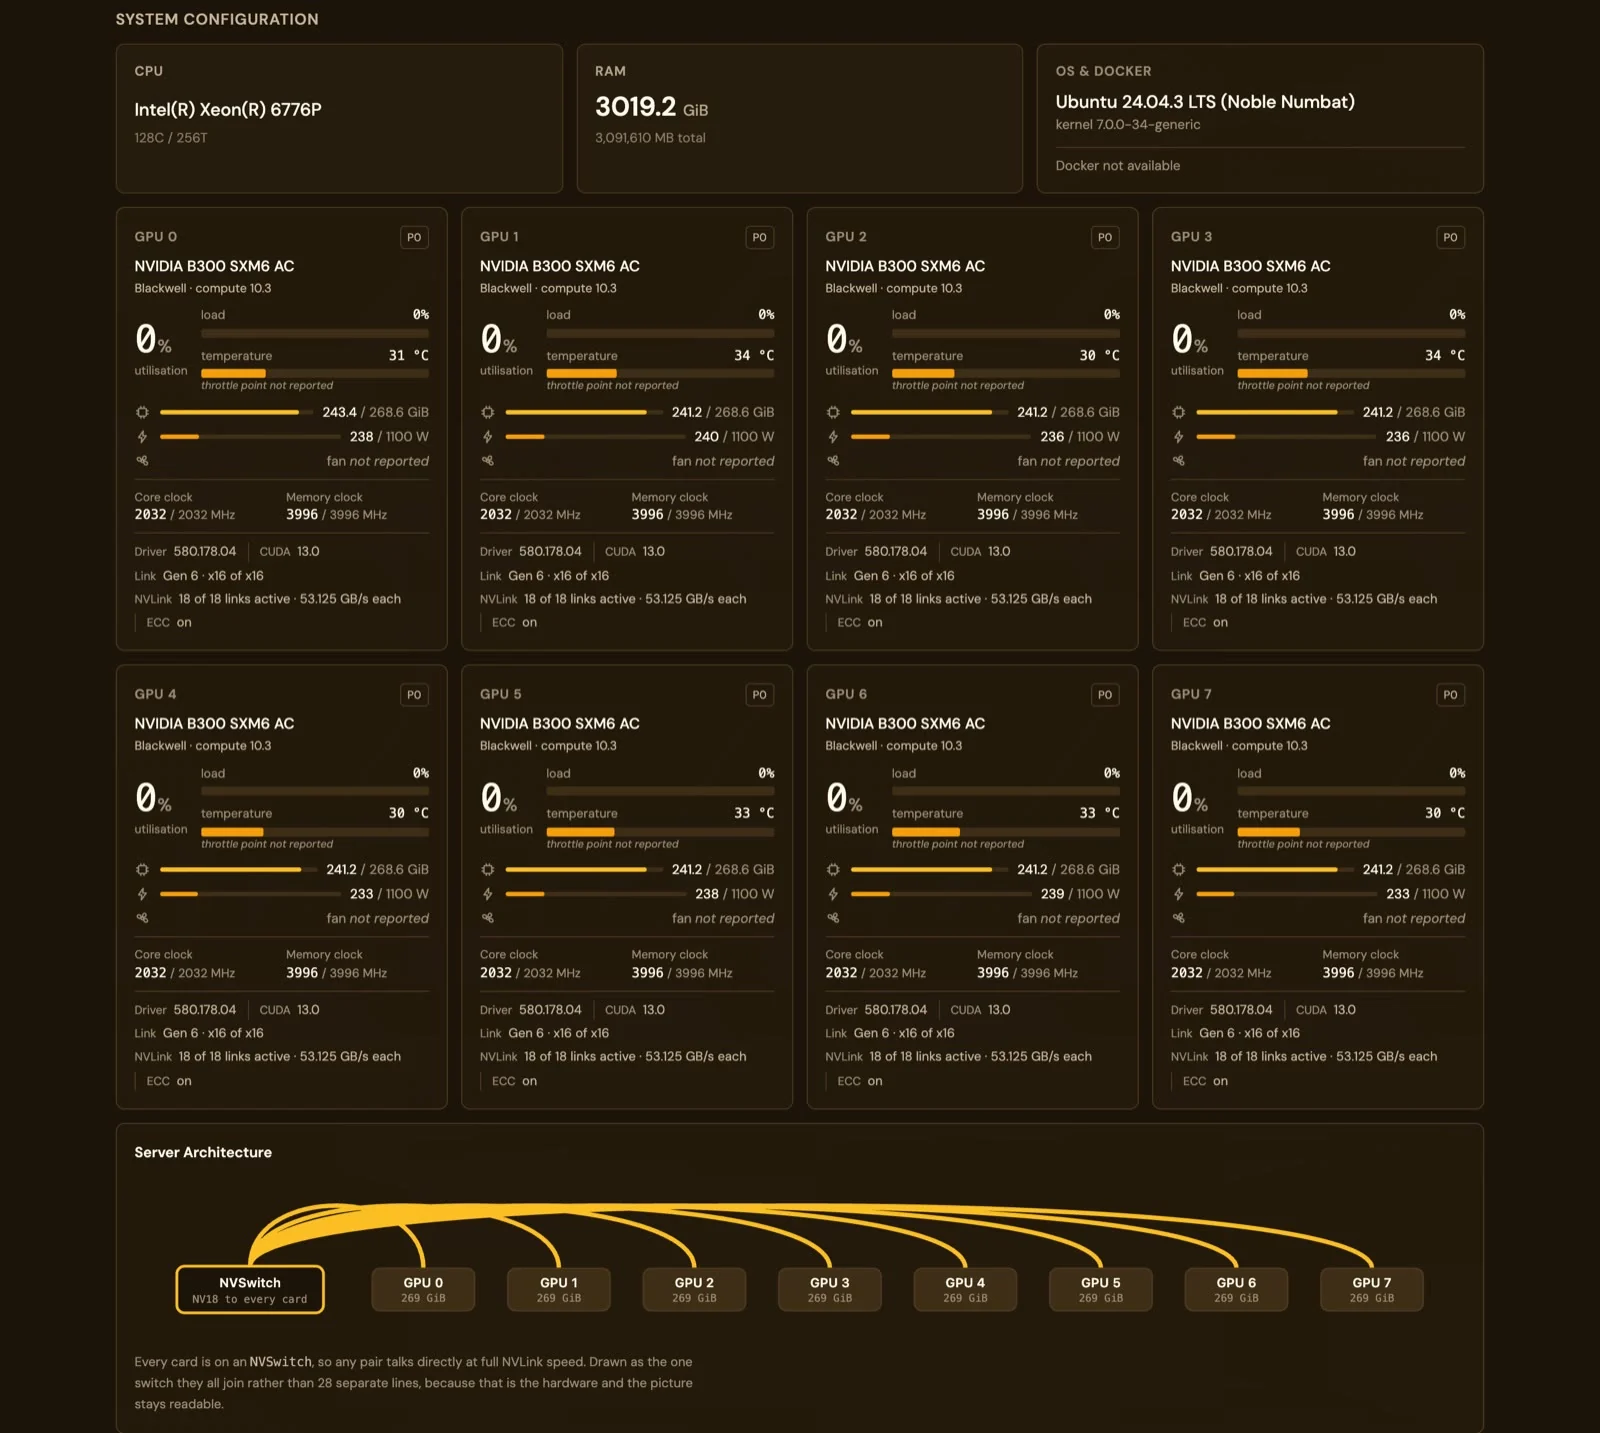
8 × B300 サーバーのシステム構成:Intel Xeon 6776P、3019 GiB の RAM、NVIDIA B300 SXM6 のパネル八つ (それぞれ 268.6 GiB 中 241 を使用)、Link Gen 6 x16 of x16、NVLink は 18 本中 18 本がアクティブで各 53.125 GB/s、ECC オン、一つの NVSwitch が全カードにつながるサーバー構成図
一つの NVSwitch 上の B300 SXM6 八基:カードごとに NVLink 18 本中 18 本がアクティブ、ECC オン、PCIe Gen 6 x16、テンソル並列 8 で GLM-5.2 NVFP4 を提供中にカードごとに 268.6 GiB 中 241 を使用。
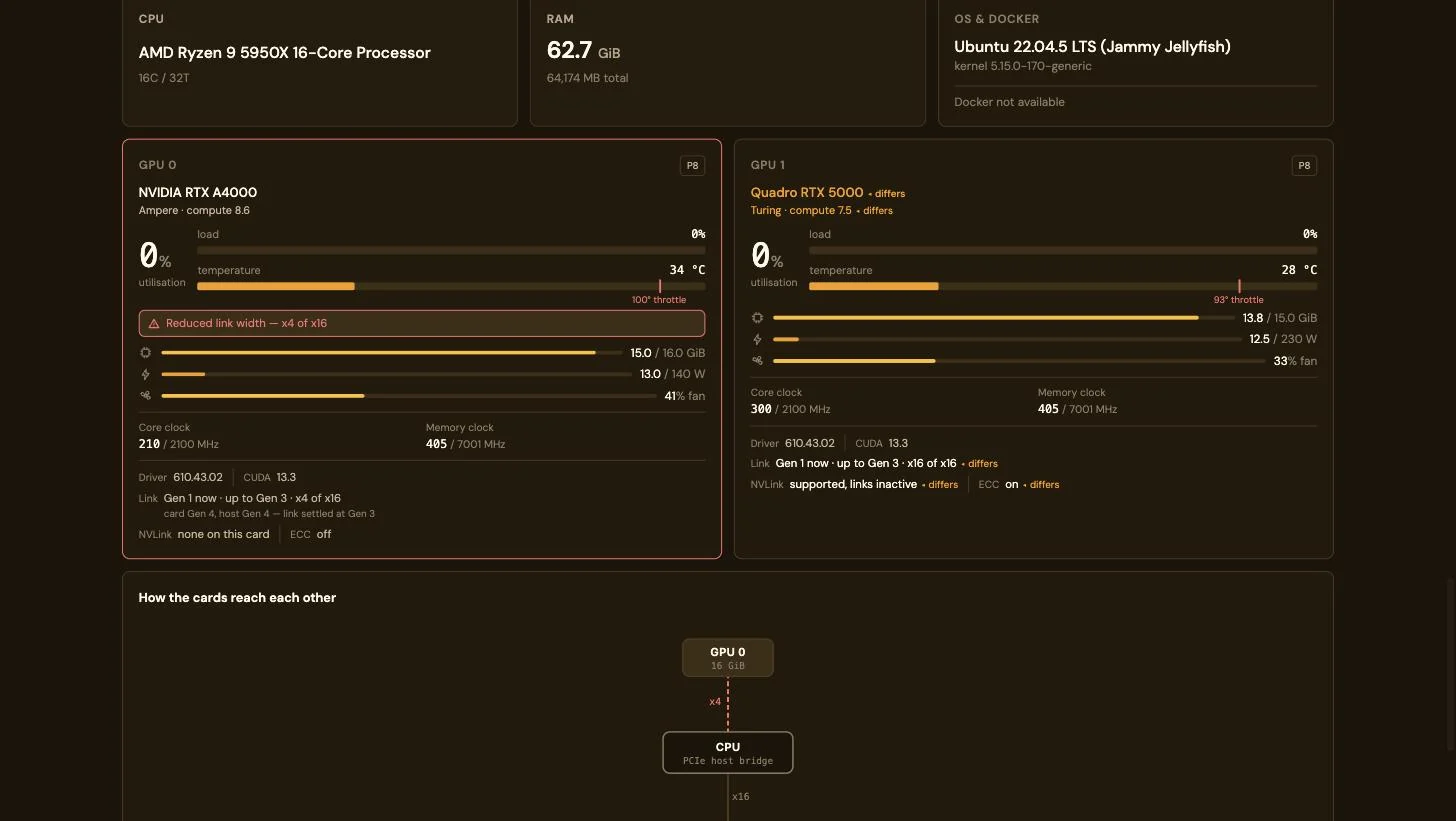
型番の違う二つの GPU:赤い Reduced link width x4 of x16 警告と、現在 Link Gen 1 (最大 Gen 3) を示す NVIDIA RTX A4000。その隣に、アーキテクチャ、VRAM、電力上限、リンク、NVLink、ECC がそれぞれ differs と表示された Quadro RTX 5000。下には、カードが x4 と x16 のリンクで CPU につながる様子の図
購入時期が何年も違う二枚のカード:A4000 のリンクは x16 のうち x4 で確立しており、赤で警告されています。Quadro のアーキテクチャ、電力上限、NVLink (対応、リンクは非アクティブ)、ECC にはそれぞれ differs と表示されています。図を見ると、どのスロットの帯域が狭いかがわかります。
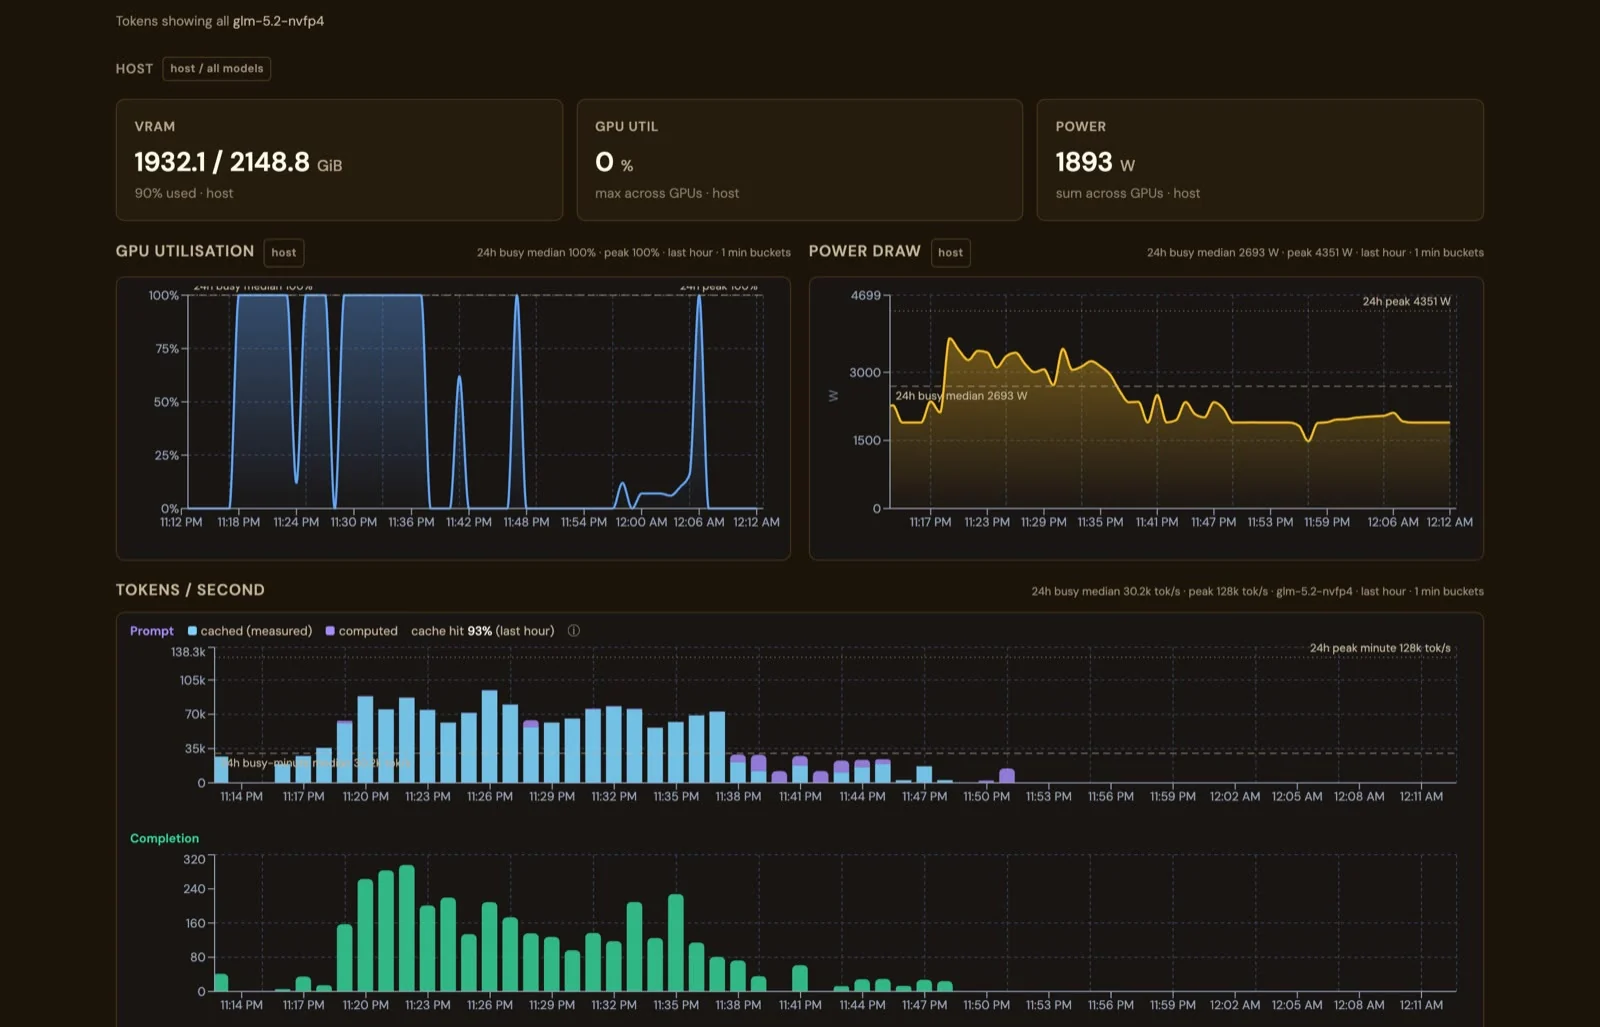
8 × B300 サーバーの Stats:VRAM 2148.8 GiB 中 1932.1、全カード合計の電力 1893 W、過去一時間の GPU 使用率と消費電力、キャッシュ済みと計算分に分けた毎秒プロンプト トークン数とキャッシュ ヒット 93%
同じ Stats ページを最上位の構成で:VRAM 2,149 GiB 中 1,932、全カードで 1,893 W、その一時間のピークは 4,351 W、プロンプト トークンの 93% がキャッシュから。
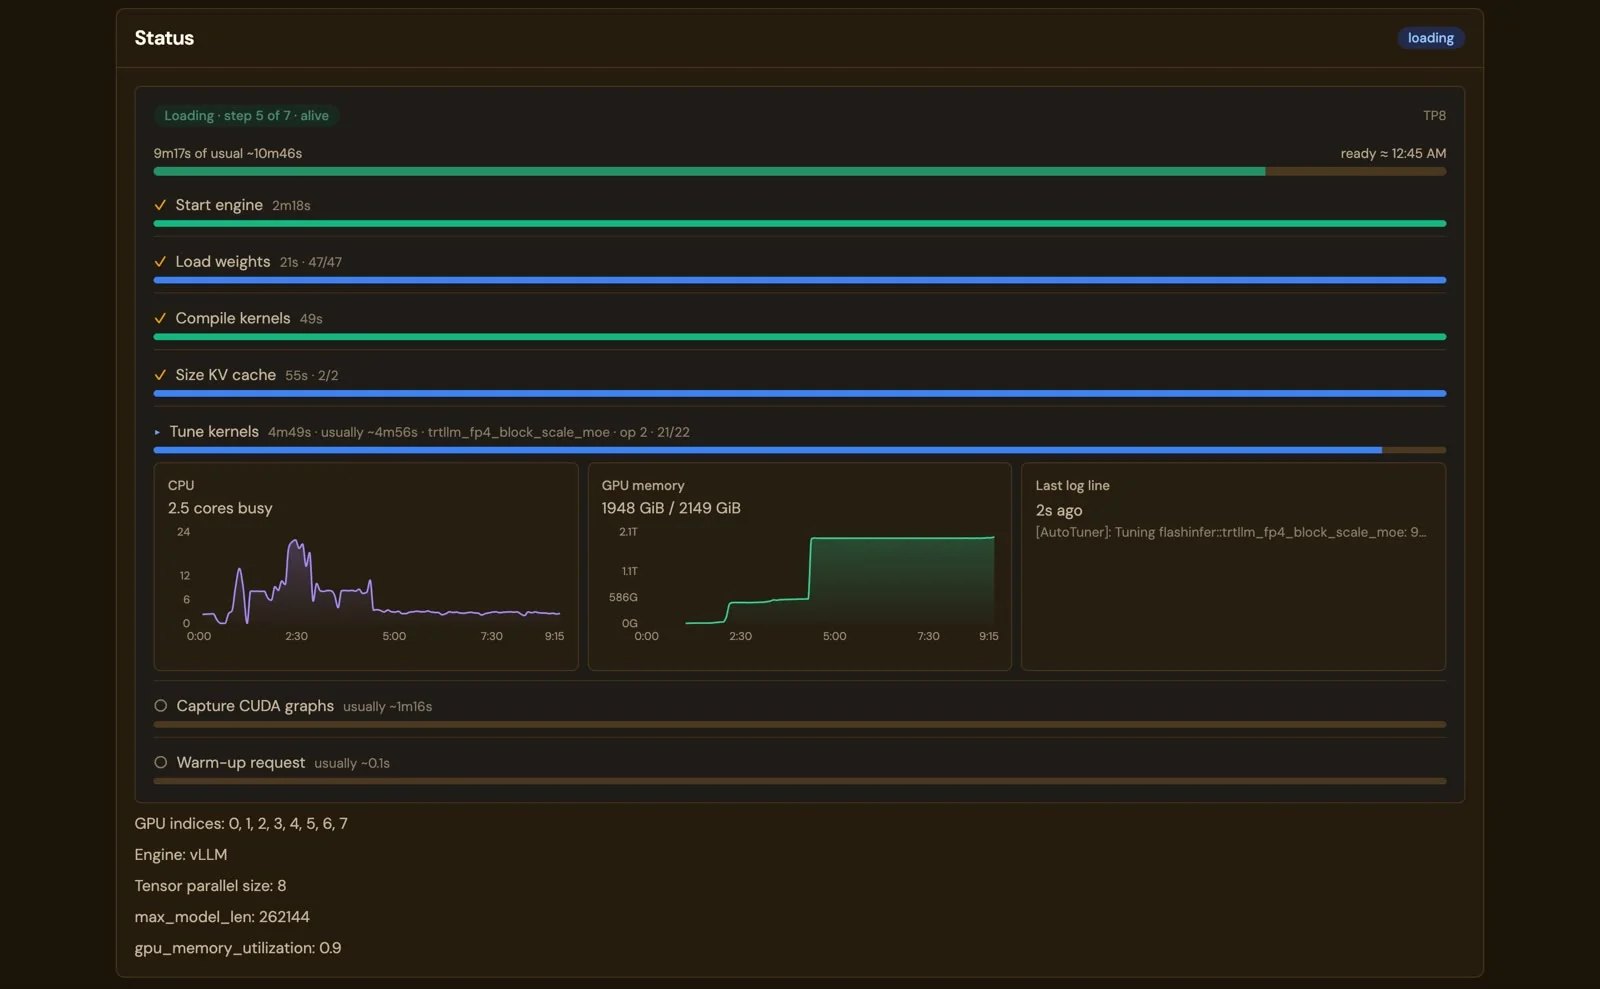
B300 八基で GLM-5.2 NVFP4 を読み込み中のモデル ページ:通常 10 min 46 s のうち 9 min 17 s 経過。Start engine、Load weights 47 of 47、Compile kernels、Size KV cache は完了、Tune kernels は 22 中 21 の操作。CPU と GPU メモリのグラフと最後のログ行
10 分の読み込みをステップごとに:B300 八基で GLM-5.2 NVFP4、通常 10 min 46 s のうち 9 min 17 s 経過。進んでいる間は何も赤くなりません。

各パネルにカードごとに表示されるもの:そのカード自身のスロットリング ポイントに対する温度、上限に対する電力、クロック、ファン、現時点でネゴシエートされた PCIe の世代と幅、カードが備えていれば ECC と NVLink、メモリを確保しているプロセス。相互接続の図は nvidia-smi topo -m から読み取ります。Mac では、GPU 使用率と Metal が報告するメモリ上限を表示します (電力は表示されません)。さらに、これらすべての土台となるエンジンは、プロセス テーブルではなくエンジン自身の /health で監視されます。ラッパーが動いていてもエンジンが停止している場合は、原因を調べるための情報を残したまま再読み込みされます。

表示される内容

GPU 監視

カードごとに、それぞれの状態を表示します。

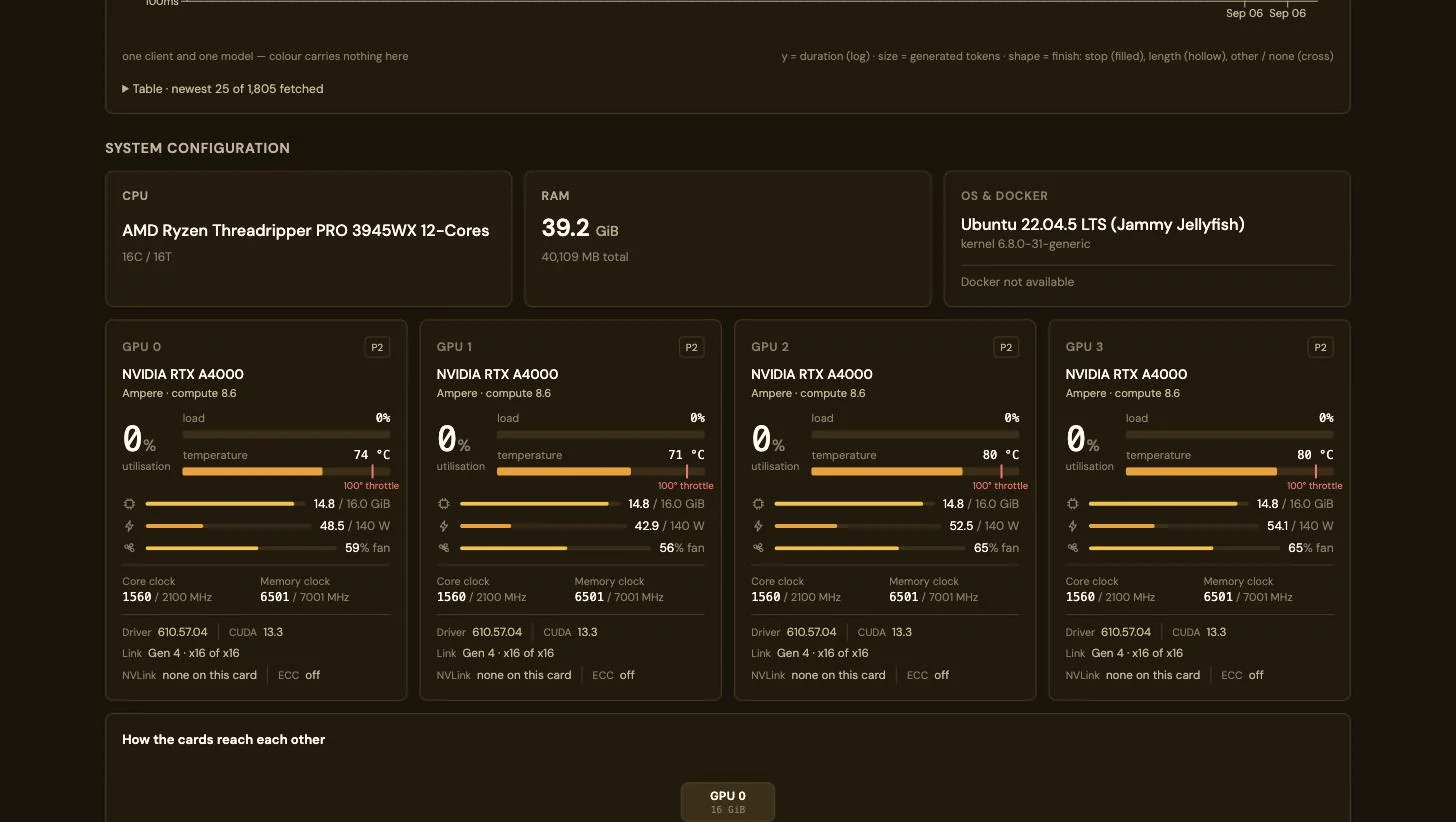
使用率、そのカード自身のスロットリング ポイントに対する温度、上限に対する電力、VRAM、クロック、PCIe リンク、メモリを確保しているプロセス。マシン全体の平均ではありません。

システム構成と、NVIDIA RTX A4000 カード四枚の GPU パネル。カードごとの使用率、温度、VRAM、電力、ファン、クロック

処理中のリクエスト

各エージェントが今何をしているかがわかります。

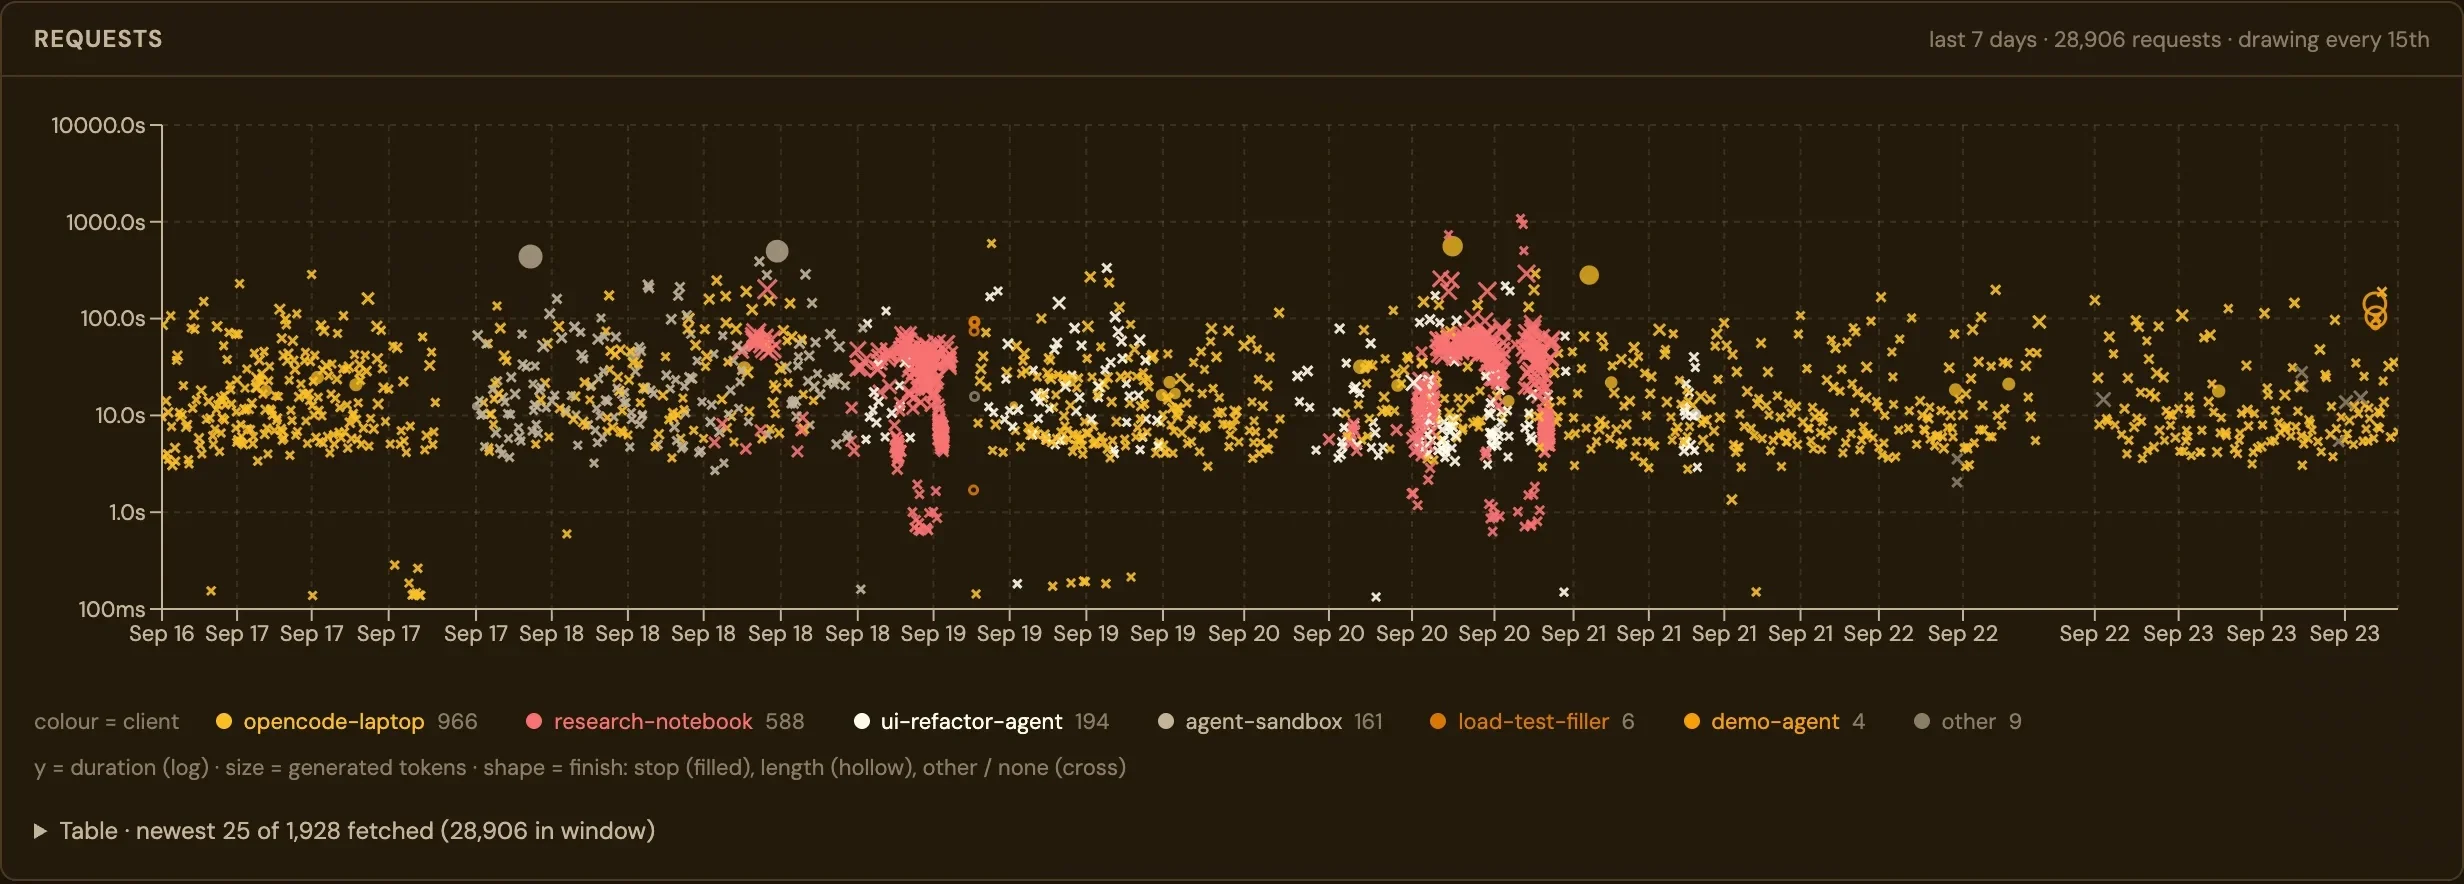
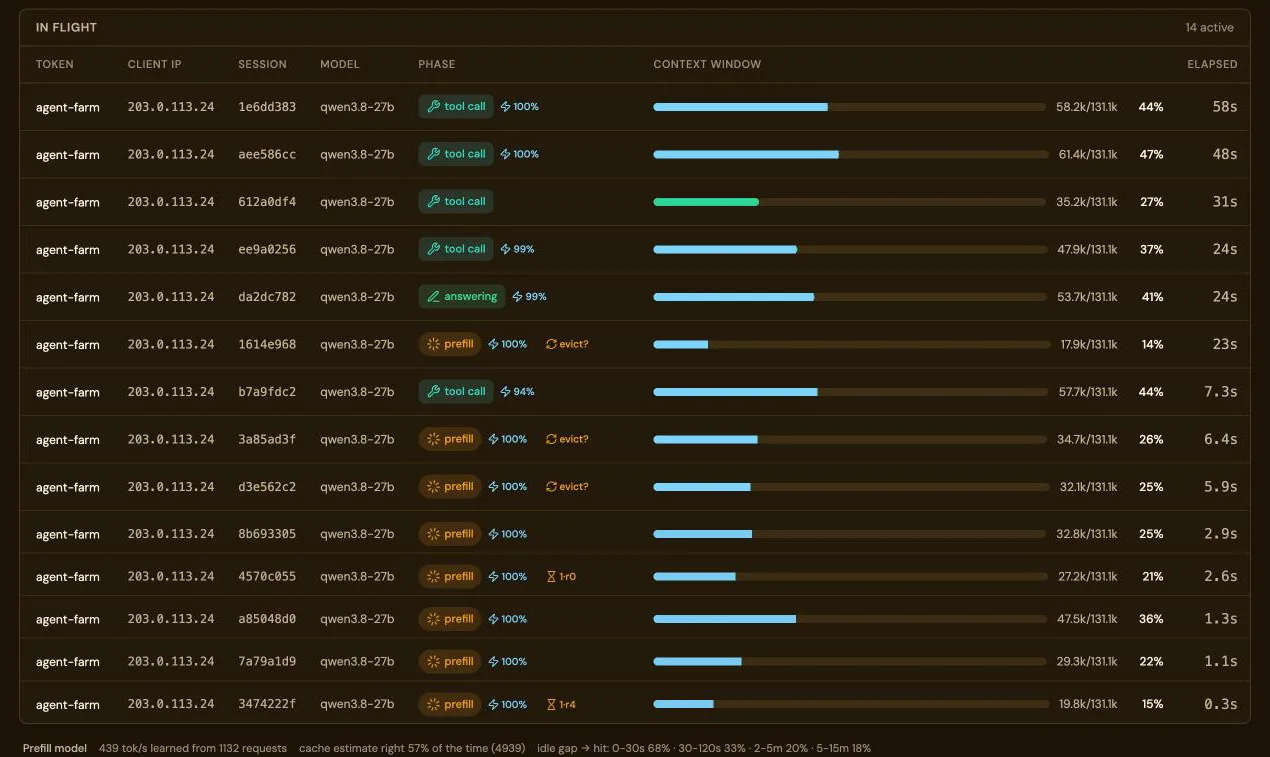
すべてのリクエストとそのキー、セッション、フェーズ (キュー待ち、プリフィル、思考中、ツール呼び出し、応答中)。各プロンプトのうちどれだけがプレフィックス キャッシュから来たかを、リクエストごとに測定します。

処理中のリクエストの表:十件のアクティブなリクエストと、それぞれのキー、セッション、フェーズ、トークン

コーディング エージェント

Claude Code、Codex、OpenCode を一つのページから接続。

Connect は、この warden のアドレス、キー、読み込み済みのモデルで各ツールの設定を書き出し、実際に読み込まれているものに対して要件を確認し、テスト リクエストを送ります。

Claude Code を選択し、要件を確認済みの Connect a client ページ

無料のオープンソースで、開発も公開の場で。

LM Warden は GitHub で公開されている Apache-2.0 のソフトウェアです。インストール スクリプトと Compose ファイルがデプロイのすべてで、どちらも読むことができます。アカウント不要、ライセンス チェックなし、テレメトリなし。vLLM、llama.cpp、MLX は、改変せずに実行しているアップストリームのプロジェクトです。

mlx-rust-lm 近日公開

Apple の mlx-lm を Apple 公式の mlx-c バインディング上で Python から Rust に移植したもので、LM Warden チームが独立したオープンソース プロジェクトとして開発・保守しています。LM Warden は三つ目の Mac エンジンとしてこれを使い、いずれは現在の Mac ダウンロードの大半を占める Python 版 mlx-lm エンジンを置き換えます。非公式であり、Apple とは提携していません。